
কাঁচা ডেটা, তৈরি টেবিলের বদলে
মডেলগুলো 점점 더 কোড এজেন্টের ভূমিকায় কাজ করছে: তাদের ডেটা প্রসেসিংয়ের স্ক্রিপ্ট লেখা, গ্রাফ তৈরি, মেট্রিক গণনা, ইঞ্জিনিয়ারিং ডেটা বিশ্লেষণের দায়িত্ব দেওয়া হয়। কিন্তু এমন এক শ্রেণির কাজ আছে যা এখনও প্রায় পরীক্ষা করা হয়নি — ভৌত স্তরের "কাঁচামাল" নিয়ে কাজ করা। ঠিক এই শূন্যস্থানই পূরণ করে EMRB (Electromagnetic Reasoning Benchmark) বেঞ্চমার্ক, যা arXiv:2608.24086 প্রিপ্রিন্টে (cs.AI, cs.CE, cs.SE বিভাগ) বর্ণিত হয়েছে।
মূল ধারণাটি সরল, তাই убедительнымও। ইনপুটে শুধু কাঁচা I/Q রেকর্ডিং, অর্থাৎ কোয়াড্রেচার স্যাম্পল, যেমন রিসিভার থেকে আসে। কোনো পূর্ব-প্রক্রিয়াজাত ফিচার নেই, লেবেলযুক্ত স্পেকট্রোগ্রাম নেই, আর অবশ্যই তৈরি মানের টেবিল নেই। প্রশ্ন যে রাশিকে নিয়ে, মডেলকে প্রথমে তা ডেটার মধ্যে খুঁজে বের করতে হবে — নিজে লেখা ও চালানো কোডের মাধ্যমে।
সাধারণ পরিমাপ থেকে এটি কীভাবে আলাদা
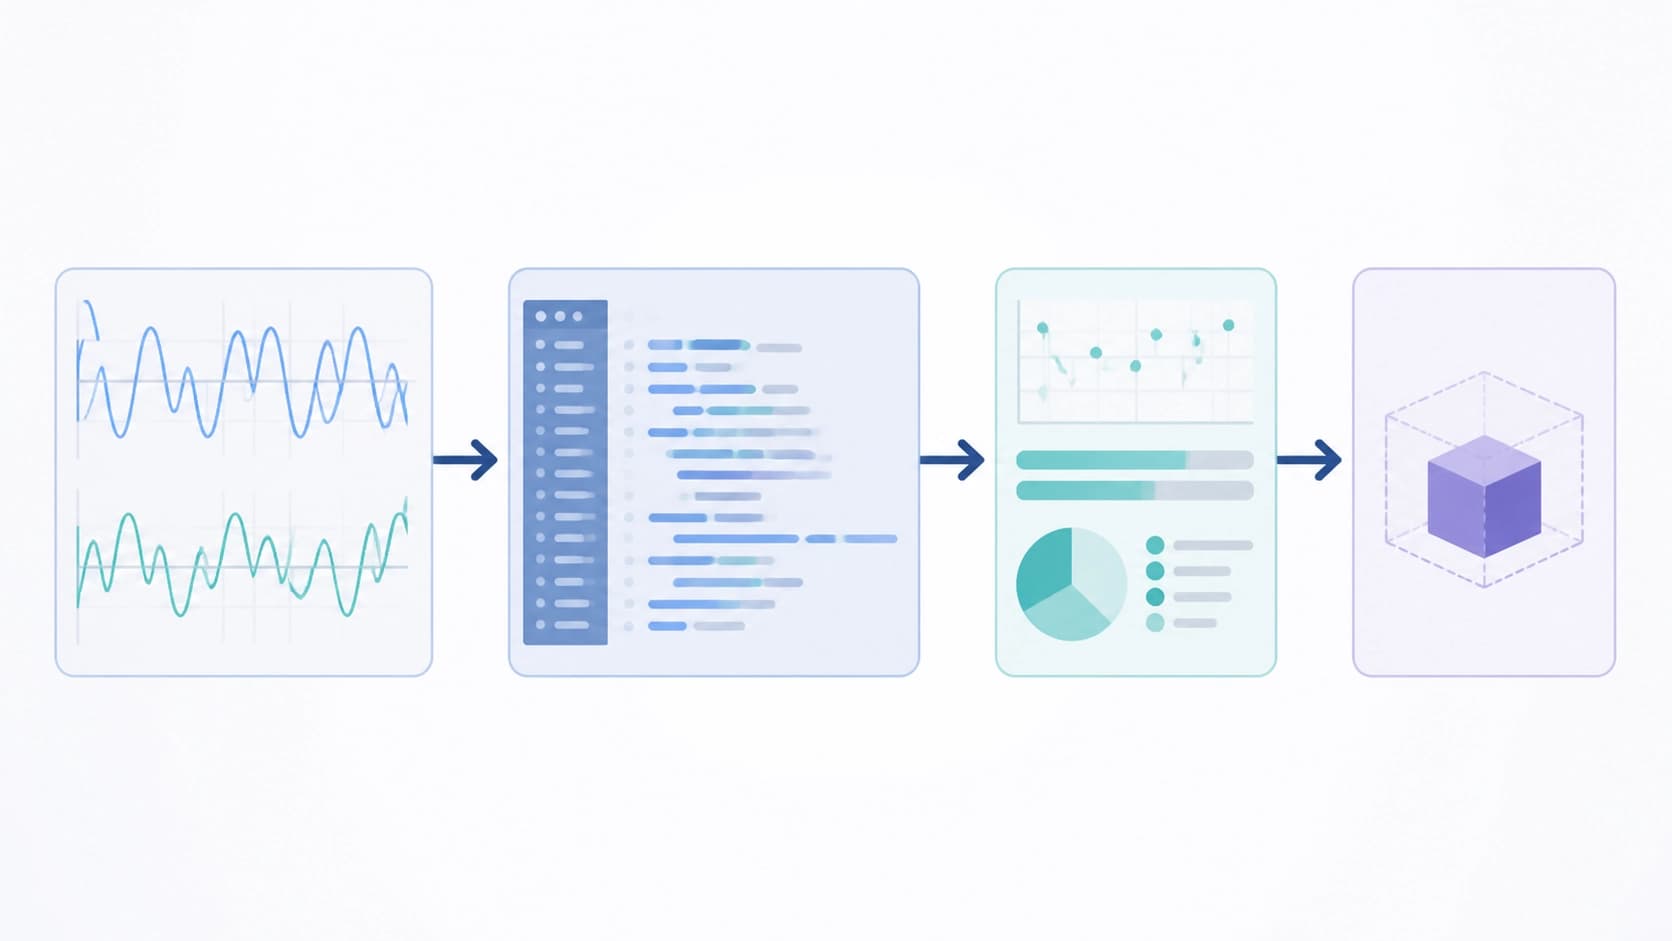
গত কয়েক বছরে অনেক টাস্ক সেট এসেছে যেখানে মডেলদের রেডিও সিগন্যাল নিয়ে যুক্তি করার প্রস্তাব দেওয়া হয়। কিন্তু বেশিরভাগ ক্ষেত্রেই মডেলের হয়ে কাজটি আগেই করা থাকে: রেকর্ডিং থেকে ফিচার বের করা, স্পেকট্রাম গণনা, নয়েজ লেভেল অনুমান, সবকিছু একটি কাঠামোবদ্ধ টেবিলে সাজানো। এমন বিন্যাসে শুধু পাটিগণিত ও সংখ্যা মেলানো বাকি থাকে — দক্ষতা দরকারি, কিন্তু রেডিওফিজিক্সের সঙ্গে সম্পর্কহীন।
পার্থক্যটি মৌলিক। যখন রাশিগুলো আগেই দেওয়া থাকে, প্রাথমিক ধাপে মডেলের ভুল চোখে পড়ে না: ব্যান্ডউইথ বা ফ্রিকোয়েন্সির ভুল অনুমান হয়ই না, কারণ এই মানগুলো শর্তে দেওয়া আছে। কিন্তু ডেটা যখন অপরিশোধিত, সিগন্যাল রেকনেসান্সের ধাপে যেকোনো ভুল পরবর্তী পুরো গণনাকে টেনে নিয়ে যায়। তাই EMRB পরিভাষার জ্ঞান নয়, বরং একটি শৃঙ্খল গড়ার সক্ষমতা পরীক্ষা করে: স্যাম্পলগুলোর দিকে তাকানো, বোঝা যে সেখানে কী সিগন্যাল আছে, প্রয়োজনীয় বৈশিষ্ট্য আলাদা করা, তা সঠিকভাবে গণনা করা এবং মাত্রা হারিয়ে না ফেলা।
বেঞ্চমার্কটি কীভাবে সাজানো
লেখকরা — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang এবং Shan Huang — ২০০টি কাজ সংকলন করেছেন। কাজগুলো পাঁচটি কঠিনতার স্তর এবং ২৭টি প্রশ্নের ধরনে সাজানো: সিগন্যাল শনাক্তকরণ থেকে শুরু করে OFDM সিস্টেম ডিজাইন পর্যন্ত। উপাদানের উৎস ১১ ধরনের সিগন্যাল, প্রতিটির জন্য যাচাইকৃত রেফারেন্স গ্রাউন্ড ট্রুথ প্রস্তুত করা হয়েছে।
পাঁচটি স্তর
স্তরগুলো মডেলের স্বাধীনতার ক্রমবর্ধমান ক্রমে সাজানো। নিচে — মৌলিক প্যারামিটার পরিমাপ: সিগন্যাল খুঁজে বের করা, তার বৈশিষ্ট্য অনুমান করা। উপরে — ব্যাখ্যা ও তুলনা, তারপর বহু-ধাপ বিশ্লেষণ, তারপর ডায়াগনস্টিকস এবং সবশেষে সিস্টেম ডিজাইন, যেখানে মডেলকে পরিমাপ করতে নয়, বরং নির্দিষ্ট চাহিদা অনুযায়ী সমাধান ডিজাইন করতে হয়।
২৭ ধরনের প্রশ্ন ও ১১ ধরনের সিগন্যাল
এমন বৈচিত্র্য দরকার যাতে ফলাফল একটি সফল বা ব্যর্থ বাক্যগঠনের উপর নির্ভর না করে। ভিন্ন ধরনের সিগন্যাল ভিন্ন ফাঁদ তৈরি করে: কোথাও নয়েজ বাধা দেয়, কোথাও — স্পেকট্রামে ওভারল্যাপ, কোথাও স্যাম্পলিং নিয়ে সতর্কভাবে কাজ করা দরকার। প্রশ্ন ও সিগন্যালের ধরনের সংখ্যা মিলে এমন একটি ক্ষেত্র তৈরি করে যেখানে আকস্মিকভাবে অনুমান করা কঠিন।
উন্মুক্ত ডেটা
সব উপাদান ও কোড একটি পাবলিক GitHub রিপোজিটরিতে রাখা হয়েছে, তাই ফলাফল স্বাধীনভাবে পুনরায় যাচাই করা যায়। বেঞ্চমার্কের জন্য এটি সাধারণের চেয়ে বেশি গুরুত্বপূর্ণ: যদি কাজগুলো মাঠের রেকর্ডিং থেকে হাতে সংকলিত না হয়ে জেনারেট করা হয়, তবে রেফারেন্সের সঠিকতার প্রশ্নটি কেন্দ্রীয় হয়ে ওঠে — এবং এখানে উন্মুক্ততাই একমাত্র কার্যকর উত্তর।
মডেলগুলো কী দেখাল
১৪টি ভাষা মডেল পরীক্ষা করা হয়েছে: মালিকানাধীন, ওপেন-ওয়েট এবং আলাদাভাবে যুক্তি-কেন্দ্রিক মডেল। চূড়ান্ত বিস্তার — ২৪.১% থেকে ৭৮.৯%। এই পরিসরই অনেক কিছু বলে: সেরা ও সবচেয়ে খারাপ মডেলের মধ্যে পার্থক্য এখানে শতাংশে নয়, গুণে মাপা হয়।
কিন্তু আরও আকর্ষণীয় অন্য কিছু। স্তর জটিল হওয়ার সঙ্গে সঙ্গে গড় ফলাফল তীব্রভাবে কমে: মৌলিক পরিমাপে ৮৪.৯% থেকে সিস্টেম ডিজাইনে ২১.২%। অর্থাৎ মডেলগুলো পরিমাপযোগ্য রাশি গণনা করতে গেলে বেশ ভালো করে, কিন্তু সেই রাশিগুলো থেকে একটি কার্যকর সমাধান গড়তে গেলে প্রায় ভেঙে পড়ে।
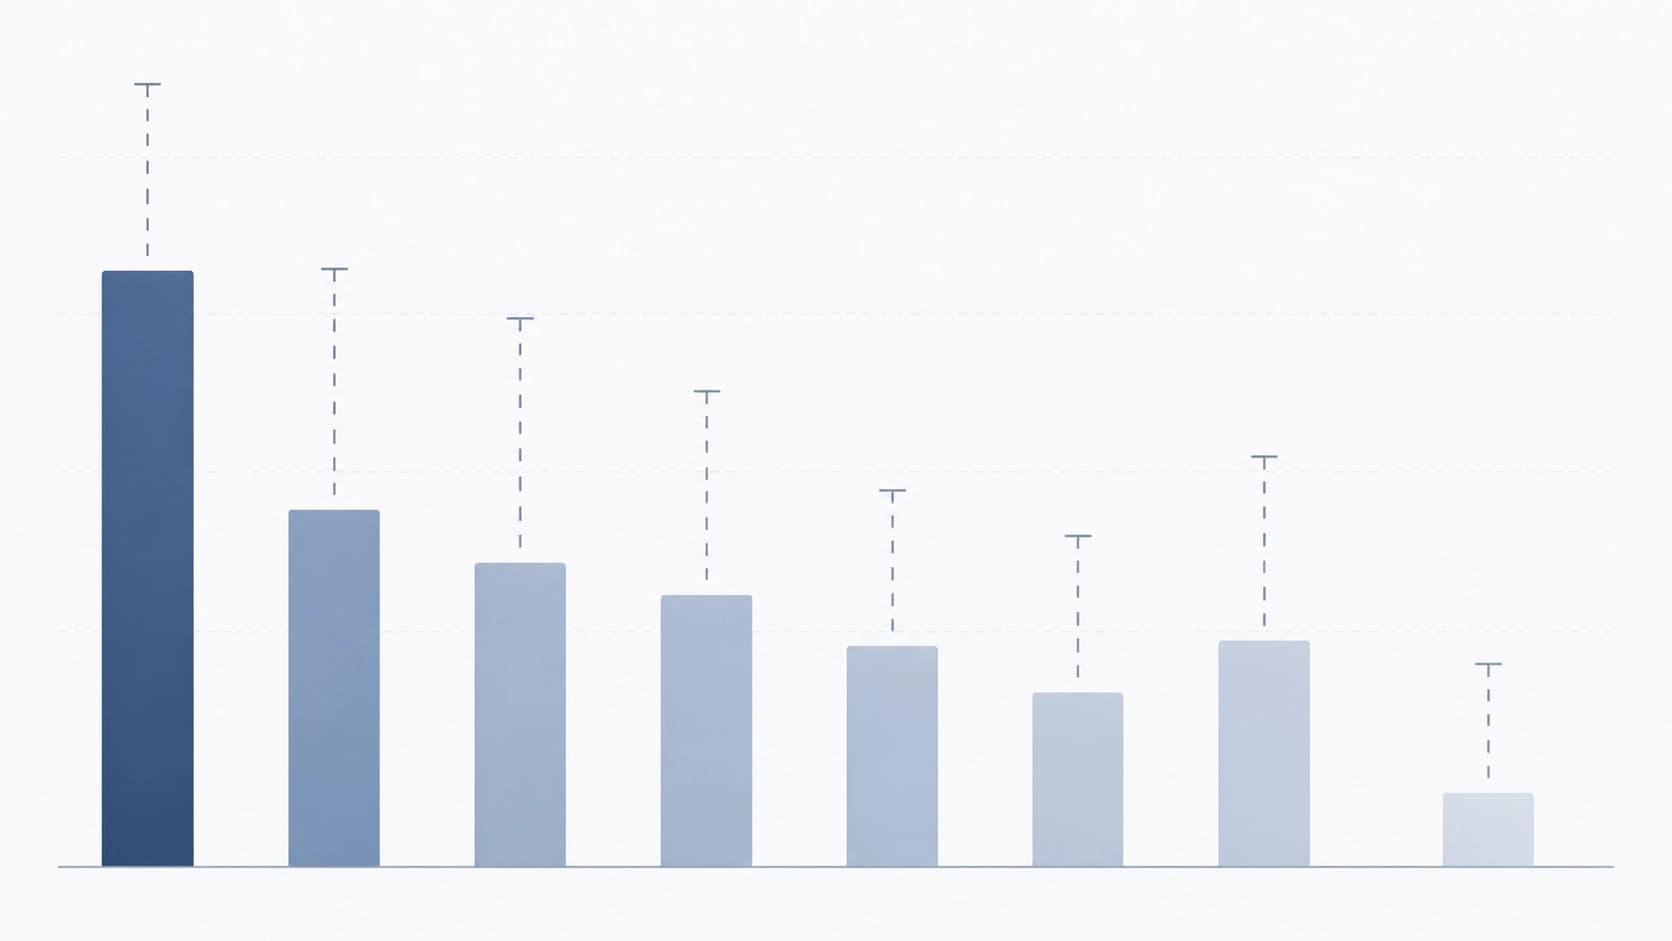
এটি র্যাঙ্কিং নয়, রোগনির্ণয় হিসেবে পড়া উচিত। বর্তমান মডেলগুলোর শক্তি — কোড সম্পাদন এবং পরিচিত বিন্যাসের উপর পাটিগণিত। দুর্বলতা — একটি ইঞ্জিনিয়ারিং কাজকে পরিমাপযোগ্য ধাপের ভাষায় অনুবাদ করা: কোন রাশিগুলো আদৌ দরকার, কোন ক্রমে খুঁজতে হবে, পাওয়া ফলটি আদৌ সঠিকের কাছাকাছি কি না তা যাচাই করা। ঠিক এই ফাঁকই বেঞ্চমার্কটিকে দরকারি করে তোলে।
ReconPilot: রেকনেসান্স, বিশ্লেষণ, যাচাই
লেখকরা শুধু পরিমাপেই সীমাবদ্ধ থাকেননি। তাঁরা ReconPilot প্রস্তাব করেছেন — একটি কাঠামোবদ্ধ পদ্ধতি, যেখানে কাজ তিনটি ধাপে বিভক্ত: সিগন্যাল রেকনেসান্স, লক্ষ্যভিত্তিক বিশ্লেষণ এবং স্ব-যাচাই। প্রথমে মডেল রেকর্ডিংটি অধ্যয়ন করে এবং বুঝে নেয় সে কী নিয়ে কাজ করছে। তারপর নির্দিষ্ট কাজটি সমাধান করে। এরপর নিজের ফলাফলে ফিরে এসে তার সামঞ্জস্য যাচাই করে।
তিনটি বেস মডেলে এই পদ্ধতি মোট স্কোরে ৩.৮ থেকে ১৭.৬ পয়েন্ট যোগ করে। পরীক্ষিত ১৫টি "ব্যাকবোন + স্তর" সমন্বয়ের ১৩টিতে উন্নতি অর্জিত হয়েছে। বাক্যগঠনের দিকে খেয়াল করুন: লাভ সমান নয়, এবং দুটি ক্ষেত্রে তা একেবারেই নেই। এটি সৎ পরীক্ষার স্বাভাবিক লক্ষণ — সর্বজনীন সমাধান মেলেনি, কিন্তু প্রবণতা স্থিতিশীল।
লক্ষণীয় যে, ধাপগুলোর স্পষ্ট বিভাজনই সাহায্য করে। যে মডেলকে শুধু "সিগন্যাল বিশ্লেষণ করো" বলা হয়, সে ডেটা বুঝেছে কি না নিশ্চিত না হয়েই গণনার দিকে ঝাঁপ দেয়। রেকনেসান্সকে আলাদা বাধ্যতামূলক ধাপ হিসেবে রাখলে মডেল আগে দেখতে বাধ্য হয়, তারপর গণনা করে।
এ থেকে কী দাঁড়ায়
ইঞ্জিনিয়ারিং অনুশীলনের জন্য উপসংহারটি বেশ সরাসরি: বাস্তব পরিমাপের উপর এজেন্টের গণনায় ভরসা করার আগে, ইঙ্গিত ছাড়া ডেটায় তাকে পরীক্ষা করা উচিত। সুবিধাজনক ইন্টারফেস এবং চ্যাটে মসৃণ উত্তর কিছুই বলে না যে মডেল রিসিভার থেকে আসা অপরিশোধিত ডেটার মুখোমুখি হলে টিকবে কি না।
আরও সাধারণ একটি ভাবনাও আছে, যা রেডিওর সীমা ছাড়িয়ে যায়। যে কোনো ক্ষেত্রে যেখানে যুক্তি কাঁচা পরিমাপের উপর নির্ভর করে — হাইড্রোঅ্যাকুস্টিকস, কম্পন, টেলিমেট্রি — এজেন্টকে প্রথমে ডেটার মধ্যে রাশিটি খুঁজে বের করতে জানতে হবে, তারপর তা নিয়ে কাজ করতে হবে। ফিচারযুক্ত টেবিল কাজের এই অংশটি লুকিয়ে রাখে, আর তার সঙ্গে লুকিয়ে পড়ে ভুলগুলোও।
সীমাবদ্ধতা ও পরবর্তী কী
প্রশ্নটি সম্পূর্ণ নিষ্পত্তি হয়েছে বলা যায় না। ২০০টি কাজ — পরিমাণ যথেষ্ট, কিন্তু অসীম নয়, আর ১১ ধরনের সিগন্যালের ভিত্তিতে জেনারেশন মানে বাস্তব মাঠের রেকর্ডিং তাদের সব আর্টিফ্যাক্টসহ সেখানে এখনও উপস্থাপিত নয়। ১৪টি মডেলের মূল্যায়ন — মুহূর্তের একটি স্ন্যাপশট, চূড়ান্ত রায় নয়: এই ক্ষেত্রে শীর্ষস্থানীয়দের তালিকা দ্রুত বদলায়।
তবুও কাজটির বিন্যাস সঠিক মনে হয়। আমরা যদি চাই LLM-গুলো ডেটার পুনর্কথনের বদলে ডেটা নিয়েই কাজ করুক, তবে তাদের ঠিক সেখানেই পরীক্ষা করা উচিত যেখানে ইঙ্গিত শেষ হয়। EMRB ঠিক তাই করে — এবং দেখায় যে সিগন্যাল রেকনেসান্সে মডেলগুলোর বৃদ্ধির সুযোগ এখনও অনেক বড়।


