
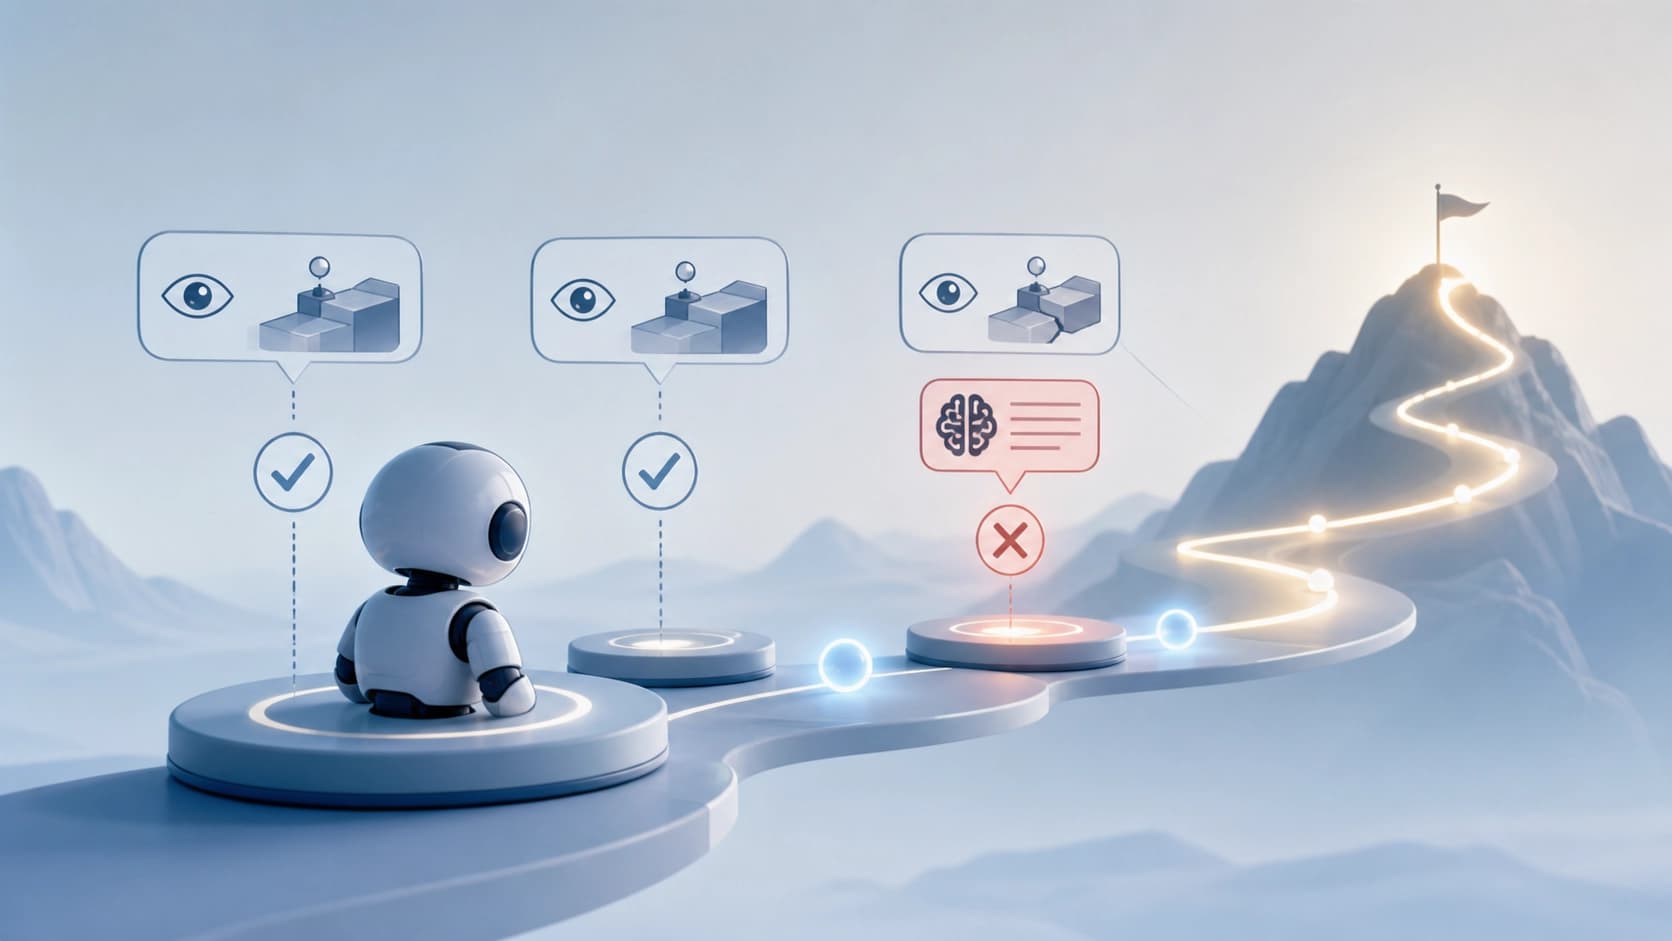
সমস্যা: পুরো ট্র্যাজেক্টরির জন্য একটিই পুরস্কার
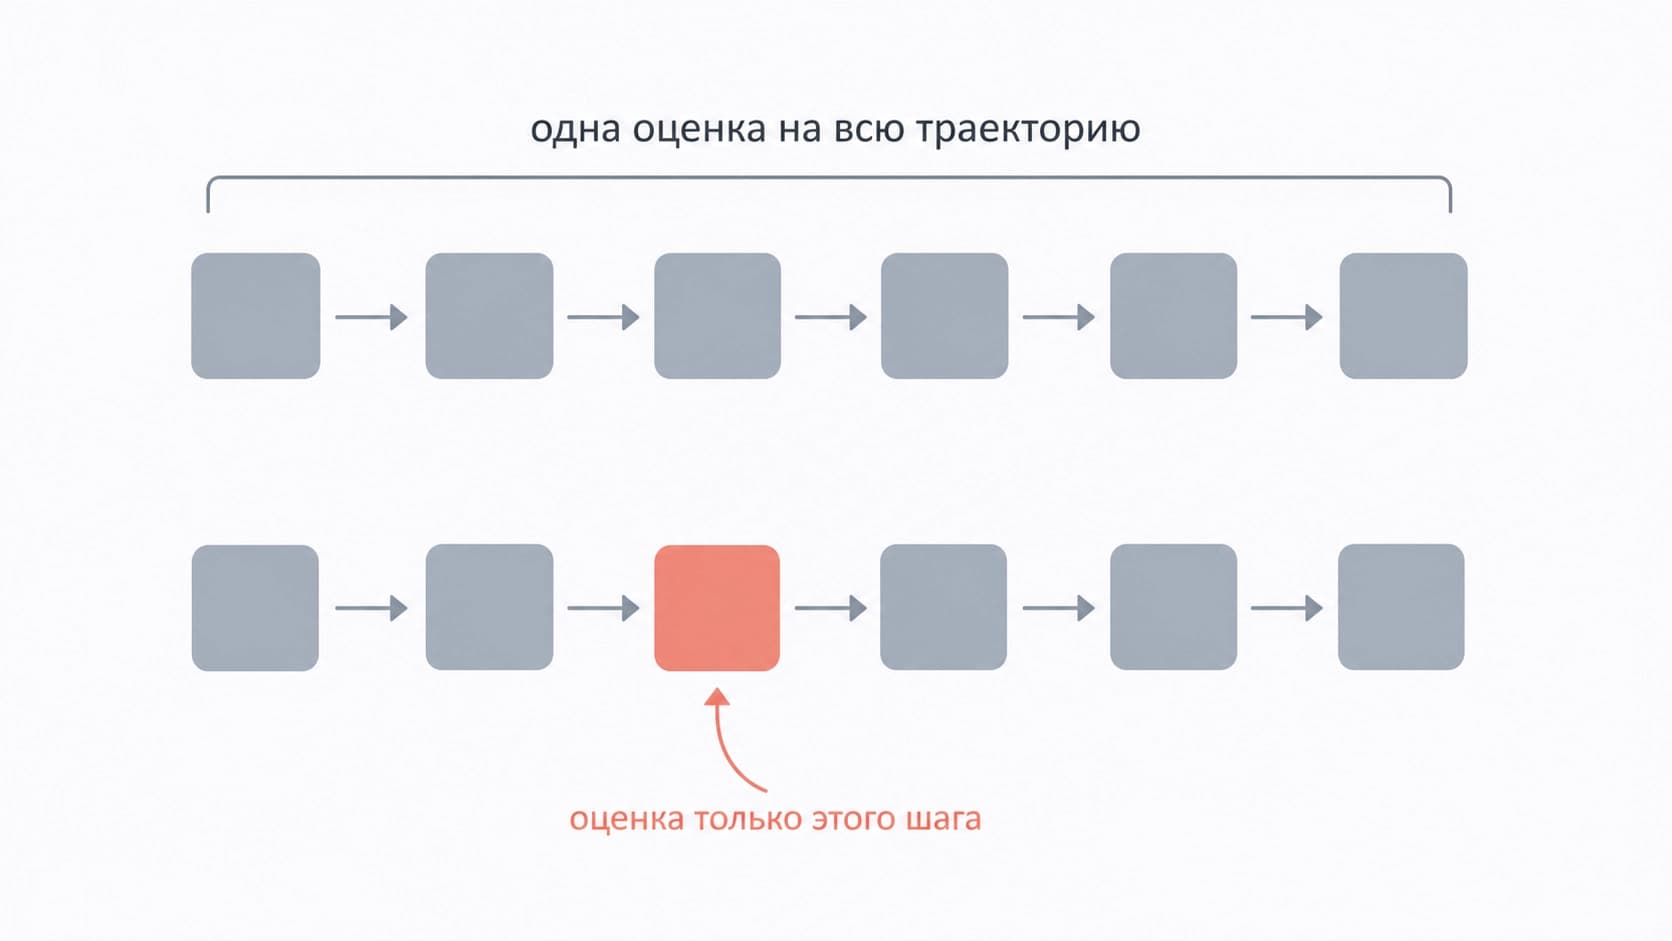
LLM-ভিত্তিক মাল্টি-টার্ন এজেন্টরা পরীক্ষা-নিরীক্ষার মাধ্যমে শেখে: তারা একগুচ্ছ কাজ করে, শেষে একটি সামগ্রিক মূল্যায়ন পায় এবং সেই অনুযায়ী আচরণ ঠিক করে। সমস্যা হলো, এই মূল্যায়ন সাধারণত পুরো ট্র্যাজেক্টরির জন্য একসাথে আসে। এজেন্ট জানতে পারে কাজটি হয়েছে কি হয়নি, কিন্তু কোন ধাপে ঠিক কোথায় ভুল হয়েছে তা জানতে পারে না।
এরপর শুরু হয় এমন এক হিসাব, যা সাধারণ বুদ্ধির সাথে ভালোভাবে মেলে না। একই সুবিধা পরপর সব ধাপে ছড়িয়ে দেওয়া হয় — সঠিকভাবে টুল বেছে নেওয়া, কোয়েরিতে случайная টাইপো, আর রুটিন "কাজটি নিশ্চিত করুন" — সবকিছুর উপর। ফলে মডেল একইসাথে случайные ভুল এবং স্বাভাবিক কাজের ধাপ দুটোকেই পুরস্কৃত করে, যদি শেষ ফলাফল সফল হয়। সাফল্যের কৃতিত্ব সবার মধ্যে সমানভাবে ভাগ হয়, আর ব্যর্থতার দোষও সবার।
চিরাচরিত সমাধান হলো বিশেষ সুবিধাপ্রাপ্ত তথ্যসহ স্ব-ডিস্টিলেশন। শিক্ষক শিক্ষার্থীর চেয়ে বেশি জানে: তার কাছে পরিবেশ, মধ্যবর্তী সংকেত এবং সঠিক উত্তরের প্রবেশাধিকার আছে। সে প্রতিটি ধাপে ইঙ্গিত দিতে পারে, শুধু শেষে নয়। শুনতে ভালো লাগে, কিন্তু এই পদ্ধতিতে একটি লুকানো অসতর্কতা আছে: একই ইঙ্গিত বাছবিচার ছাড়াই সব ধাপে দেওয়া হয়।
ধাপের অসমতা: রুটিন আর ভুলের জন্য দরকার ভিন্ন কিছু
AHEAD গবেষণাপত্রের মূল কথা হলো, ট্র্যাজেক্টরির ধাপগুলো সমমূল্যের নয়, এবং তাদের জন্য সুপারভিশনও ভিন্ন হওয়া উচিত।
- রুটিন ধাপ — পৃষ্ঠা খোলা, переход নিশ্চিত করা, প্রয়োজনীয় টুল ডাকা — এগুলোর প্রায় কোনো ইঙ্গিতের দরকার নেই। মডেল নিজেই সামলে নেয়। এখানে অতিরিক্ত নির্দেশনা শুধু প্রশিক্ষণে গোলমাল যোগায় আর বাজেট নষ্ট করে।
- ত্রুটিপূর্ণ সংকটপূর্ণ ধাপ — যেখানে এজেন্ট ভুল পথে মোড় নিয়েছে এবং সফল হওয়ার সুযোগ হারিয়েছে — সেখানে শুধু "এখানে খারাপ" বলে দেওয়া যথেষ্ট নয়, নির্দিষ্ট দিকনির্দেশনা দরকার: এর বদলে কী করা উচিত ছিল।
- পরিবেশ থেকে পাওয়া ফিডব্যাক ঘটনাটিকে ভালোভাবে ভিত্তি দেয়: এটি বলে দেয় আসলে কী ঘটেছে। কিন্তু এটি ব্যাখ্যা করতে পারে না কী করা উচিত ছিল। "দরজা খোলেনি" — এই সংকেত বলে না চাবি কোথায় ছিল।
তাহলে দেখা যাচ্ছে, সুপারভিশনের দুটি উৎস একে অপরকে পরিপূরক, কিন্তু প্রতিস্থাপন করে না। পরিবেশের ফিডব্যাক প্রতিটি ধাপে ঘন এবং সৎ সংকেত দেয়; মডেল-উৎপন্ন সংশোধনমূলক ইঙ্গিত দেয় এমন কিছু, যা পরিবেশের ফিডব্যাকে মূলত নেই — অভিপ্রায় এবং বিকল্প। পুরো ট্র্যাজেক্টরিতে অন্ধভাবে এগুলো মিশিয়ে দেওয়া মানে দুটিরই শক্তিশালী দিক হারানো।
AHEAD কীভাবে কাজ করে
লেখকরা — Xiaolong Jin, Dingmin Wang, Vijay Lingam এবং Varun Kumar — এমন একটি ফ্রেমওয়ার্ক প্রস্তাব করেন, যা ধাপের ধরন বুঝে তার জন্য উপযুক্ত সুপারভিশনের উৎস বেছে নেয়। গবেষণাপত্রটি ২০২৬ সালের আগস্টের শেষে arXiv-এ প্রকাশিত, cs.AI বিভাগে; আয়তন — ২২ পৃষ্ঠা, ১৫টি চিত্র এবং ৭টি টেবিল, অর্থাৎ বিস্তারিত জানার মতো যথেষ্ট উপাদান আছে।
এমন শিক্ষক, যিনি পরিবেশ দেখেন
শিক্ষক মডেল সব ধাপে পরিবেশের ফিডব্যাক পায় — এটি একটি ভিত্তিযুক্ত এবং ঘন সংকেত, যা সফল ও ব্যর্থ উভয় অংশেই সমানভাবে পাওয়া যায়। এমন শিক্ষক কল্পনা করে না: তিনি নির্ভর করেন পরিবেশে সত্যিই যা ঘটেছে তার উপর।
সংশোধনমূলক ইঙ্গিত — নির্দিষ্টভাবে
এর উপরে শিক্ষক LLM-উৎপন্ন ইঙ্গিত পান, তবে সব ধাপে নয়, বরং কেবল ভুল ধাপগুলোতে। যুক্তিটি সরল: যেখানে এজেন্ট ভুল করেছে, সেখানে পরিবেশ থেকে পাওয়া তথ্য একা যথেষ্ট নয়, দরকার ব্যাখ্যা — কোন দিকে এগোনো উচিত ছিল। আর যেখানে সবকিছু মসৃণভাবে চলছে, সেখানে অতিরিক্ত নির্দেশনা একেবারেই যোগ করা হয় না।
এটাই শিরোনামের "নির্দিষ্ট ইঙ্গিত": ট্র্যাজেক্টরিতে ছড়ানো নয়, বরং সমস্যাযুক্ত বিন্দুতে কেন্দ্রীভূত। পুরো কর্মধারার জন্য একক সংকেতের বদলে ধাপ-সচেতনভাবে সুপারভিশনের উৎস মেলানো।
GRPO-তে ন্যূনতম পরিবর্তন
আলাদাভাবে উল্লেখ করার মতো পদ্ধতিটির প্রকৌশলগত সংযম। GRPO — একটি জনপ্রিয় রিইনফোর্সমেন্ট লার্নিং অ্যালগরিদম — শূন্য থেকে নতুন করে লেখা হয়নি: পরিবর্তনগুলো নির্দিষ্টভাবে, আদর্শ কাঠামোর উপরে করা হয়েছে। অনুশীলনকারীদের জন্য এটি গুরুত্বপূর্ণ, কারণ এজেন্ট প্রশিক্ষণের পুরো পাইপলাইন নতুন করে সাজানোর দরকার পড়ে না।
পরীক্ষাগুলো কী দেখাল
মূল্যায়ন করা হয় তিন ধরনের কাজে: ALFWorld — টেক্সট পরিবেশে বহু-ধাপের দৃশ্যকল্প, WebShop — অনলাইন দোকানের সাথে মিথস্ক্রিয়া, এবং অনুসন্ধানভিত্তিক প্রশ্নোত্তর। তিনটি মাপের মডেল পরীক্ষা করা হয়, তাই সিদ্ধান্তগুলো একটিমাত্র আকারের সাথে বাঁধা নয়।
সাধারণ GRPO-র সাথে তুলনায় ফলাফল:
- ALFWorld-এ 7B মডেলে সফলতার হার +১৩.৩ পয়েন্ট;
- একই মাপে WebShop-এ +১১.০ পয়েন্ট।
পরম সংখ্যার পাশাপাশি আরও দুটি কম আকর্ষণীয় নয় এমন প্রভাব আছে। প্রথমত, নির্দিষ্ট সফলতার মাত্রা কম প্রশিক্ষণ ধাপে অর্জিত হয় — অর্থাৎ পদ্ধতিটি কেবল সীমায় ভালো নয়, বরং দ্রুত কার্যকর অবস্থায় পৌঁছায়। দ্বিতীয়ত, এজেন্ট আরও সংকীর্ণ মিথস্ক্রিয়া বাজেটে কাজগুলো সমাধান করে, তুলনায় কেবল চূড়ান্ত পুরস্কারভিত্তিক পদ্ধতি এবং পূর্ববর্তী স্ব-ডিস্টিলেশন পদ্ধতিগুলোর।
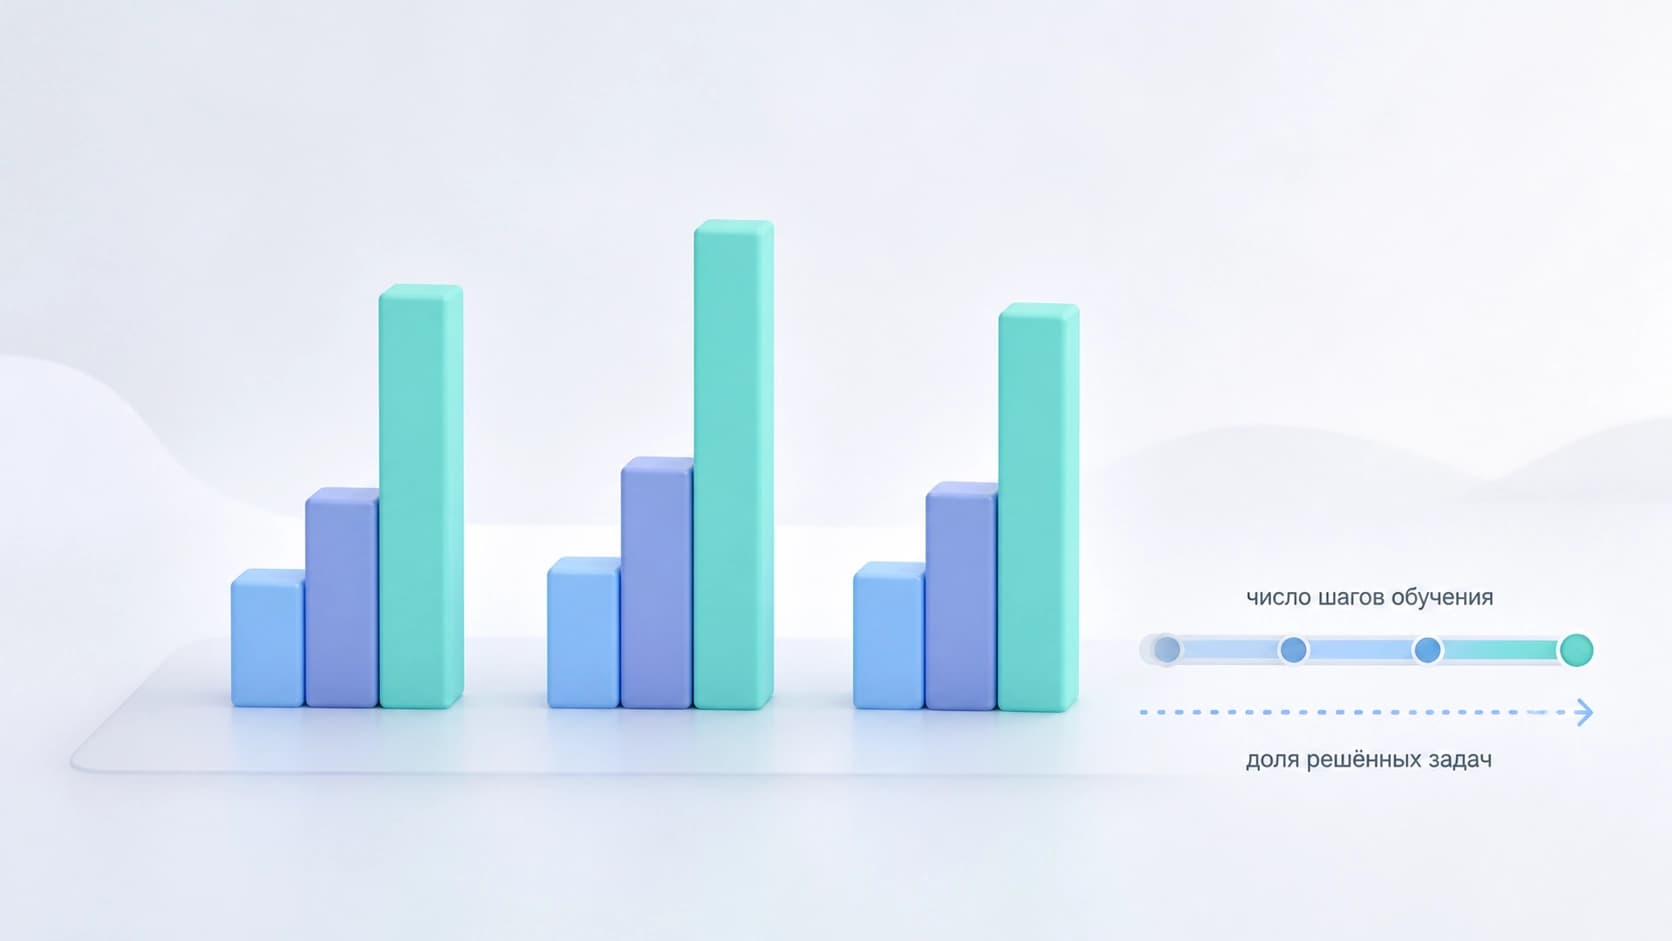
দ্বিতীয় বিষয়টি, আমার মতে, অবমূল্যায়িত। মিথস্ক্রিয়া ধাপের সাশ্রয় — এটি কেবল সৌন্দর্যের মেট্রিক নয়। বাস্তব পরিস্থিতিতে প্রতিটি টুল কল টাকা, সময় এবং ঝুঁকি খরচ করে। যে এজেন্ট দশটি কাজের বদলে পাঁচটি কাজে লক্ষ্যে পৌঁছায়, সে ১৩ শতাংশ নয়, বরং বহুগুণ বেশি উপকারী — বিশেষত যেখানে ভুলের মূল্য বেশি।
কেন এটি কাজ করে এবং কী অজানা থেকে যায়
পদ্ধতিটির ব্যাখ্যা প্রায় শিক্ষামূলক। একজন ভালো শিক্ষক শিক্ষার্থীর প্রতিটি নড়াচড়ায় মন্তব্য করেন না — শিক্ষার্থী যখন বুদ্ধিমান কাজ করে তখন তিনি চুপ থাকেন, এবং ঠিক সেখানে হস্তক্ষেপ করেন যেখানে শিক্ষার্থী পথ হারায়। সবকিছুতে মন্তব্য করলে শিক্ষার্থী নিজে ভাবা বন্ধ করে দেয় এবং ইঙ্গিতের অপেক্ষায় থাকে। কিছুই না বললে সে একই ভুল বারবার করতে থাকে।
AHEAD এই অন্তর্দৃষ্টিটিকে রিইনফোর্সমেন্ট লার্নিংয়ের পরিভাষায় রূপ দেয়: ভিন্ন ধরনের ধাপ — ভিন্ন সংকেতের উৎস। ঘন ভিত্তিযুক্ত ফিডব্যাক — পটভূমি হিসেবে, সংশোধনমূলক দিকনির্দেশনা — জোর হিসেবে। কোনো জাদু নেই, শুধু এই ধারণা বর্জন যে সব ধাপ সমান।
যা প্রশ্ন হয়ে রয়ে যায়। সংশোধনমূলক ইঙ্গিত তৈরি করতেই একটি মডেল দরকার, ফলে এটি গণনাগত খরচ যোগ করে এবং তার গুণমানের উপর নির্ভর করে — শিক্ষক ভুল ব্যাখ্যা দিলে শিক্ষার্থী আত্মবিশ্বাসী কিন্তু ভুল দিকনির্দেশনা পাবে। এটাও খোলা প্রশ্ন থেকে যায়, পদ্ধতিটি এমন কাজে কতটা প্রযোজ্য যেখানে মধ্যবর্তী ধাপের মূল্য ALFWorld বা WebShop-এর মতো স্পষ্ট নয়, এবং যেখানে ধাপের "ত্রুটিপূর্ণতা" সবসময় সাথে সাথে নির্ধারণ করা যায় না, বরং কেবল বিলম্বিত পরিণতি থেকে।
তবুও দিকটি সুস্থ মনে হচ্ছে। সাম্প্রতিক বছরগুলোতে এজেন্ট পদ্ধতির বিকাশের মূল ধারা — মডেল বড় করা নয়, বরং প্রশিক্ষণের সংকেত আরও বুদ্ধিমানের সাথে ব্যবহার করা। AHEAD ঠিক সেই ধারারই: সর্বগ্রাসী নিয়ন্ত্রণের বদলে নির্দিষ্ট হস্তক্ষেপ।


