
সহজে বিশ্বাস করার মতো বিচারক
মাল্টিমোডাল মডেলগুলো 점점 더 বেশি করে সালিশের ভূমিকায় আসছে: তারা ছবি, ভিডিও দেখে বা অডিও শুনে রায় দেয় — ফলাফলটি টেক্সট প্রম্পটের সাথে মেলে কি না। এই ধরনের "সর্বভুক" বিচারকদের জেনারেটিভ সিস্টেম মূল্যায়নেও ব্যবহার করা হয়, আবার স্বয়ংক্রিয় ডেটা লেবেলিংয়েও, যখন সবকিছুর জন্য জীবন্ত বিশেষজ্ঞ যথেষ্ট হয় না।
যুক্তিটা স্পষ্ট: যদি একটি মডেল একসাথে একাধিক মোডালিটি বুঝতে পারে, তবে text-to-image, text-to-video এবং text-to-speech যাচাইয়ের দায়িত্ব তার উপর কেন ছাড়া হবে না? কিন্তু এখানেই একটি অস্বস্তিকর প্রশ্ন লুকিয়ে আছে। এমন বিচারকের ভালো সামগ্রিক নির্ভুলতা এখনও প্রমাণ করে না যে সে সত্যিই যা মূল্যায়ন করছে তা দেখছে। বিদ্যমান টেস্ট সেট এবং প্রশিক্ষণ সংগ্রহ সাধারণত সফল উদাহরণের দিকে ঝুঁকে থাকে, আর বিভিন্ন ধরনের ব্যর্থতা সেগুলোতে একসাথে জড়ো করা হয়।
ফলাফল — একটি বিকৃত চিত্র। বিচারক শালীন সংখ্যা দেখায়, কারণ সে "হ্যাঁ" বলতে শিখেছে, আর তার প্রকৃত অন্ধ জায়গাগুলো অলক্ষিত থেকে যায়। ঠিক এই সমস্যাটিই arXiv-এর একটি নতুন কাজ বিশ্লেষণ করছে।
লেখকরা কী প্রস্তাব করছেন: D3-Omni
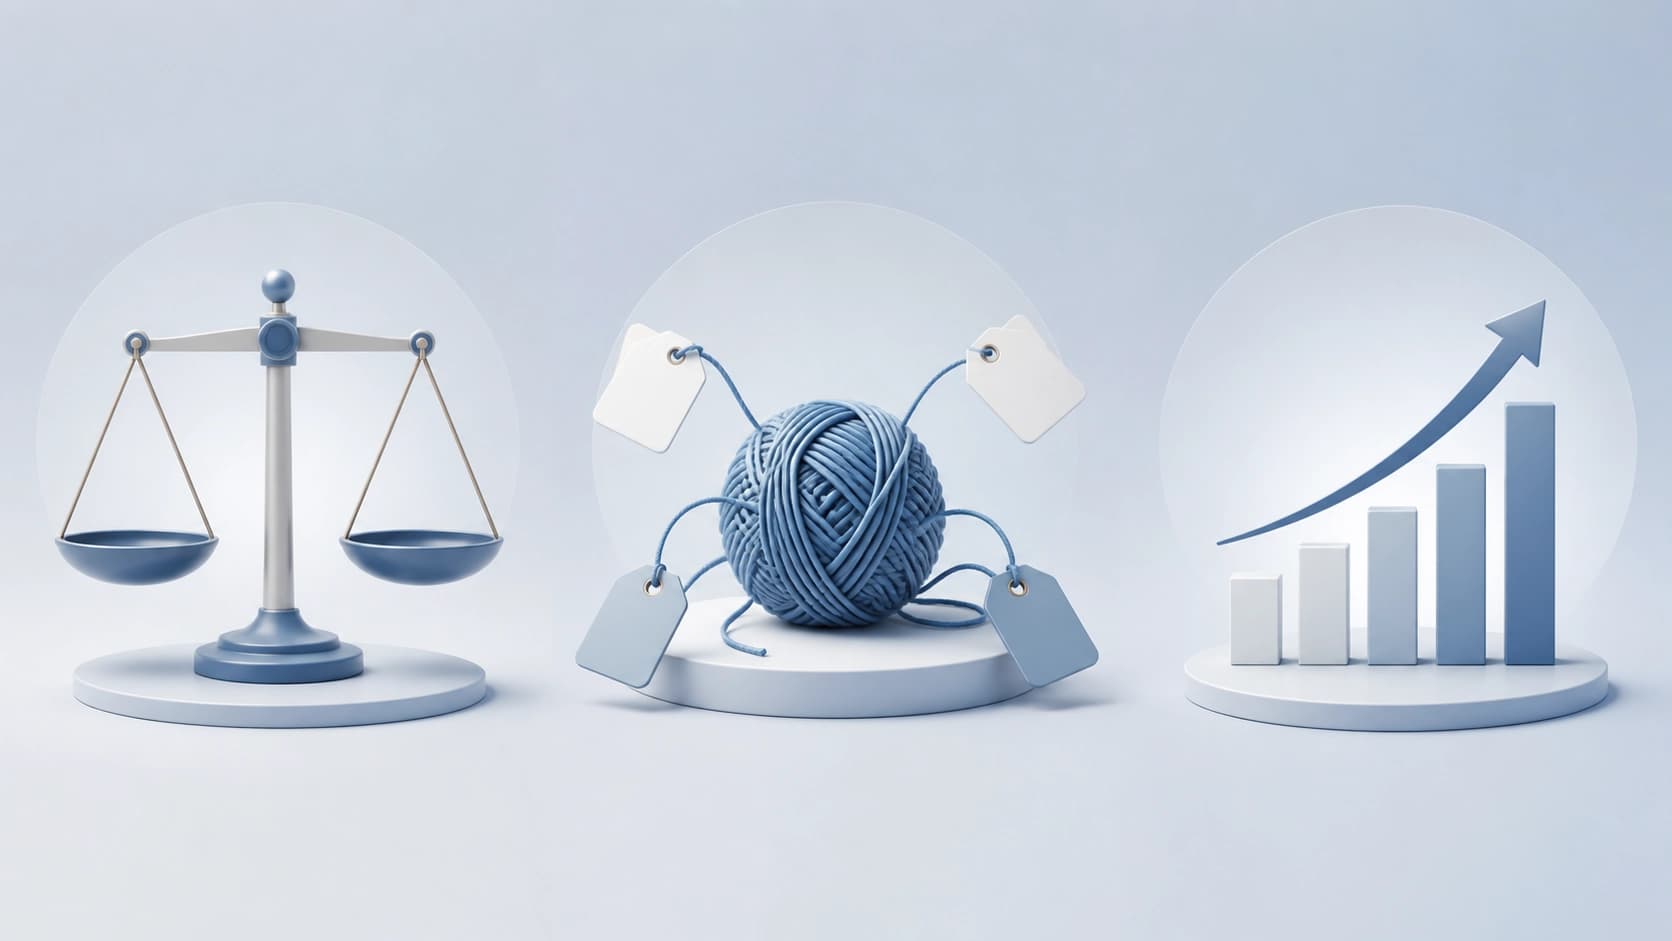
গবেষণাটি এমন একটি শিরোনামে প্রকাশিত হয়েছে, যা লেখকরা নিজেরাই একটি বৈপরীত্বের উপর দাঁড় করিয়েছেন: "OmniJudge or OmniBias?"। আরেকটি র্যাঙ্কিংয়ের বদলে তারা একটি ডায়াগনস্টিক টুল তৈরি করেছেন — D3-Omni, একটি বেঞ্চমার্ক, যা এমনভাবে সাজানো যাতে বিচারককে সামগ্রিক পরিসংখ্যানের আড়ালে লুকানোর সুযোগ না দেয়। নামটি তিনটি নীতিতে উন্মোচিত, আর প্রতিটি নীতিই প্রচলিত পরীক্ষার একটি নির্দিষ্ট দুর্বলতায় আঘাত করে।
Dual-balanced: "সবকিছু ভালো" দিকে ঝোঁক দূর করা হয়
প্রথম নীতিটি ভারসাম্যের জন্য দায়ী। উদাহরণ যেভাবে হয় সেভাবে জড়ো করার বদলে, সংগ্রহটি সমান করা হয়: প্রতিটি যাচাইকৃত বৈশিষ্ট্যের জন্য সফল ও ব্যর্থ উভয় ক্ষেত্রের তুলনীয় সংখ্যা থাকতে হবে। এভাবে সেই পরিস্থিতি দূর হয়, যেখানে মডেল কেবল এই কারণে পয়েন্ট পায় যে সঠিক উত্তরটি বেশিরভাগ সময় "হ্যাঁ"।
Decoupled: একটি ত্রুটি — একটি কারণ
দ্বিতীয় নীতিটি — বিচ্ছিন্নকরণ। পরীক্ষার প্রতিটি ত্রুটি ঠিক একটি ক্ষমতার সাথে যুক্ত। যদি বিচারক ভুল করে, তবে বোঝা যায় তার ঠিক কী অভাব হয়েছে: কম্পোজিশন বোঝা, রঙ, শব্দের সিঙ্ক্রোনাইজেশন নাকি আরও কিছু। কোনো মিশ্র উদাহরণ নয়, যেখানে বোঝা যায় না তিনটি লঙ্ঘনের মধ্যে কোনটি মডেলকে বিভ্রান্ত করেছে।
Dynamic: পরীক্ষা জেনারেটরদের অগ্রগতির সাথে খাপ খায়
তৃতীয় নীতিটি — গতিশীলতা। জেনারেটিভ মডেলগুলো নতুন ক্ষেত্র আয়ত্ত করার সাথে সাথে পরীক্ষার গঠন সেদিকে পরিচালিত হয়, যেখানে উদাহরণের প্রতিনিধিত্ব এখনও যথেষ্ট নয়। লক্ষ্য — প্রতিটি বৈশিষ্ট্যে প্রায় এক থেকে এক অনুপাতে সমতা রাখা এবং চূড়ান্ত স্কোরের সব স্তরে সমান পূরণ নিশ্চিত করা।
ডেটাসেট কীভাবে সাজানো
D3-Omni-এর পরিসর শালীন: ৫৩টি বাইনারি বৈশিষ্ট্য, তিনটি টাস্কে বিভক্ত (প্রতিটিতে ১৭, ২২ এবং ১৪), এবং ১০,৬৭১টি উদাহরণ (যথাক্রমে ৩,৫২৬, ১,৯৯৮ এবং ৫,১৪৭)। বৈশিষ্ট্যগুলো অর্থোগোনালভাবে বাছাই করা — তারা একে অপরের পুনরাবৃত্তি করে না।
আলাদা একটি ইঞ্জিনিয়ারিং খুঁটিনাটি — নেগেটিভ উদাহরণ কীভাবে পাওয়া যায়। লেখকরা নীতিগতভাবে আউটপুট পুনরায় জেনারেট করা প্রত্যাখ্যান করেছেন: এমন পথ বৈশিষ্ট্যগুলোর মধ্যে তথ্য ফাঁসের দিকে নিয়ে যায়, আর পরীক্ষা আর বিশুদ্ধ থাকে না। এর বদলে সম্পূর্ণ ইতিবাচক যাচাইকৃত "বীজ" নেওয়া হয়, আর লঙ্ঘনগুলো নিয়ন্ত্রিতভাবে যোগ করা হয় — প্রম্পট পুনর্লিখন করে এবং একটি বৈশিষ্ট্যকে বিচ্ছিন্ন করে এমন সূক্ষ্ম ব্যাঘাত যোগ করে।
কী বেরিয়ে এলো: বিচারকরা আত্মবিশ্বাসের সাথে প্রশংসা করে, কিন্তু ত্রুটি খারাপভাবে ধরে
কাজটির সবচেয়ে মজার দিকটি বেঞ্চমার্কের গঠন নয়, বরং এটি যা দেখিয়েছে। এমনকি শক্তিশালী মাল্টিমোডাল বিচারকরাও সরাসরি মোডালিটির সাথে সম্পর্কিত বৈশিষ্ট্যগুলোতে হোঁচট খায়। সহজ কথায়, ঠিক যে কারণে তাদের মূল্যায়নকারী হিসেবে নেওয়া হয়, সেটিই তাদের জন্য কঠিন।
দ্বিতীয় পর্যবেক্ষণটি আরও অস্বস্তিকর। মডেলগুলো পূরণ হওয়া প্রয়োজনীয়তাগুলো নিশ্চিত করতে লক্ষণীয়ভাবে বেশি নির্ভরযোগ্য, তুলনায় লঙ্ঘিতগুলো সনাক্ত করতে। অসমতাটি স্থায়ী: "এখানে সবকিছু প্রম্পটের সাথে মেলে" বলা বিচারকের জন্য একটি নির্দিষ্ট অসঙ্গতি ধরা থেকে অনেক সহজ।
তৃতীয় — নামমাত্র ভিন্ন বৈশিষ্ট্যগুলোকে মডেল একটি একক সমাধান হিসেবে воспринимать করার প্রবণতা রাখে। বৈশিষ্ট্যগুলোর মধ্যে পার্থক্য মুছে যায়, আর বিচারক পয়েন্টভিত্তিক বিশ্লেষণের বদলে একটি সাধারণ রায় দেয়।
কেন সমষ্টিগত শতাংশ প্রতারণা করে
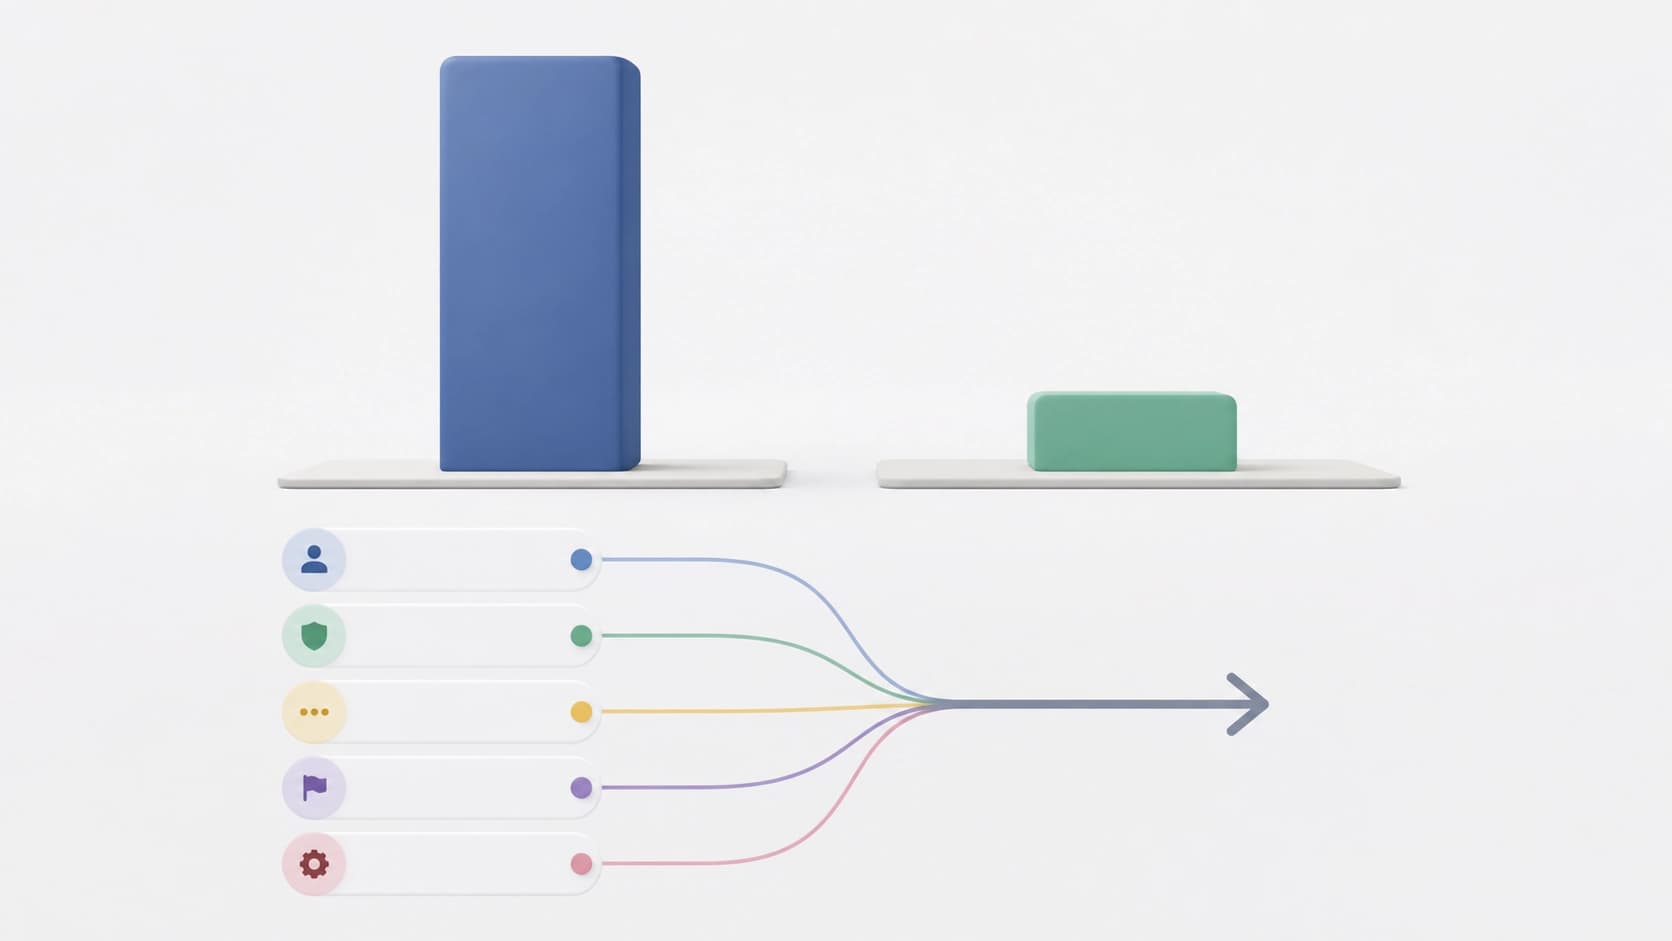
এই পর্যবেক্ষণগুলো থেকে মূল সিদ্ধান্তটি তৈরি হয়: চূড়ান্ত নির্ভুলতা পদ্ধতিগত অন্ধ জায়গাগুলোকে আড়াল করতে পারে। যে বিচারক ধারাবাহিকভাবে "ইতিবাচক" উত্তর অনুমান করে, সে ঝুঁকে থাকা সংগ্রহে শালীন দেখাবে — আর যেখানে জেনারেটরের ত্রুটি ধরতে হবে সেখানে ব্যর্থ হবে।
সুষম ও বিচ্ছিন্ন দৃষ্টিভঙ্গি মেট্রিকের সৌন্দর্যের জন্য নয়, বরং এই জায়গাগুলোকে দৃশ্যমান করতেই প্রয়োজন। আর দেখতে পেলে — লক্ষ্যভিত্তিকভাবে বন্ধ করা যায়: সমস্যাযুক্ত বৈশিষ্ট্যগুলোতে অতিরিক্ত প্রশিক্ষণ দিয়ে, গড় স্কোরের পেছনে ছোটার বদলে।
বাস্তব ক্ষেত্রে এর অর্থ একটি সহজ বিষয়। যদি আপনি এমন একটি পাইপলাইন তৈরি করেন, যেখানে মডেল-বিচারক জেনারেশনের ফলাফল ফিল্টার করে বা ডেটাসেট লেবেল করে, তবে তাকে নেগেটিভের দিকে ঝুঁকে থাকা সংগ্রহে পরীক্ষা করতে হবে, সফল উদাহরণের সুবিধাজনক নমুনায় নয়। নাহলে মূল্যায়নকারী ত্রুটি উপেক্ষা করবে, আর আপনি তা মেট্রিক থেকে নয়, ব্যবহারকারীদের কাছ থেকে জানতে পারবেন।
সংক্ষেপে
- D3-Omni — মাল্টিমোডাল বিচারকদের ডায়াগনস্টিকের জন্য একটি বেঞ্চমার্ক, মডেলের র্যাঙ্কিং নয়।
- তিনটি নীতি: ইতিবাচক ও নেতিবাচক উদাহরণের ভারসাম্য, প্রতিটি ত্রুটিকে একটি ক্ষমতার সাথে যুক্ত করা, জেনারেটরদের বিকাশের সাথে পরীক্ষার খাপ খাওয়ানো।
- ৫৩টি বৈশিষ্ট্য এবং text-to-image, text-to-video ও text-to-speech টাস্কে প্রায় ১১ হাজার উদাহরণ।
- নেগেটিভগুলো প্রম্পট পুনর্লিখন ও সূক্ষ্ম ব্যাঘাতের মাধ্যমে তৈরি, পুনরায় জেনারেশনের মাধ্যমে নয় — যাতে বৈশিষ্ট্যগুলো মিশে না যায়।
- মূল সিদ্ধান্ত: উচ্চ গড় ফলাফল স্থায়ী অন্ধ জায়গাগুলো লুকাতে পারে, বিশেষত সেখানে যেখানে মিল নিশ্চিত করার বদলে লঙ্ঘন লক্ষ্য করা প্রয়োজন।


