Симуляторы не поспевают за реальными системами
Развернуть настоящий кластер под обслуживание больших языковых моделей — дорого, а часто и просто невозможно: нет железа, нет бюджета, нет времени ждать. Поэтому системное моделирование давно стало для исследователей рабочим инструментом: сначала считаешь на симуляторе, потом идёшь в железо.
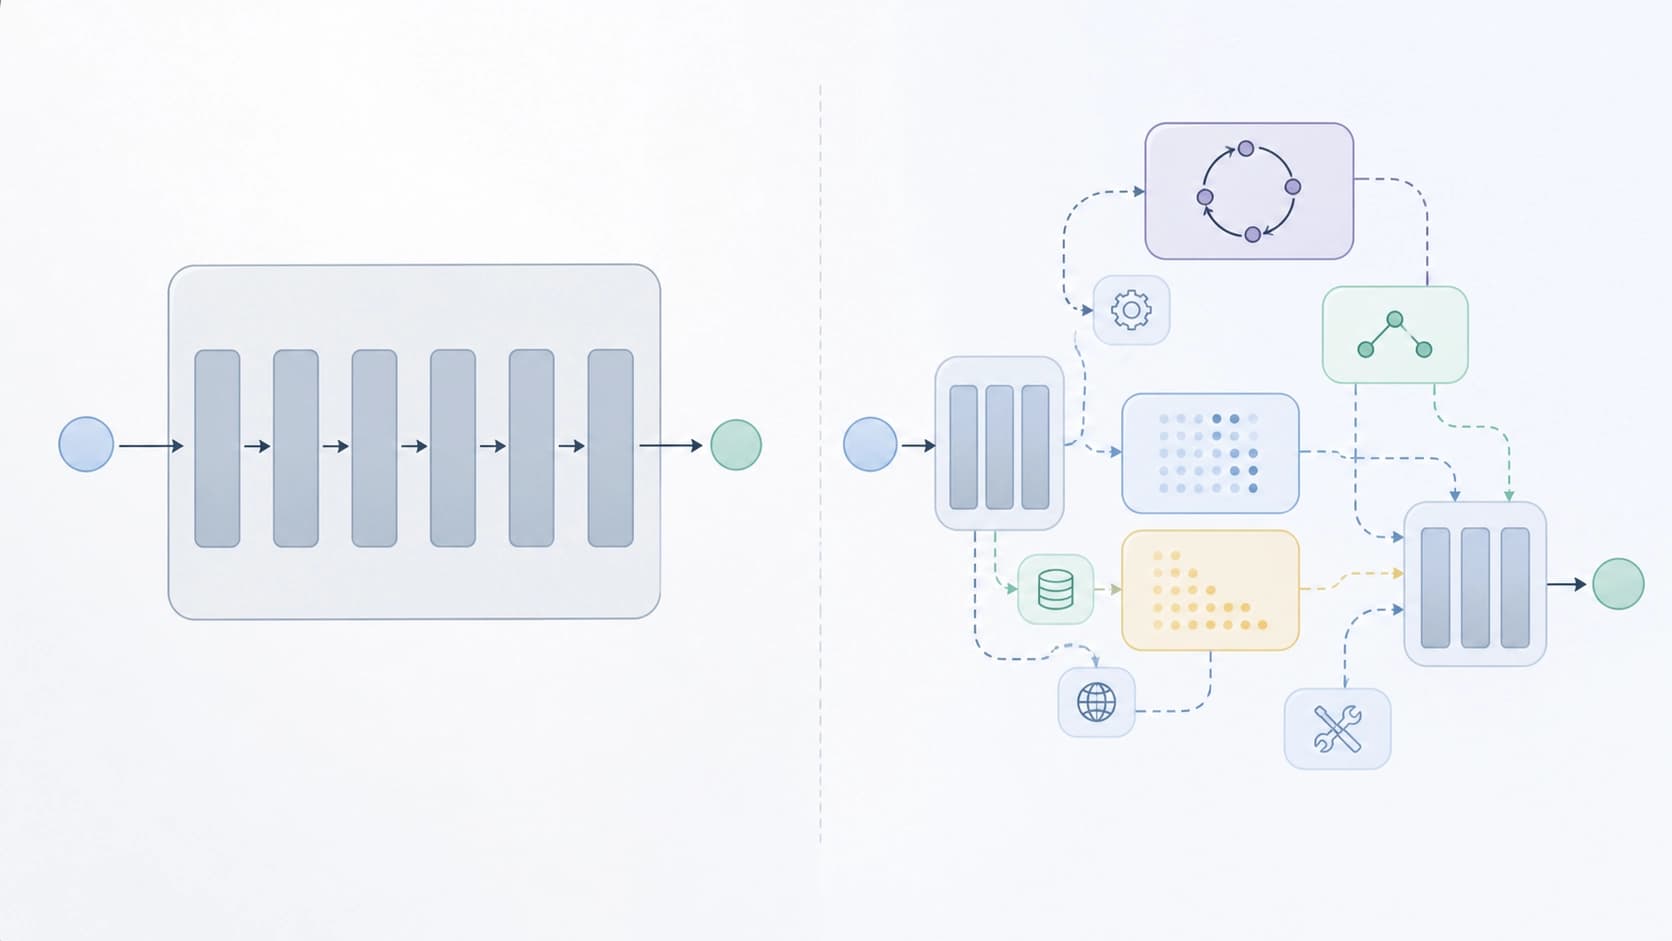
Загвоздка в том, что сама область движется быстрее, чем идёт разработка симуляторов. Новые рабочие нагрузки — агентные сценарии, где модель вызывает инструменты и работает в цикле, схемы с разделёнными фазами prefill и decode — перестали укладываться в монолитный конвейер, который заложен в существующие симуляторы. Любой новый механизм приходится вкручивать сбоку через болезненную переработку ядра. В итоге разрыв между тем, что реально крутится на продакшене, и тем, что умеет воспроизвести симулятор, только растёт.
Идея: симулятор, который достраивает себя сам
Эту проблему взялась решать команда исследователей — Wonung Kim, Hyunmin Choi, Minsu Kim, Jaehong Cho, Yeongwook Kim и Jongse Park. Их препринт arXiv:2608.24650 (cs.AR, cs.AI) называется «Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems».
Главный разворот мысли здесь такой: не нужно писать очередной симулятор под конкретный набор сегодняшних механизмов — он устареет раньше, чем выйдет. Нужно построить Simthesizer так, чтобы он расширял себя сам, по мере появления новых требований. И не силами программиста, который месяц читает чужой код, а силами агента, который понимает постановку на естественном языке и умеет с ней работать внутри симулятора.
Один динамический граф вместо набора модулей
Техническая основа идеи — компонуемая инфраструктура. В Simthesizer весь рабочий процесс обслуживания выражается единообразно: не только сами вычисления, но и управляющие решения, которые этот процесс координируют, — то есть планировщик, порядок обработки, распределение ресурсов. Всё это описывается как один динамический граф, который меняется по ходу симуляции.
Практическая выгода понятна: когда новую функциональность не нужно прикручивать к жёстко прошитым стыкам между подсистемами, а достаточно добавить узел в общую картину, стоимость расширения падает на порядки. Именно здесь раньше и возникала «инвазивная переработка» — вся логика была размазана по коду, и любой новый механизм задевал половину симулятора.
Агент-синтезатор: запрос словами, а не форк кода
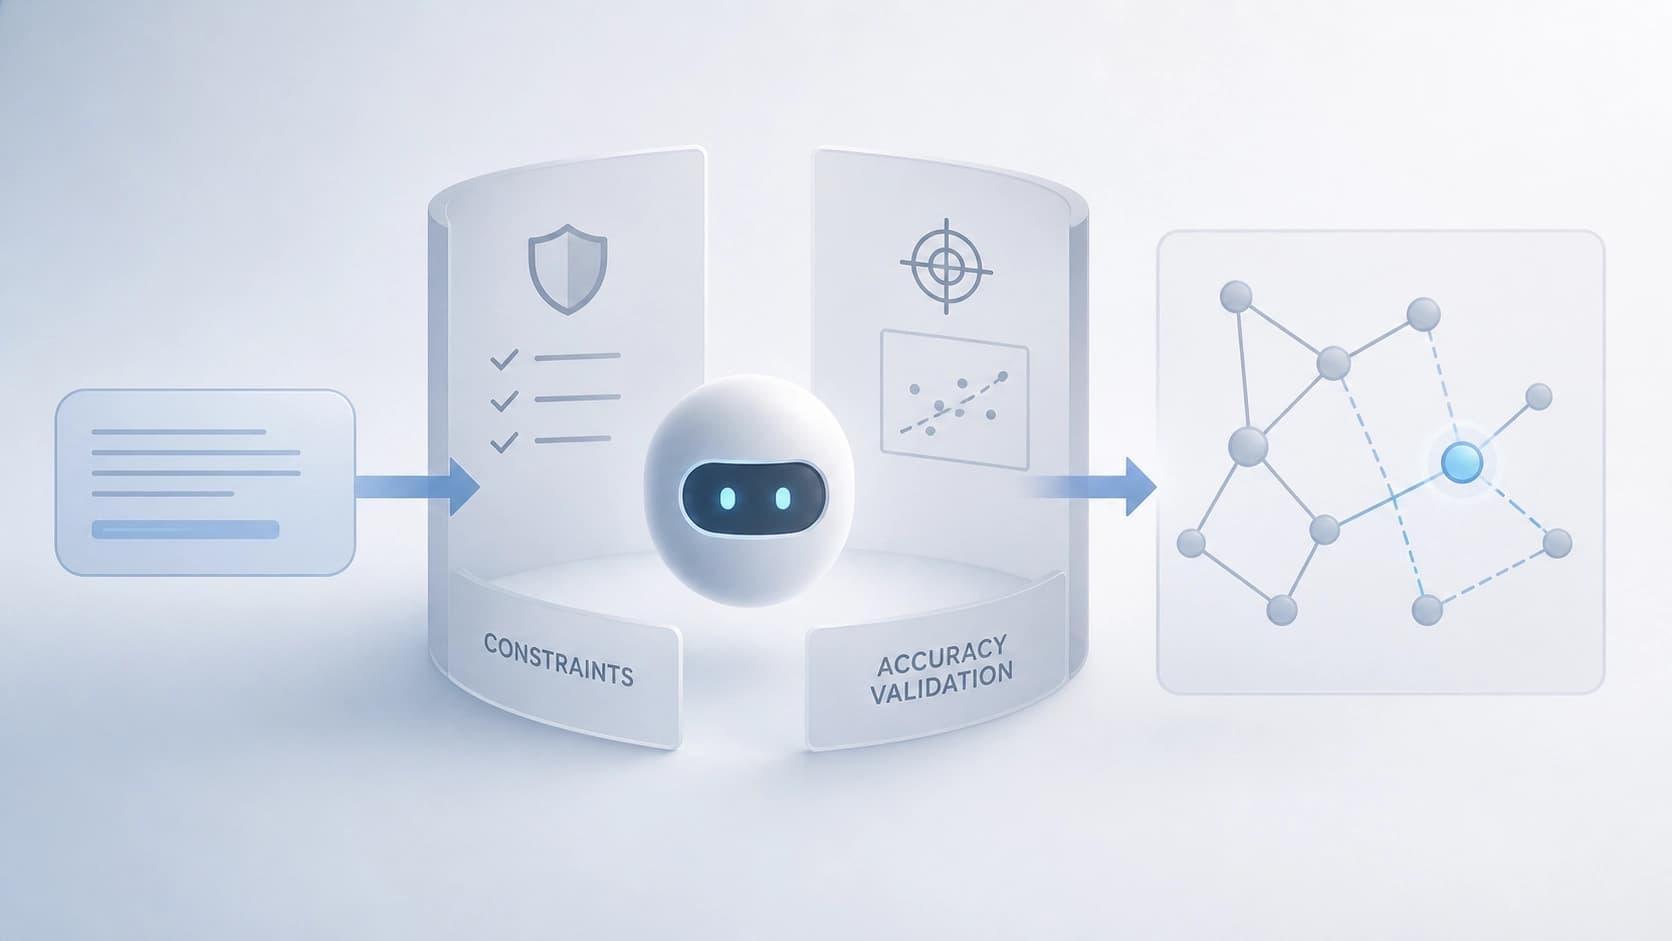
Второй элемент — Synthesizer agent, которого авторы описывают как «coding agent под упряжью» (harnessed coding agent). Его задача — переводить запросы о нужных функциях, сформулированные обычным человеческим языком, в то самое абстрактное представление внутри симулятора.
Ключевое слово тут — «под упряжью». Агент не пишет что хочет: он работает в рамках ограничений, специфичных для конкретного симулятора, и его результат проходит проверку на точность моделирования (fidelity validation). Без этого шага затея превратилась бы в генератор правдоподобного, но неверного кода. Ещё одна важная деталь: агент развивает один общий симулятор, а не плодит новый под каждую фичу — иначе мы бы просто получили тот же зоопарк несовместимых форков, только созданный автоматически.
Насколько это работает
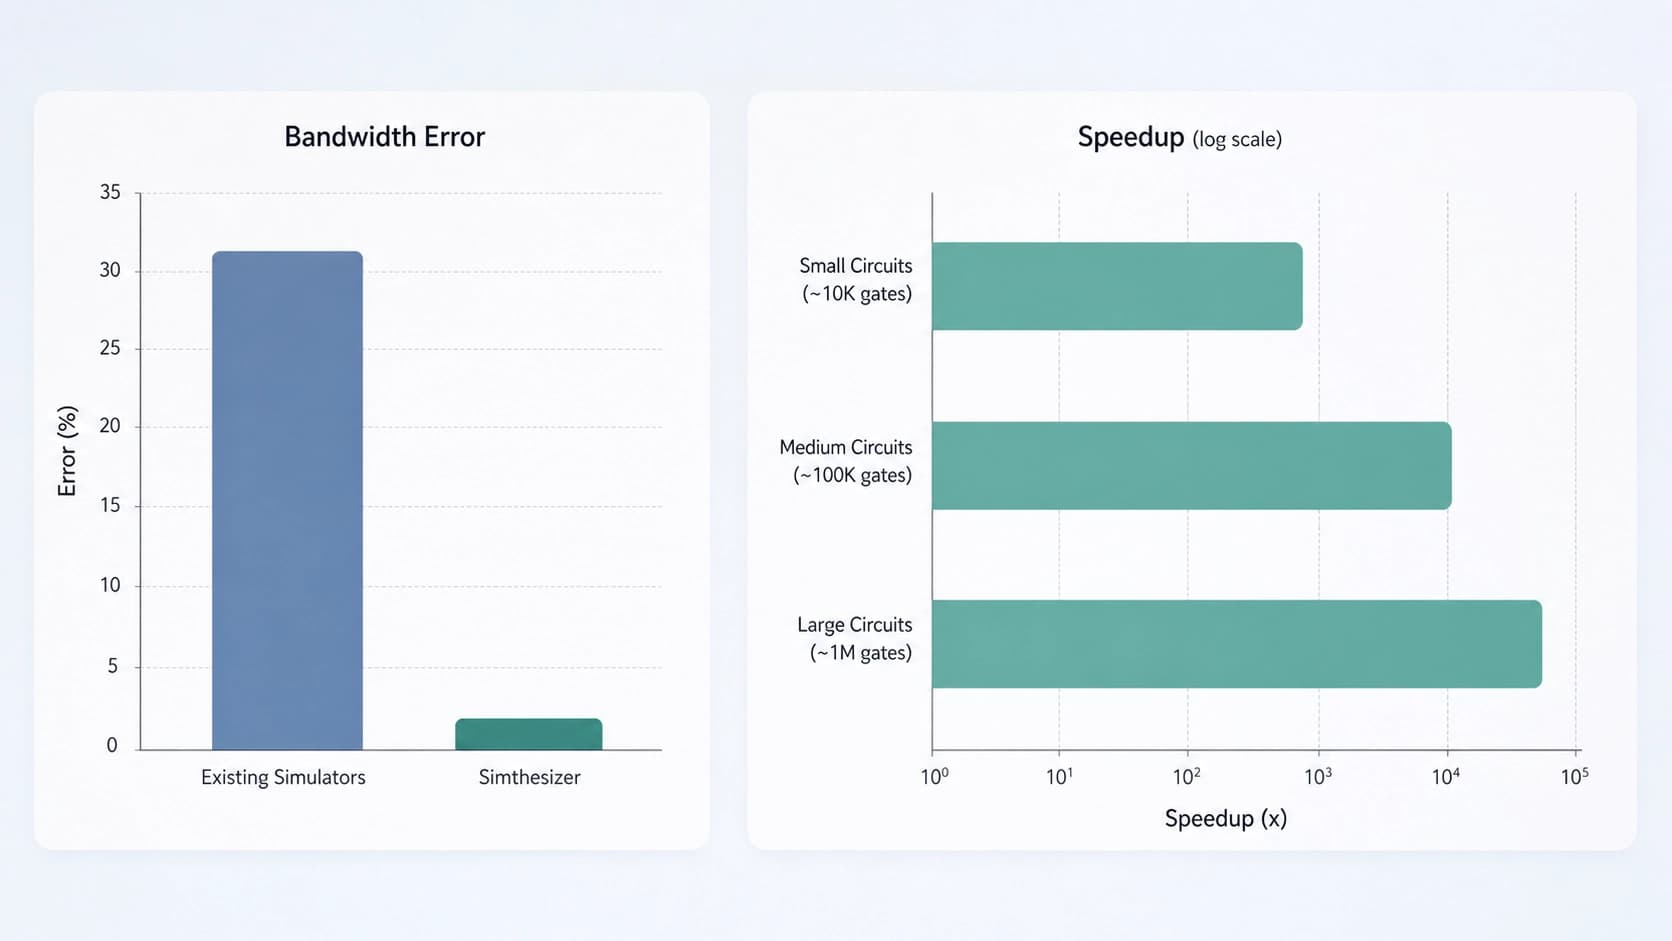
Авторы проверили подход не на синтетике, а на сравнении с реальностью. Расширения, построенные на Simthesizer, воспроизводили систему на базе vLLM со средней ошибкой по пропускной способности 2,51%. У расширений на существующих симуляторах та же метрика — 6,03%. Разница более чем двукратная, и при этом использовался один и тот же coding agent с одинаковой обвязкой: то есть выигрыш даёт именно архитектура симулятора, а не удачный подбор модели-исполнителя.
Скорость впечатляет не меньше. На идентичных рабочих нагрузках Simthesizer моделировал до 284,96 раза быстрее, чем LLMServingSim2.0, и до 23,19 раза быстрее, чем Vidur. Такие порядки меняют сам характер исследования: вместо «запустить один прогон и ждать» появляется возможность перебирать десятки конфигураций и сравнивать сценарии между собой.
Что это меняет и о чём стоит помнить
Если подход приживётся, сдвиг произойдёт не только в цифрах, но и в роли самого инструмента. Симулятор перестанет быть замороженным артефактом, который догоняет реальность с отставанием в год-два, и станет системой, которую можно подстраивать под новую задачу за один разговор. Для тех, кто проектирует inference-инфраструктуру, это означает более дешёвый цикл проверки гипотез: необязательно сначала собирать стенд, чтобы понять, окупится ли идея.
Но есть и вопросы, которые авторы оставляют за скобками. Насколько надёжно валидация точности ловит тонкие ошибки агента — например, когда новый узел формально работает, но незаметно меняет поведение при определённом сочетании нагрузки и таймингов? Как переносится подход на аппаратно-специфичные вещи вроде нестандартных акселераторов? И наконец, остаётся открытым вопрос доверия: когда симулятор всё чаще пишет себя сам, кто-то должен уметь читать то, что получилось.
Пока же результат простой и понятный: связка «компонуемая архитектура плюс ограниченный в правах агент» даёт и более точное, и заметно более быстрое моделирование, чем аккуратно вылизанные, но жёсткие симуляторы предыдущего поколения. Это ровно тот случай, когда правильнее было поменять не модель, а устройство инструмента.