
Проверяемые задания и дообучение на длинных траекториях: как Navalia усиливает кооперативных LLM-агентов
Работа описывает фреймворк, который на материале корпоративной финансовой отчётности строит вычислительные цепочки с прослеживаемыми свидетельствами, независимо их валидирует и затем применяет для SFT и RL. На базе Qwen3.6-35B-A3B такой конвейер даёт прирост на пяти бенчмарках и, по данным авторов, улучшает связывание свидетельств, применение инструментов и выполнение длинных задач, включая офисные сценарии.
Задача, которую решает Navalia
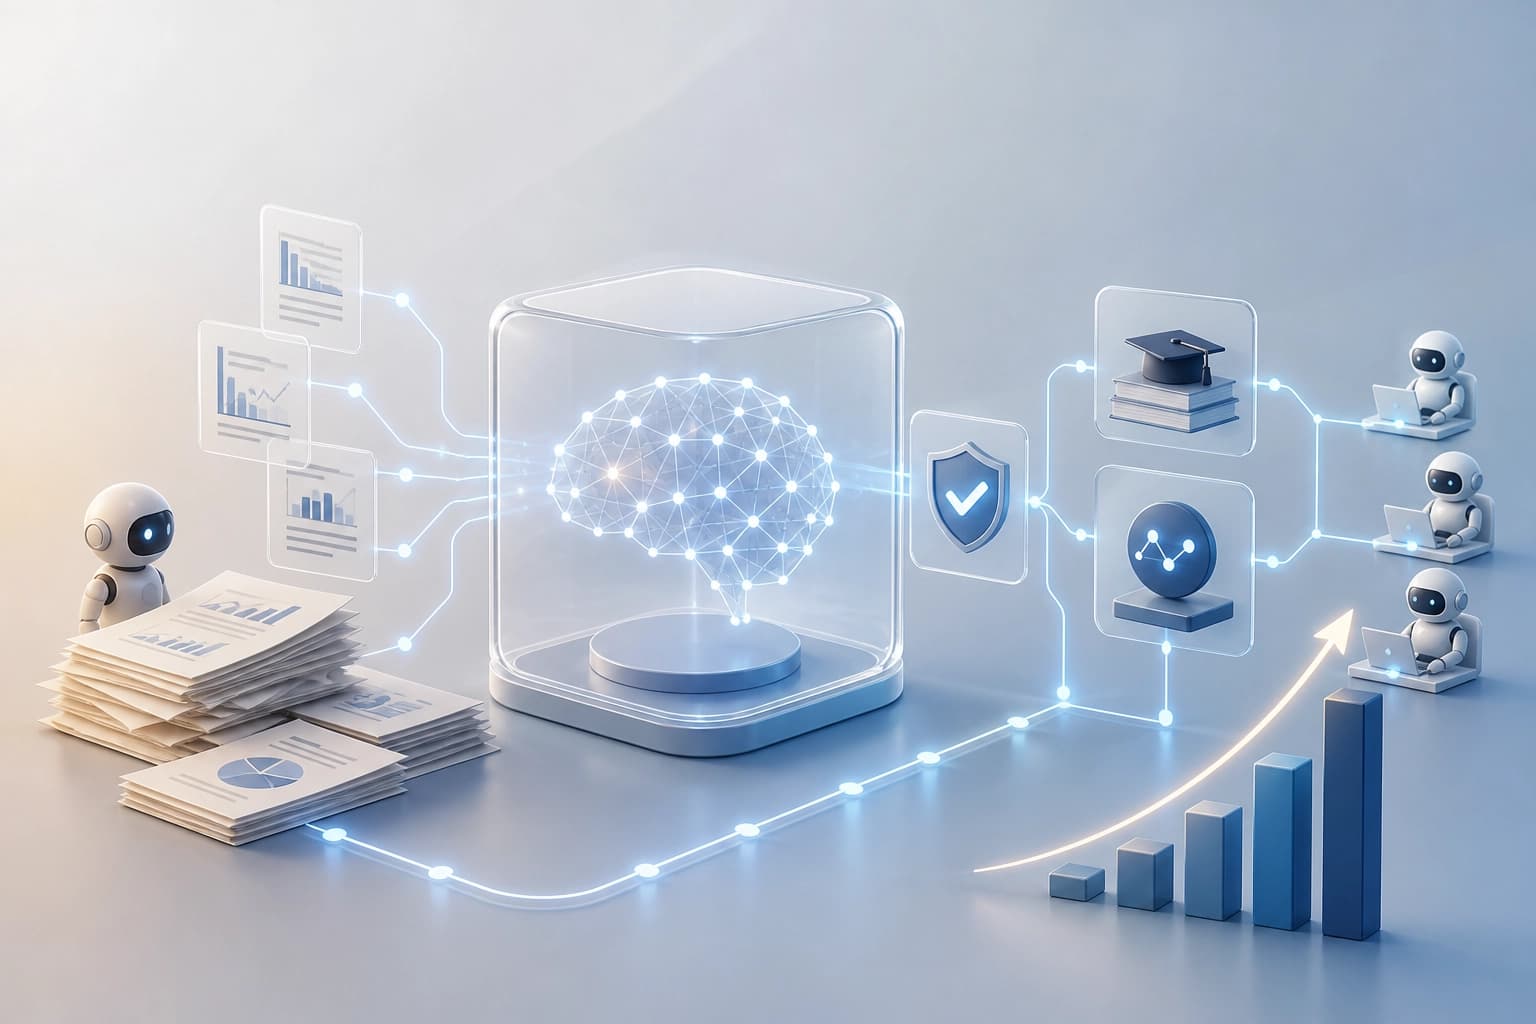
Navalia — фреймворк для Cowork Agents. Он сочетает синтез верифицируемых задач с постобучением на длинном горизонте. Для финансового анализа фреймворк использует корпоративные финансовые отчёты.
Navalia семантически отбирает подтверждающие свидетельства из полных наборов фактов. Затем строит исполняемые вычислительные цепочки. Так фреймворк создаёт аналитические задачи с прослеживаемыми свидетельствами и фактическими зависимостями данных между шагами.
Практический критерий: задача подходит для верифицируемого синтеза, если у неё есть прослеживаемые свидетельства и зависимости между шагами.
Проверка свидетельств и ответов
Согласованность свидетельств и правильность ответов проверяют независимой проверкой LLM и программными проверками. Это два разных контура контроля. Первый оценивает смысловую сторону, второй — формальную правильность.
Практический критерий: для верифицируемой задачи нужны и LLM-проверка, и программные проверки.
Постобучение на длинных траекториях
Проверенные задачи дают материал для сбора траекторий. Navalia применяет supervised fine-tuning с холодного старта и reinforcement learning. Оба этапа улучшают выполнение задач на длинном горизонте.
Фреймворк, инициализированный на Qwen3.6-35B-A3B, показывает устойчивый прирост по сравнению с базовой моделью. Прирост виден на всех пяти бенчмарках. Авторы сообщают, что Navalia улучшает интеграцию свидетельств, использование инструментов и выполнение задач на длинном горизонте.
Практический критерий: постобучение имеет смысл, когда задача требует длинной цепочки действий и использования инструментов.
Бенчмарки и перенос результатов
Оценка Navalia проходит на пяти бенчмарках. Это OfficeQA Pro, FinSearchComp, Finance Agent Benchmark, APEX-Agents-AA и Workspace-Bench-Lite. На всех пяти фреймворк показывает устойчивый прирост по сравнению с базовой моделью.
Авторы сообщают о переносе результатов на более широкие сценарии Cowork. В их числе общие офисные задачи. Практический критерий: смотреть на перенос навыков за пределы финансового анализа. Общие офисные задачи — признак более широкой применимости.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Физический ИИ: границы понятия, инструментарий и трудные места
Монография объёмом 388 страниц собирает в единую рамку определения физического ИИ, его отличия от смежных областей и основные методы — от восприятия и симуляции до управления и координированных многоагентных систем. Из неё можно получить карту исследовательских задач и ограничений, которые мешают перейти от специализированных решений к системам с широкой обобщаемостью.
17 ноября 2026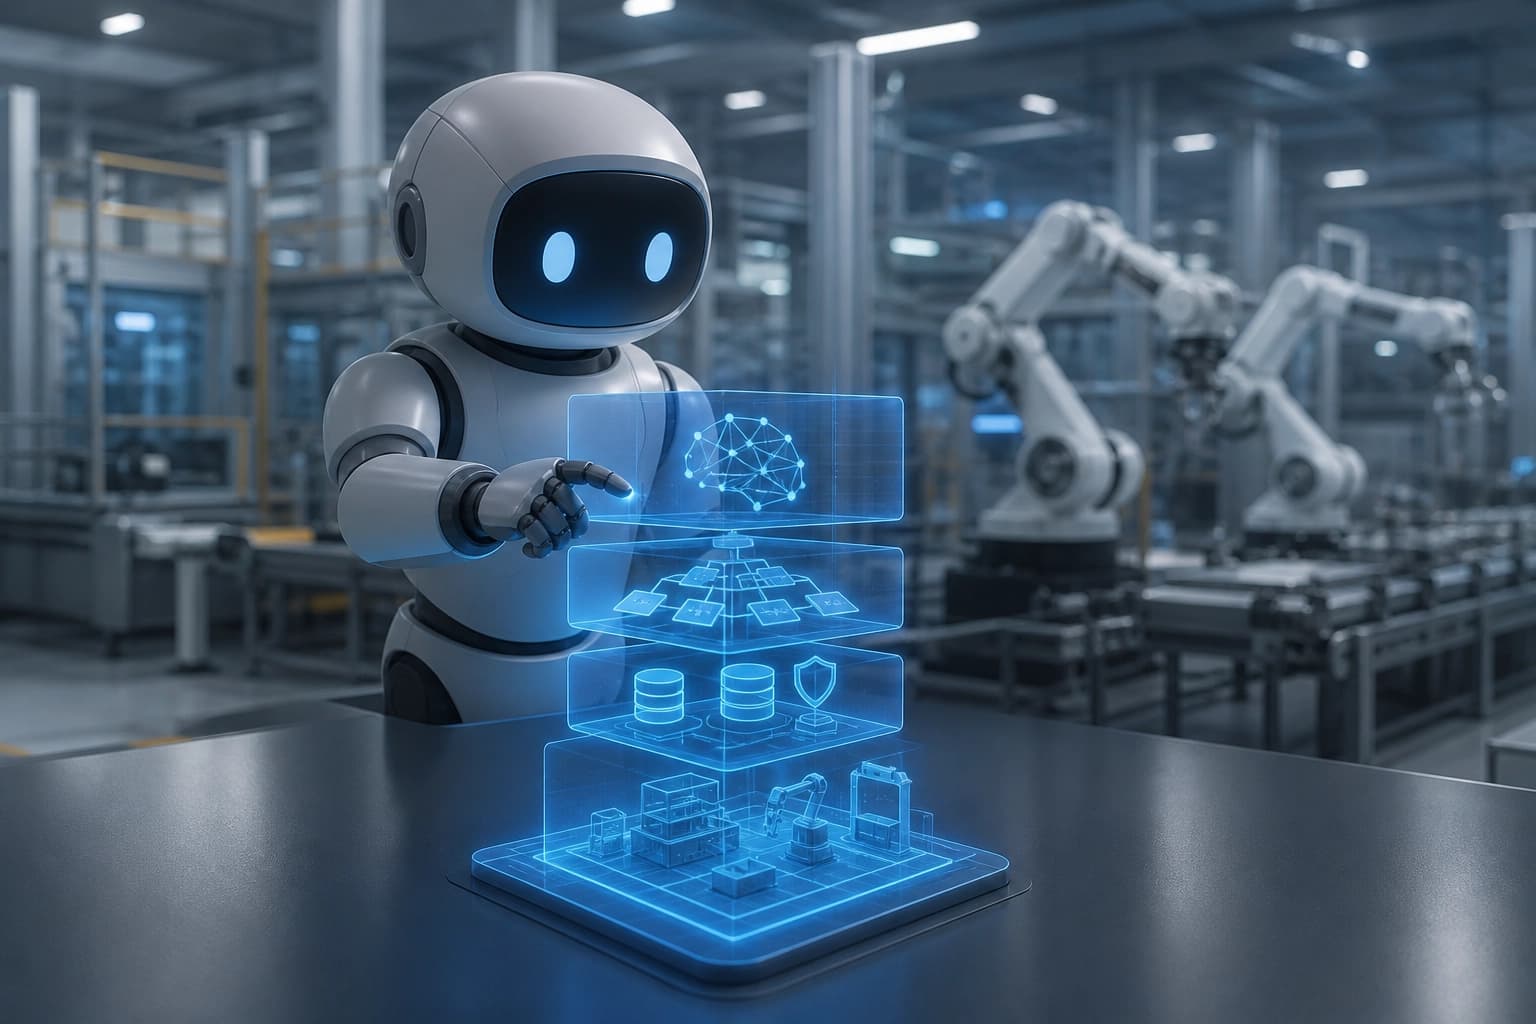
LLM-агенты на производстве: таксономия, архитектура и ограничения внедрения
Статья систематизирует исследования о применении больших языковых моделей в производственных агентах: выделяет препятствия, уровни возможностей и четырёхслойную архитектуру. Из неё можно понять, какие сценарии жизненного цикла уже рассматриваются и где сохраняются разрывы для надёжного автономного планирования.
17 ноября 2026
Подход OWP: перераспределение свидетельств и априорных сигналов в Omni-LLM
Предлагается не требующий обучения фреймворк Omni-Woodpecker, который выявляет конфликты между модальностями и перед декодированием меняет баланс между данными контекста и заученными приорами в скрытых состояниях. На Qwen2.5-Omni-7B и VideoLLaMA2-AV метод повышает устойчивость к аудиовизуальным ошибкам на CMM и AVHBench, а на общих бенчмарках рассуждений даёт умеренный прирост.
17 ноября 2026