
Подход OWP: перераспределение свидетельств и априорных сигналов в Omni-LLM
Предлагается не требующий обучения фреймворк Omni-Woodpecker, который выявляет конфликты между модальностями и перед декодированием меняет баланс между данными контекста и заученными приорами в скрытых состояниях. На Qwen2.5-Omni-7B и VideoLLaMA2-AV метод повышает устойчивость к аудиовизуальным ошибкам на CMM и AVHBench, а на общих бенчмарках рассуждений даёт умеренный прирост.
Что такое OWP и какую проблему решает
Omni-Woodpecker (OWP) — training-free framework для коррекции межмодальных галлюцинаций у Omni LLMs. Метод переносит коррекцию с уровня выходных данных на перебалансировку представлений, обусловленную конфликтом модальностей. Авторы подали статью 19 октября 2026 года: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
Традиционная коррекция работает с готовым ответом. OWP вмешивается во внутренние представления до декодирования. Это меняет точку приложения метода.
Вывод: OWP меняет точку коррекции, а не правит готовый ответ.
Этапы перераспределения свидетельств и априорных сигналов
OWP выполняет перебалансировку в несколько этапов. Сначала метод выявляет межмодальные конфликты по дополнительным представлениям отдельных модальностей.
- Выявление межмодальных конфликтов по дополнительным представлениям отдельных модальностей.
- Ортогональное разложение скрытых состояний для отделения grounding-свидетельств от конкурирующих априорных оценок.
- Адаптивная перебалансировка объединённых представлений: подавление вводящих в заблуждение априоров и восстановление проигнорированных свидетельств.
- Передача исправленных представлений в декодирование.
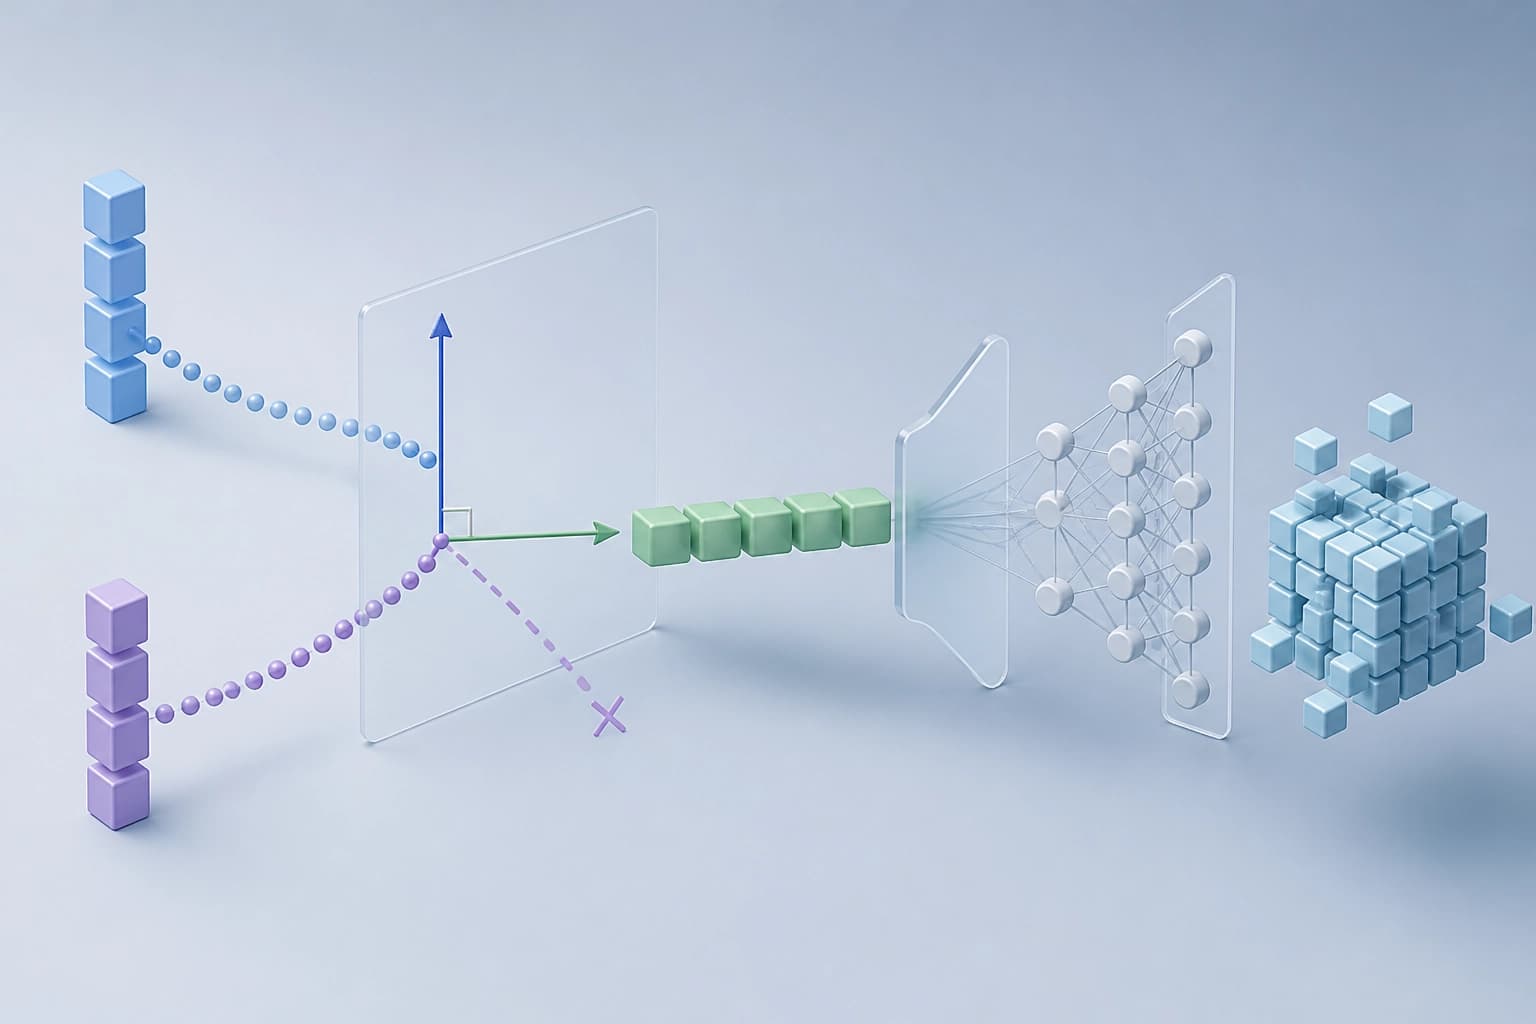
Метод не меняет веса модели. Он корректирует представления перед генерацией.
Вывод: OWP не требует обучения и правок весов. Он воздействует на скрытые состояния до декодирования.
Результаты: приросты на бенчмарках и переносимость
На Qwen2.5-Omni-7B OWP повышает результаты на 12,9 и 8,6 пункта на CMM и AVHBench. На четырёх общих бенчмарках рассуждений OLLM прирост составляет 0,67–2,25 пункта.
| Модель | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 пункта | +8,6 пункта |
| VideoLLaMA2-AV | +4,6 пункта | +3,9 пункта |
Метод показал переносимость на VideoLLaMA2-AV: улучшение на 4,6 и 3,9 пункта на CMM и AVHBench. Авторы сообщают об эффективности и переносимости между архитектурами. Код публично доступен.
Вывод: прирост зависит от модели и бенчмарка. Практический критерий: перед внедрением стоит проверить OWP на своей архитектуре и целевом наборе задач.
Практические критерии выбора OWP
OWP подходит при нескольких условиях. Метод работает без обучения и без изменения весов модели.
- Нужна коррекция межмодальных галлюцинаций без обучения.
- Доступны скрытые состояния и представления отдельных модальностей.
- Требуется вмешательство до декодирования, а не постобработка ответа.
- Есть возможность воспроизвести метод: код публично доступен.
OWP — training-free способ перебалансировать свидетельства и априорные сигналы. Авторы заявляют переносимость между архитектурами. Проверка на конкретной модели остаётся обязательным шагом.
Часто задаваемые вопросы
Похожие материалы
Все материалы
LightCRS: компактная мультидоменная схема диалоговых рекомендаций без отдельной VLM на категорию
Авторы представляют систему, где товарные мультимодальные признаки считаются офлайн замороженными энкодерами, а в диалоге их обрабатывает общий для всех доменов модуль на 5,3 млн параметров с cross-attention, зависящим от запроса. На бенчмарке из 25 доменов подход улучшает средние метрики ранжирования, заметно снижает задержку и показывает, что совместное обучение даёт прирост относительно отдельных однодоменных моделей.
16 ноября 2026
Ограниченный ремонт тактик в Lean 4 с опорой на диагностику компилятора
Предлагается пошаговый модуль, который не отбрасывает отклонённую тактику, а до R раз поручает модели-корректору исправить её с учётом ошибки Lean; при K кандидатах это повышает долю решённых задач. Опыты на LeanDojo и Lean Workbook показывают прирост в основном за счёт неглубоких сбоев исполнения, ценой увеличения времени поиска.
16 ноября 2026
Метод Genesis Steering: активационное управление на данных, использованных при дообучении
Метод выводит вектор управления из контрастных примеров, присутствовавших в данных дообучения, а при их недоступности отбирает вероятные обучающие образцы через membership inference и формирует прокси-набор. Теоретическая часть описывает оптимальное смещение к границе решения и оценку по прокси-данным; эмпирически внутренние данные Tülu-3-8B дают более выраженный эффект, чем внешние наборы, тогда как полезность MIA-прокси на Llama-3.1-8B-Instruct ограничена соотношением сдвигов направления.
16 ноября 2026