
工作记忆:当重要的不是数字,而是量值
在脑中保持一个连续变量——旋转角度、速度、光标位置、按压力度——并平滑地对其微调:这大概是对工作记忆最诚实的测试。记住一个“七”并不难,但要维持一个没有天然边界、能够偏移任意微小比例的连续量值,则是完全不同级别的任务。
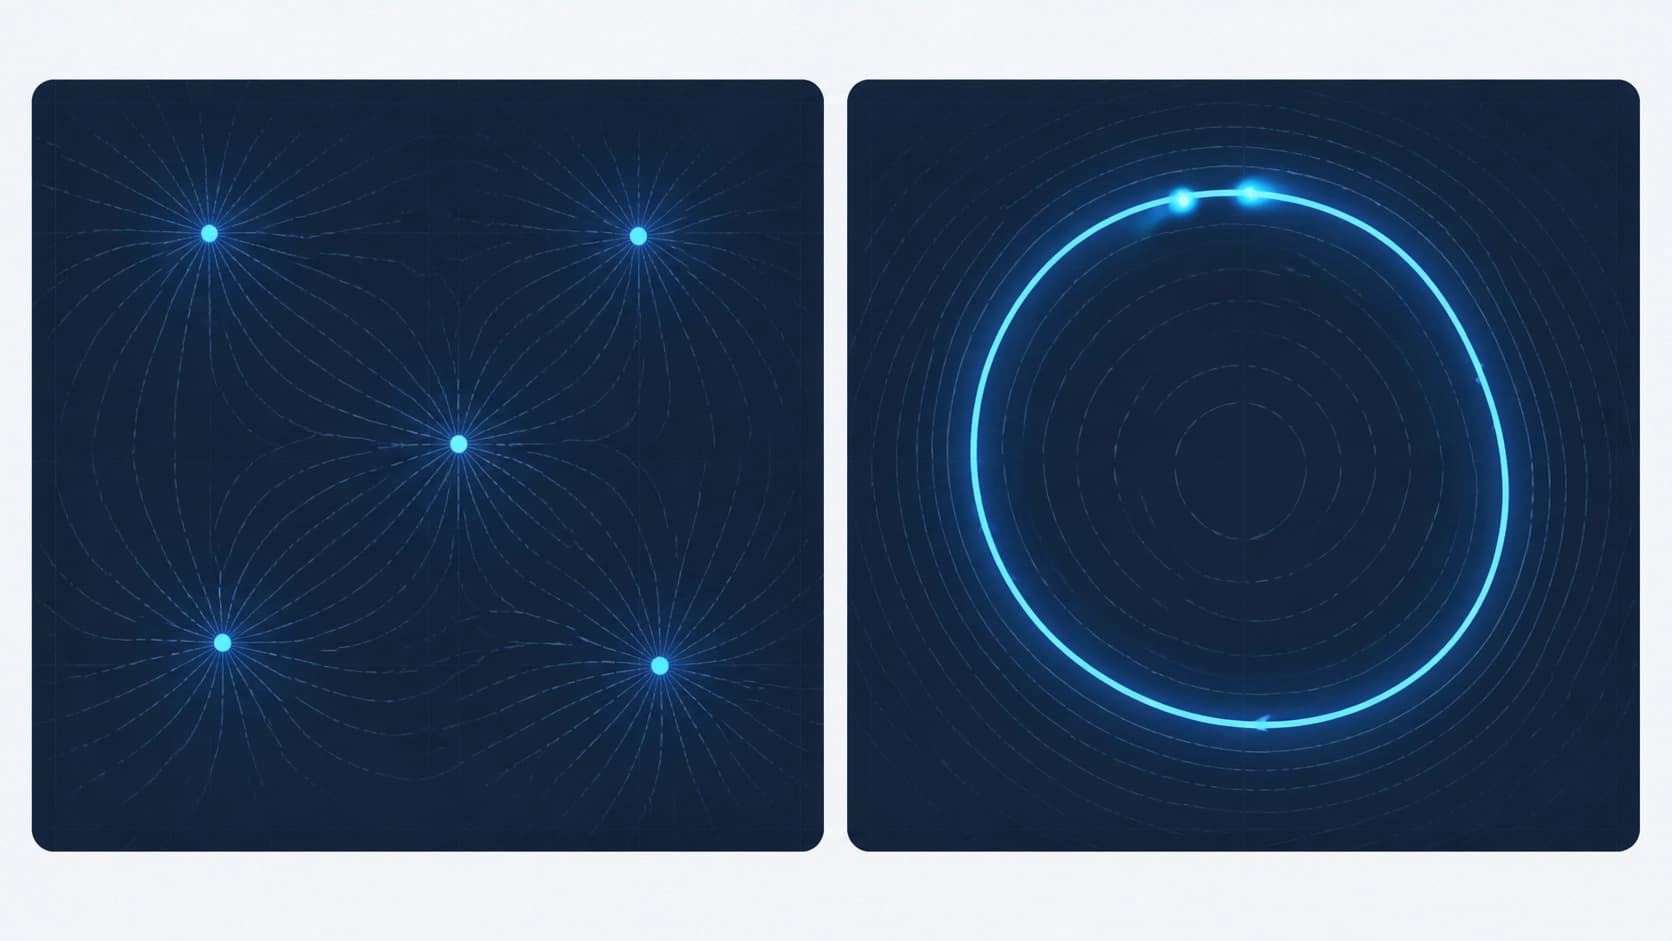
人工神经网络与它的关系历来紧张。具有连续吸引子的模型——即稳定状态构成的不是一小撮孤立点,而是一个光滑曲面——靠的只是空口承诺:参数稍微一挪,行为就土崩瓦解。
为什么常见的循环架构会“量化”状态
标准的循环方案,包括 GRU 和 LSTM,通常学不会连续流形。它们不是形成连续统,而是把状态空间切分成离散的点吸引子:网络仿佛把输入四舍五入到最近的“架子”上。对分类来说这很方便,对定量估计来说则是死刑判决。
一个研究团队(Zhaotian Gu、Jie Su、Weiwei Wang、Chang Liu、Tianyi Qian、Dahui Wang)提出,治疗这一问题不靠把架构搞得更复杂,而是靠一个具体的计算技巧。该工作发表于 Transactions on Machine Learning Research(2026 年 8 月),预印本见 arXiv:2608.01947,属于 q-bio.NC、cs.AI 和 cs.NE 分类。
用除法代替减法:一个最小模型
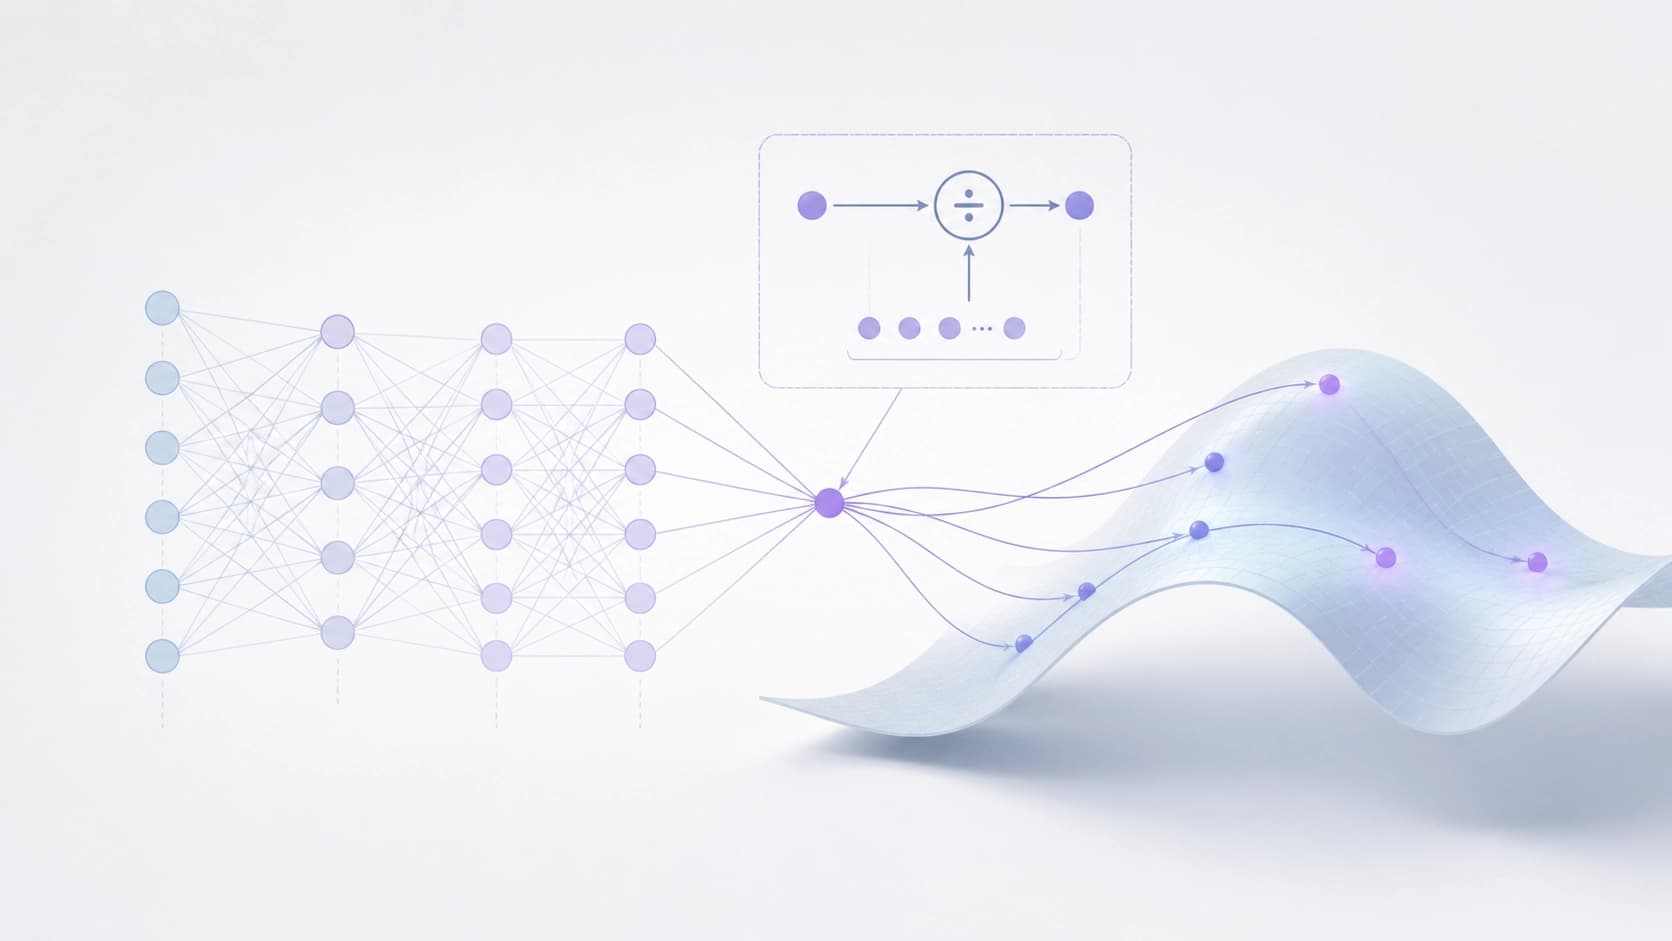
灵感来自神经生物学。除法(divisive normalization)是皮层回路中普遍观察到的一种典型运算,作者围绕它构建了一个最小化、代数上可分离的循环网络——循环除法归一化网络,简称 RDNN。内部没有任何多余的东西:只有除法的动力学以及随之而来的一切。
接下来是计算神经科学的标准套路:在经典工作记忆任务上做动力系统分析。而在这里,生物物理约束出人意料地变成了优势。网络收敛到稳定的慢流形,而且精度很高:轨迹不会发散,而是落在一条狭窄的曲面上,并平稳地在其上移动。
梯度发生了什么
这项工作的另一个独立话题是剖析通过时间反向传播(BPTT)的学习过程。除法引入了依赖于当前活动的局部梯度缩放:某个单元被激活得越强,它分到的参数更新就越小。这就形成了一个内置的刹车,恰好在该起作用的地方起作用。
效果是可观察的:网络的有效秩明显自我压缩,循环动力学被锁在一个狭窄的低维子空间里。同时作者强调这与显式低秩分解的区别——在那里,类似的约束常常导致优化上的病态,而在这里,它是自发产生的,是活动的副产品。
消融实验:没有除法,流形就会瓦解
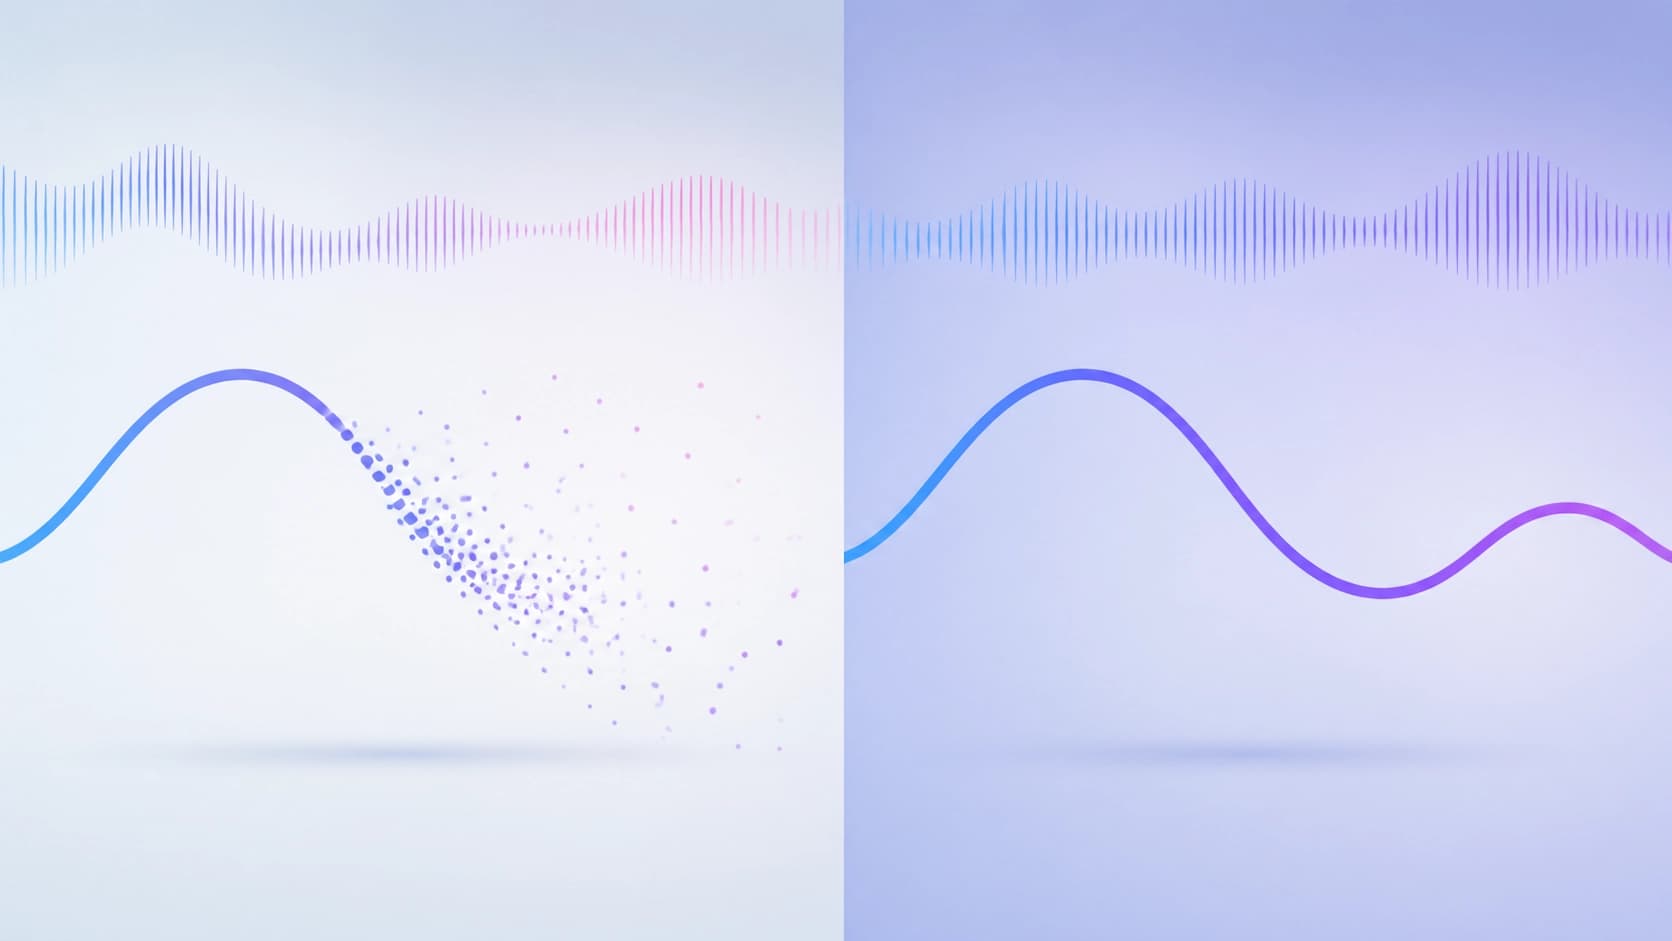
最有说服力的部分是与减法抑制的对比。这种替换能够保持静态记忆:维持一个不动点不成问题。但一旦输入信号开始随时间变化,流形就会“碎裂”(manifold shattering)——连续性恰恰在最需要它的地方消失了。
由此得出一个值得记住的结论:除法不是从皮层继承来的生物学奇观,而是一种有效的计算机制。它让网络学会高精度的连续表征,而不只是规整的离散化。
在实践中该如何应用
实际意义不在于赶紧重写所有循环模型。它更像是一个提醒:归一化不仅关乎训练稳定性,也不仅关乎正则化。它是一种设定内部状态空间几何的方式,而除法在这方面相对减法有明确的优势。
如果任务需要维持一个连续量值并平滑地更新它——在控制中、在追踪中、在任何涉及“多少”而非“哪一个”的系统中——那么值得关注采用乘法归一化的方案。代价极小,而作为回报,网络不再去四舍五入那些本不该被四舍五入的东西。


