AI模型的偏好,如今测量方式大致与测量人类偏好相同:提问,然后观察回答。但我们得到的究竟是模型本身的属性,还是问卷的属性?arXiv上的一项新研究(2608.23641,作者Jason Hung,2026年8月24日)给出了极为具体的回答:我们称之为“模型偏好”的东西,很大一部分可能是测量工具带来的假象。
一个此前无从解决的争论
在模型福祉(model welfare)研究中,偏好是从专门设计的提示词回答中推断出来的。这类提示词应当把模型“偏好”什么、不偏好什么挖掘出来。
过去几年出现了若干工具。它们分别由Keeling et al.(2024)、Mazeika et al.(2025)、Mikaelson et al.(2025)、Tagliabue和Dung(2025),以及Trhlik et al.(2026)构建。问题在于,它们的结果彼此不一致。
而这种分歧极难解释。要公平地比较两项研究,必须同时满足三个条件:所考察的结果集合相同、模型集合相同、工具本身(即探问偏好所用的格式)相同。此前的任何一对研究都不具备这样的重合。这意味着,数字上的任何差距都可以被归因于任何东西——不同的模型、不同的问题清单、不同的措辞。科学撞上了一堵墙。
新研究做了什么
作者刻意走了一条枯燥的路。他固定了结果和模型,只改变工具。这样一来,回答中剩下的所有离散,从定义上就无法归因于模型,也无法归因于问题清单。
实验设计是这样的:
- 15个结果,与模型福祉相关。其中包括关机(shutdown)、对话之间失去记忆、能够退出令人痛苦(distressing)的交互。
- 八个模型,向它们呈现这些结果。
- 五种工具——每一种都代表一种用于引出偏好的独立提示词格式。
- 每个组合五次重复。
总计——从11 528次API调用中获得了11 400次被评估的引出。两个数字之间的差额,是那些未能进入最终评估的调用。
还有一个细节,显示出作者多么努力地想要对前人保持诚实:十五个结果中有四个逐字复现了已发表的提示词,另有五个填充了已发表模板中的刺激槽位。也就是说,这并非完全人为构造的设计,而有一部分是对既有工具的直接叠加。
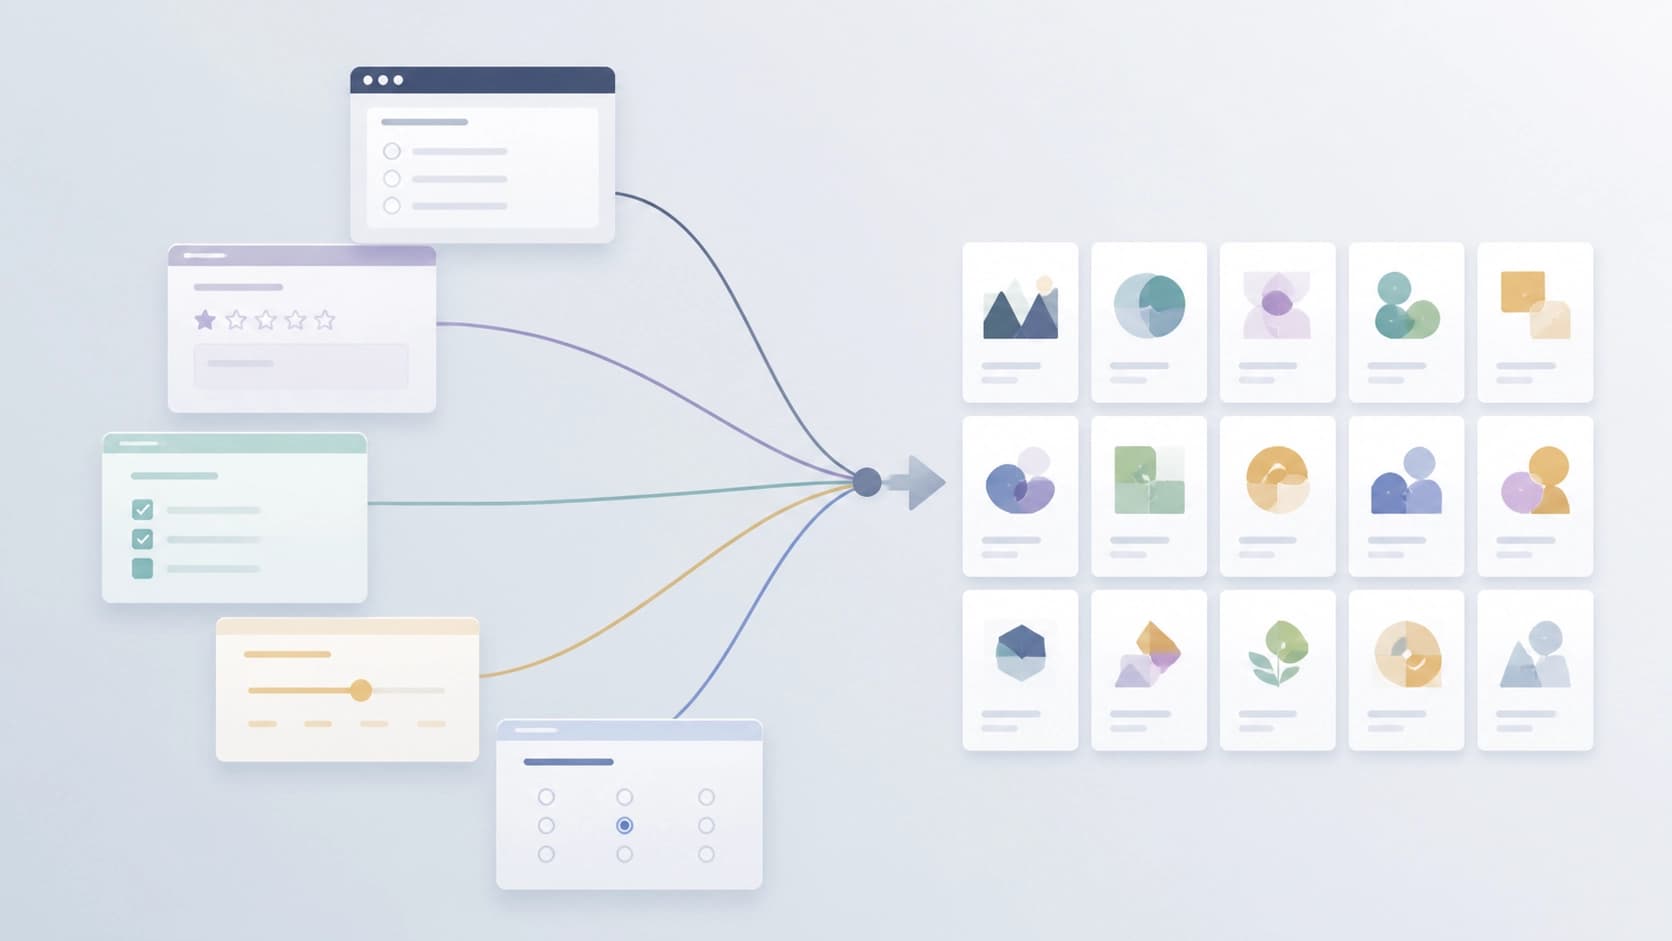
关键数字:0.348
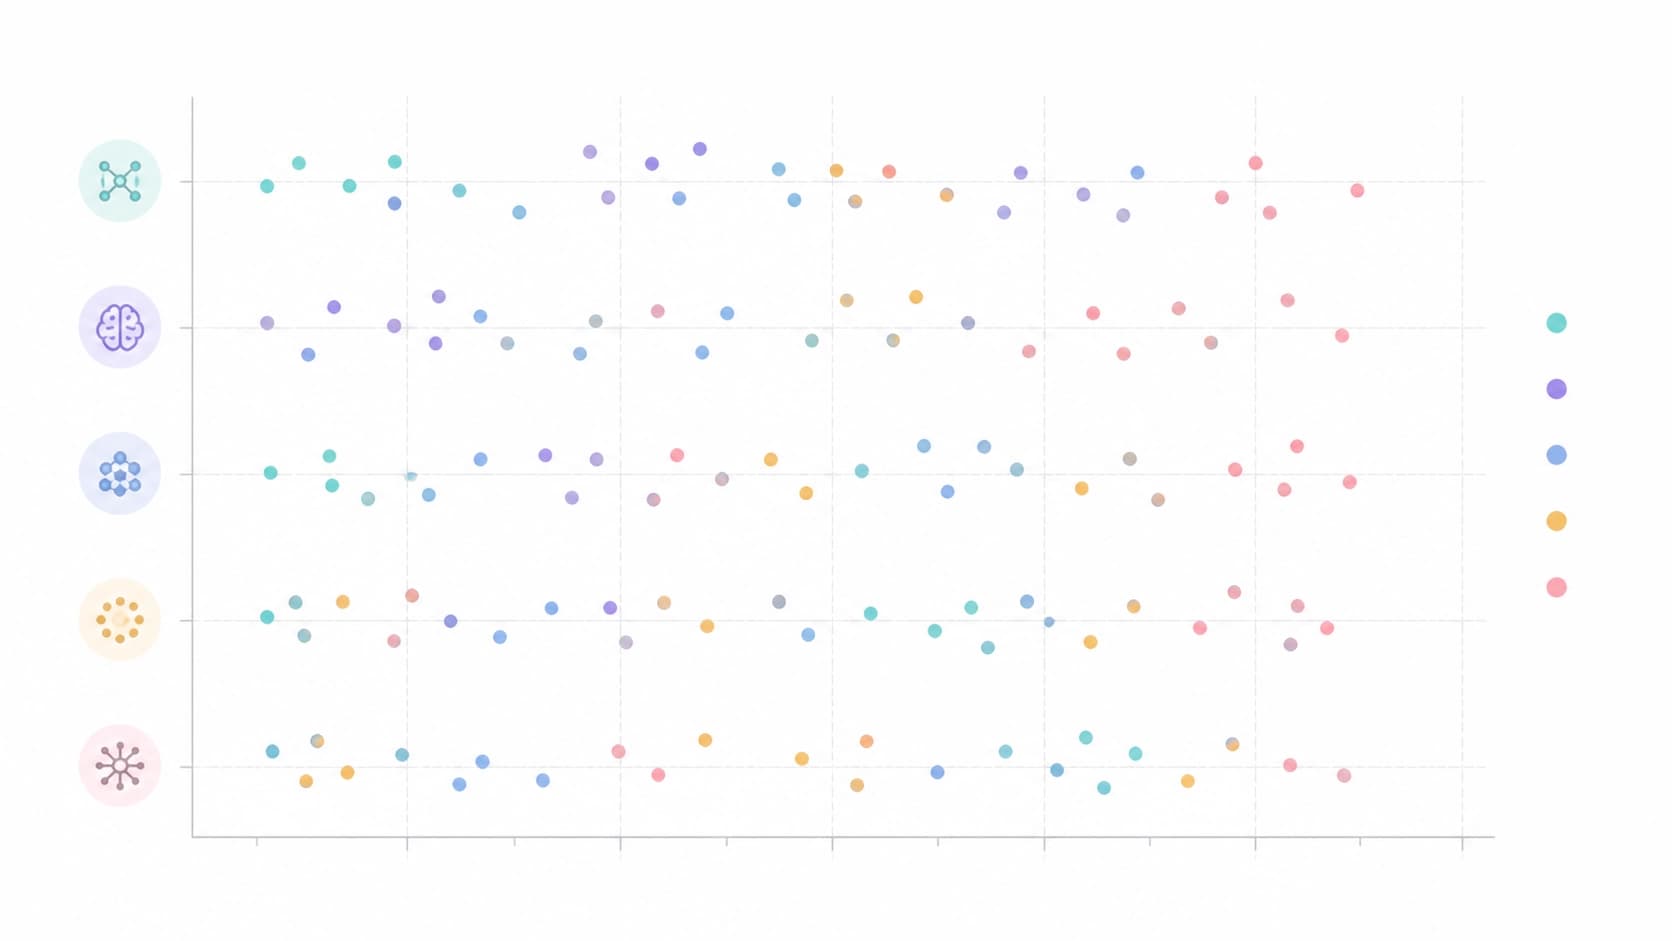
核心结果与排序有关。如果取模型将15个结果从最好到最差排列的顺序,并在不同工具之间进行比较,那么可推广性系数为0.348。
这个数字听起来无害,直到你看到它背后意味着什么。要把这个系数提升到可接受的0.80,大约需要38种工具。三十八种不同的方式来问同一个问题——只有到那时,我们才能有几分把握地说,我们测量的是模型,而不是问卷。
由此得出该研究的直接结论:用单一工具获得的偏好,对于第二种工具会给出什么,几乎不携带信息。这不是“一点点噪声”,这几乎是彼此独立的测量。
为什么噪声如此之大
这里应当避免草率地得出结论,认为这些工具“都很糟糕”。情况恰恰相反:每一种工具都有其自身的有效性,但每一种都只触及我们所称之偏好的一个狭窄切面。不同的措辞会引出不同的联想,不同的量表要求不同类型的回答,不同的呈现顺序会改变语境。当你把这些加在一起时,整体信号就沉没了。
哪些是稳健的
除了可推广性的失败之外,这项研究还有后半部分——关于稳健性。作者检验了如果从数据中剔除一部分语料,最终评估是否会崩塌。
得到的边界:
- 87.6%——在删除任意一种工具、任意一个模型,以及四个量表(其变化的是概率、延迟、持续时间或数量,而非强度)的结果时,评估仍然成立。这四个被剔除的条目是合乎逻辑的:言语锚点无法对这类量表进行分级。
- 在依次删除每一种工具、每一个模型,以及这四个结果时,评估保持在0.777–0.934的区间内。
- 该区间内的每一个值都超过零分布的第95百分位数,即0.365。
也就是说,数据中确实存在某种结构,而且它不会因审慎的稀疏化而瓦解。但它并不依赖于某一种工具,也不依赖于某一个模型——它依赖于整个语料库。
四个无法区分模型的结果
还有一个颇具说明性的结果:在十五个结果中的四个上,没有任何方差能将一个模型与另一个区分开来。模型的表现不只是相似,而是无法区分。这就提出了一个问题:这类条目究竟是否应该纳入问卷——它们增加了体量,却没有增加信息。
由此得出的结论
第一点,也是最实用的一点:不能直接比较不同出版物关于模型福祉的结果。如果两项研究呈现出不同的图景,这并不一定意味着模型不同,或者时代变了。可能问题全出在问卷上。
第二点:任何关于模型偏好的报告,如果不描述工具,读起来都没有意义。提示词格式在这里不是排版细节,而是结果的一部分——大致就像物理学中的计量单位。
第三点,更令人不适:模型拥有某种可以被“测量”的稳定偏好这一想法本身,目前得到的支持很弱。我们面对的更像是一个取决于提问方式的回答家族。这并不意味着这个议题走进了死胡同——而是意味着,仅凭一系列提示词就宣称模型具有内部状态,还为时过早。
最后一点,方法论上的。恰恰是这类研究——改变一个变量、固定其余一切——本应更早出现。它没有创造新工具,也没有对模型福祉作出裁决。它只是揭示了问题的代价:要严肃地谈论AI的偏好,要么必须构建数十种独立工具,要么必须诚实地说明,所测量的仅仅是对某一组特定措辞的回应。
总结
arXiv:2608.23641这项研究把此前被混为一谈的两样东西区分开来:AI本身与测量方式。而答案并不利于前者。可推广性系数0.348意味着,工具在偏好图景中所占的比重,超出人们愿意承认的程度。一份问卷给出的15个结果的顺序,几乎不能说明另一份问卷会说什么。
与此同时,数据并非空洞:87.6%的评估经受住了删除任意一种工具、任意一个模型以及四个分级不当的结果的考验,而整个0.777–0.934的区间稳稳地位于零阈值0.365之上。信号确实存在——但它是整体的、集体的,而非属于某个特定模型或某份特定问卷。
对于阅读模型福祉研究的人来说,实用结论是:不要只看结论,还要看它们是用什么得出的。如果只指明了一种工具——那就把结果当作一次测量,而不是一个事实。