工具已在实验室中——问题在别处
语言模型在科研工作中已不再是什么稀罕事。文献综述、假设草稿、数据处理代码、形式化推导的验证——这一切都已融入日常。但便利随之而来的,是一个无法靠设置和规章解决的问题:如果推理的一部分由机器完成,那么在什么条件下,结果仍然可以被称为知识,而不只是看似合理的文本?
这正是 Kalin Stoyanov 在论文《Ethical LLM-Assisted Research》(arXiv:2608.23644,2026年8月24日)中提出的问题。这不是又一次"谨慎使用AI"的呼吁,而是试图构建一个规范性与概念性的框架——也就是一种语言,用来严格讨论认知工作的委托。
核心前提是:科学推理是一个分布式过程。它的贡献可以来自不同来源,人类的和机器的,比例任意。但最终进入科学记录的内容,其责任仍然属于人类。因此,"论文中允许有多少AI"这个问题本身就提错了。正确的问题应该是:为了让结果保持正当性,人类必须具体做什么。
五个变量,而非一个模糊的"AI参与度"
通常争论都归结为一个百分比:人写了多少,模型写了多少。该框架提出将其拆解为五个独立的构念。每一个都可以独立于其他而变化。
- 内容来源(O(g))——某个具体论断是由谁或什么产生的。
- 人类验证的完成度(V(g))——验证是否由活生生的研究者进行到底。
- 责任归属(R(g))——接受该论断的决策负担被归于谁。
- 可问责的人类归属(M(g))——谁在"愿意为其辩护并承担责任"的意义上拥有该论断。
- 认识论结果(E(g))——从知识增长的角度看,验证带来了什么。
这种区分看起来近乎迂腐,但它堵住了一个人人都在利用的漏洞。来源、验证、结果和责任是不同的事情,不能相互推导。文本可能由机器生成,但为其负责的仍然是人——这很正常。也有相反的情况:形式上一切都是作者写的,但验证是走过场,知识最终并未增长。
为什么不能靠"我都检查过了"敷衍了事
"我读过并且同意"这句话不是验证。它没有记录具体检查了什么、基于什么依据、以及已确认与信以为真之间的界限在哪里。V(g) 这个构念恰恰要求验证的完成,而非其声明。这一点很重要,因为 LLM 辅助的推理在外观上几乎与普通推理无异:文本流畅,论证连贯,参考文献看起来是真的。
界限在于验证,而非机器贡献的多少
该论文的核心论点是:伦理界限由充分的验证和可问责的人类归属决定,而非由机器的参与程度决定。也就是说,委托这一事实本身在伦理上是中性的。只有当验证流于形式、责任模糊不清时,它才成为问题。
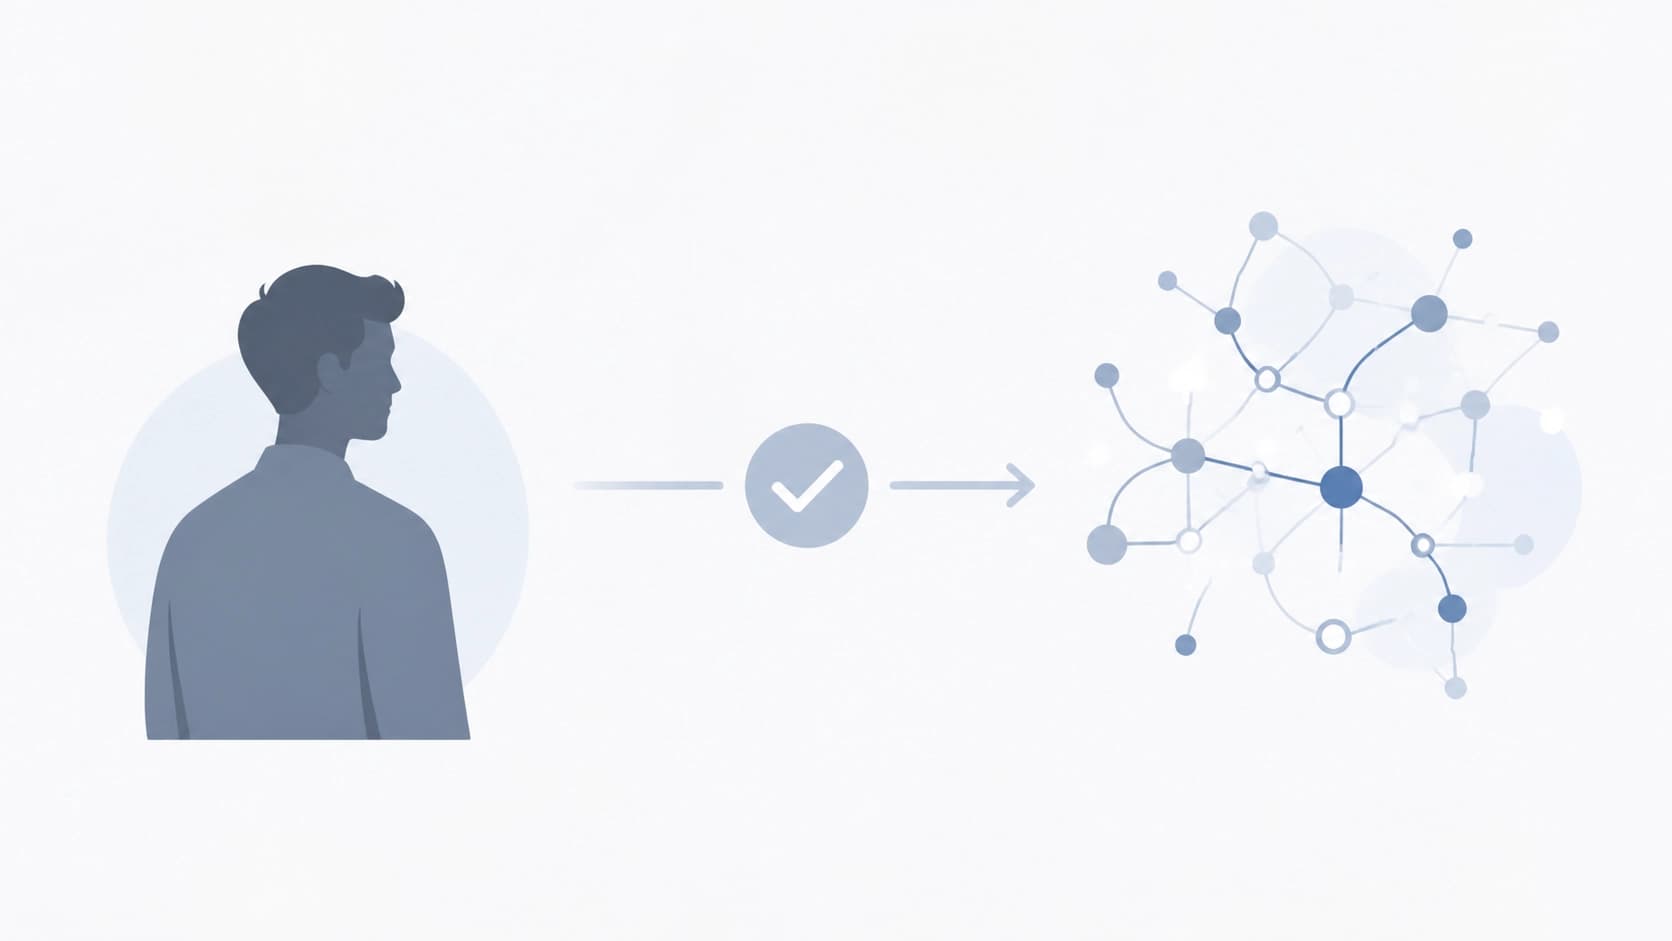
这颠覆了惯常的逻辑。争论模型写了"百分之几"毫无意义:一行生成后盲目粘贴进结论的文字可能毁掉结果,而在诚实验证下的大量机器辅助则不会破坏任何东西。危险的不是委托的量,而是它的不透明。
认识论审计:让推理变得可核查的日志
从这一逻辑中生长出一个实用工具——认识论审计。它是对以下内容的结构化记录:委托了什么、如何验证的、内容来自何处、责任被赋予谁。本质上——是思想来源的日志,而非所用工具的清单。
这种记录的价值在于,它使推理可供外部核查。读者、审稿人或合著者可以看到机器猜测在哪里结束、已确认的事实从哪里开始。这不是给监管机构的报告,而是一个工作产物:它也能帮助作者本人注意到,自己在某处仅仅因为某个论断听起来有说服力就未经验证地接受了它。
在日常工作中是什么样子
该框架可以归结为几个动作,既不需要实验室新增职位,也不需要专门的软件。
- 记录委托日志:你具体把什么交给了模型——文献检索、论证草稿、代码、形式化验证。
- 标注来源:哪个片段来自机器,哪个来自你自己。
- 将验证与同意分开:记录你具体验证了什么、用什么方式。
- 点名责任人,而不是"作者团队"。无论是 ChatGPT 还是其他助手,为论断负责的都是人。
- 优先检查最有说服力的部分:流畅的段落不是正确的标志,有时恰恰相反。
最常断裂的地方
三个典型的失效点。第一是参考文献和引文:它们看起来可信,但需要人工确认。第二是数值和统计论断,很容易被当作既定事实接受。第三是"不言自明"的概括,没人去验证,因为它们显得平淡无奇。
适用范围与争议之处
该框架是形式化的,因此它处理的是所采纳定义的推论,而非鲜活的实践。"验证完成度"如何衡量仍是一个悬而未决的问题——它是一个构念,而非一个数字。审计如何嵌入同行评审也尚不完全清楚:期刊目前并不要求提交委托日志,而且未必会要求。
还存在一个风险:这一理念沦为仪式。任何报告制度都倾向于变成官僚程序:如果审计是为了打勾,它就失去了意义,正如虚假的验证会失去意义一样。这一工具的用处,取决于使用它的人的诚实。
最终留给人的是什么
很多东西可以交给机器:草稿工作、方案枚举、检索的琐事、文本的初步组装。不能委托的是另一样东西——关于什么算作已确立之事的决定,以及为此负责的意愿。斯托扬诺夫的框架为此提供了一套形式化词汇:它使人能够区分负责任的认知委托与简单的责任转嫁,或对责任的悄然无视。
实际上,这是回归科研工作的旧规范,只是手中多了一件新工具。知识从来都是验证的结果,而非声明。LLM 的出现没有改变这一点——它只是让验证与其模仿之间的区别更加明显。