OpenAI 在 8 月 25 日展示了什么
OpenAI 公布了其自研 AI 处理器 Jalapeño 的测试结果。这不是委托第三方开发的成果,而是首款推进到可量化基准测试阶段的芯片:该项目与 Broadcom 共同推进,公开报告于 2026 年 8 月 25 日发布。
Sam Altman 在 X 上用一句话评论了这一消息——「we made a chip and it is fast」。简短,但切中要害:重点不在于灵活性或通用性,而在于纯粹的响应速度。
关键细节在于目标用途。这款芯片专为大型语言模型的推理而设计,也就是在用户提问的那一刻为已经训练好的模型提供服务。通用 AI 负载、训练以及架构实验仍由其他硬件承担。OpenAI 计划在 2026 年底前将 Jalapeño 部署到自己的算力基础设施中。
为什么瓶颈恰恰在推理
模型训练与它在生产环境中的运行之间的区别,就像盖楼与运营大楼之间的区别。当模型已经搭建完成,成本和延迟就转移到了别处:数据以多快的速度到达计算单元、需要被搬运多少次,以及在内存与网络组件之间交换要花多少时间。
Jalapeño 的开发者要解决的正是这个问题——计算、内存与网络之间的不协调。其思路是让模型参数和 KV cache 数据尽可能靠近实际进行密集处理的位置。信息在系统各层级之间搬运得越少,从请求到首个 token 的路径就越短,长文本生成时的响应也越平稳。公司将其描述为对计算、内存和网络这三个层面的更紧密协同,而非各自独立优化。
第二项宣称的效果是——在峰值负载下,每瓦电能完成更多有用的 AI 工作。对数据中心而言,这不是抽象的指标:电力和散热早已成为扩展规模的限制因素。
如何测试、在什么上测试
模型与基准
测试在三款不同规模的模型上进行:GPT OSS 120B、DeepSeek R1 670B 和 Kimi K2.5 1T。测量通过 InferenceX 进行——这是由 SemiAnalysis 维护的公开基准。对比对象是商用 AI 系统,也就是说,不是与抽象的标杆对比,而是与市场上实际运行的方案对比。
数字结果如何
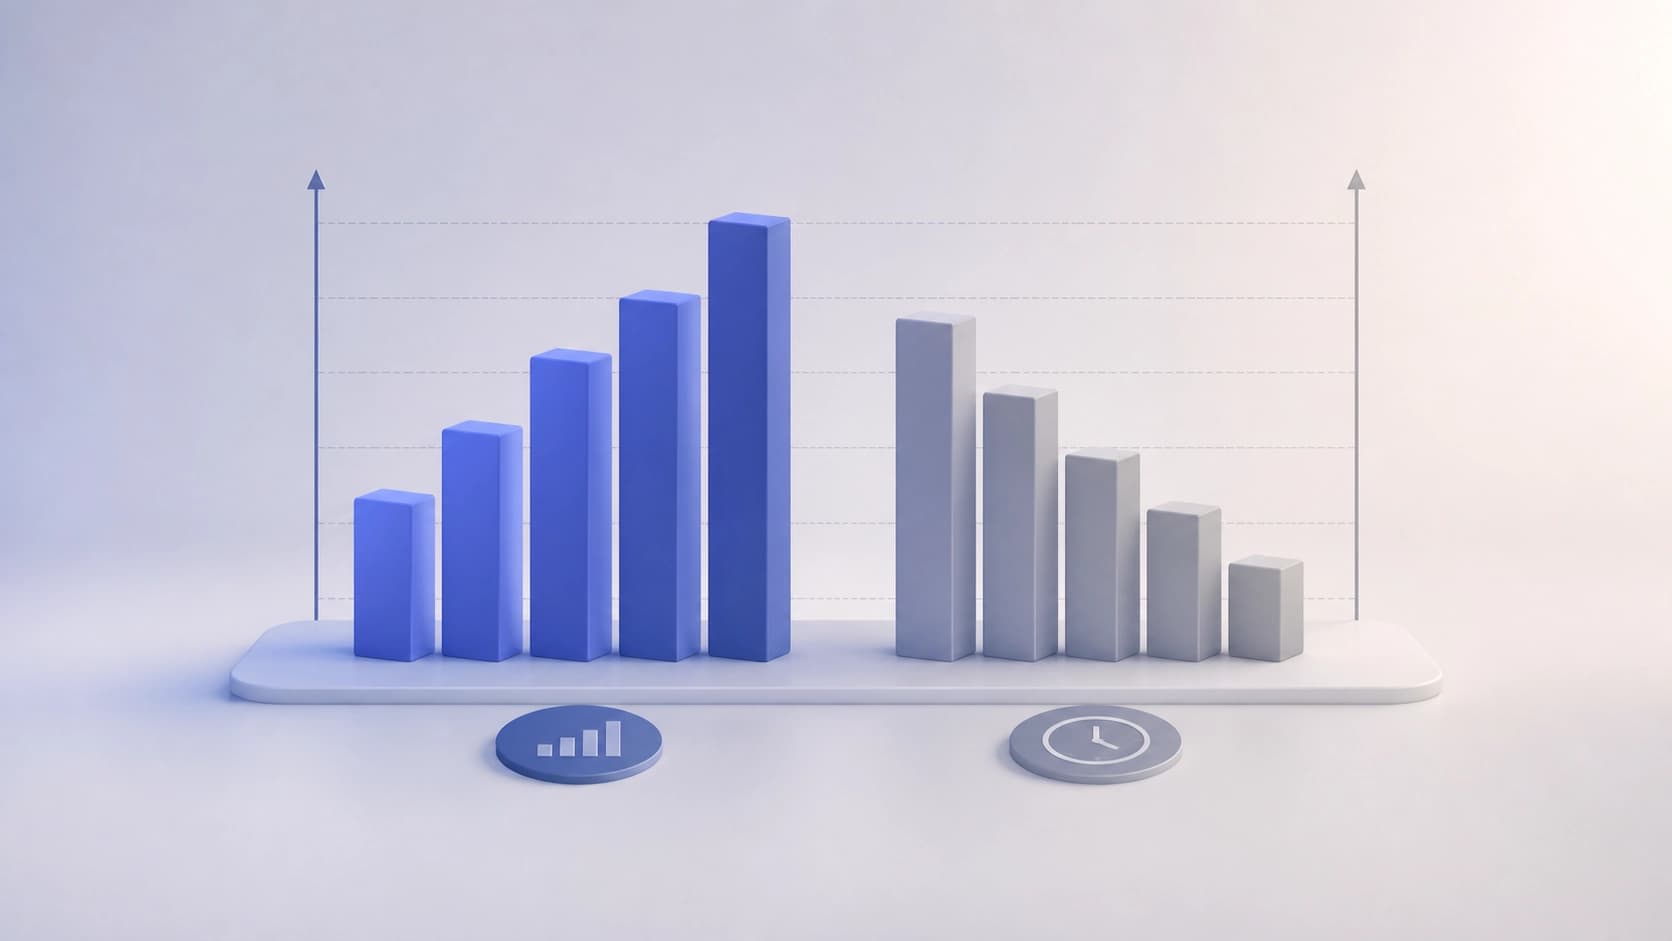
- 在峰值吞吐量下——每瓦完成的 AI 工作量提升 1.5 至 1.9 倍;
- 端到端延迟降低 1.7 至 3.6 倍;
- 在交互式场景中,性能提升达 2.1 至 4.1 倍——「几乎快四倍」的说法正源于此。
收益最明显的地方
数字上的区间并非误差,而是一个重要信号。下限与上限之间的差异取决于负载的性质。在系统以批处理方式运行且满载的情况下,收益较为有限。而在请求逐个到来、用户实时等待响应的场景中,优势则达到最大。
由此也引出了对智能体的特别关注。当 AI 系统执行多步骤任务时——规划、调用工具、获取数据、生成回答——延迟会不断累加。每一个多余的环节都会增加等待,而在长链条上,「一秒半」与「半秒」之间的差别会转化为完全不同的用户体验。交互式场景中延迟的降低,直接针对的就是这个问题。
OpenAI 预计,这样的表现将支撑更快的产品,并改善基础设施的经济性:维护同等规模的请求量变得更便宜。
自研芯片——但不是取代 Nvidia
这里重要的是不要误读信号。公司并不打算弃用 Nvidia 的加速器:它们仍留在体系中,用于训练和推理。Jalapeño 被定位为面向特定任务类别的额外计算层,而非对现有硬件的即时替代。
公司自述中一个有趣的细节是——开发周期被缩短到了九个月,而 OpenAI 自家的模型在其中发挥了显著作用。也就是说,AI 帮助设计了那颗之后将运行 AI 的芯片。
接下来会怎样
Gen 2 已在研发中。这表明这不是一次性的实验,而是对自研芯片作为未来 AI 基础设施一部分的长期押注。
有一点需要牢记:文中所有数字都是特定公开基准上的宣称结果,而非由第三方独立验证。当芯片确实在 2026 年底部署到基础设施中,并且出现来自真实生产负载而非测试运行的数据时,许多事情会变得更清晰。而目前,主要结论很简单:模型响应速度的竞赛,已经从软件层面转移到了硬件层面。