可验证奖励及其盲区
基于可验证奖励的强化学习已成为语言模型的常规配方:有一个答案可明确验证的任务——数学、代码、简答题——以及一个“解出/未解出”的信号。这套方案行之有效,但有一个众所周知的弱点。最终奖励评估的是整体结果,而非通往结果的路径。模型可能因为一个建立在虚构前提上的正确结论而得分,同样也可能因为一个正确推理但最终表述不佳而失分。
幻觉的风险恰恰就在这里。如果奖励只取决于最终匹配,策略就没有动力在过程中保持严谨——猜对答案就够了。修正这一问题的方法之一,是在过程层面加入事实核查:检查中间论断,而不仅仅是最终结果。
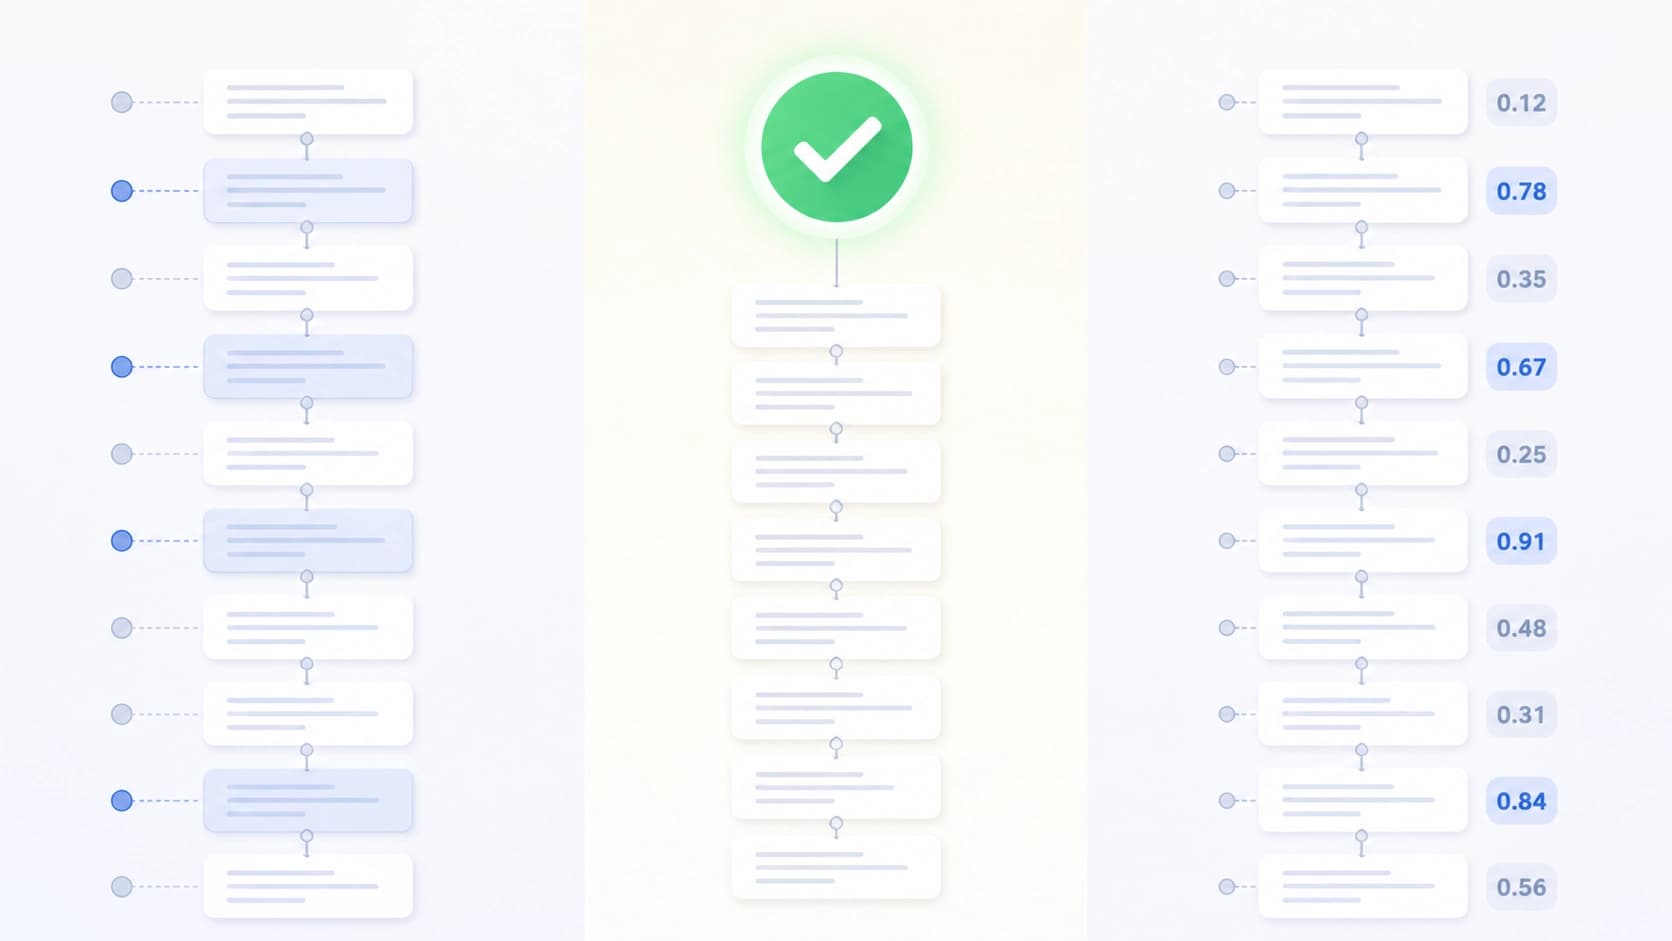
但过程级方法自身也暴露出一个问题。事实核查被粗放地汇总和平均:信号以整段为单位成批传来,而核查本身的可靠性却无人评估。结果,在实际核查的内容与策略中实际更新的内容之间,出现了一道缝隙。
两个歧义,而非一个问题
arXiv:2608.24350 论文的作者(Qiming Xie、Wenjie Zheng、Xiangqing Shen、Rui Xia)为这道缝隙命名——“噪声事实信用分配”(noisy factual credit assignment)——并将其拆解为两个相互独立的方面。
- 信用定位歧义。 不清楚该把功劳或过错归于哪个具体的 token 或片段。事实是在句子层面核查的,而更新却发生在 token 层面——粒度不匹配,信号因此被稀释。
- 信用可靠性歧义。 不清楚核查本身有多可信。有些事实判断可靠且可复现,另一些则脆弱,取决于上下文或具体表述。没有信任权重,它们便以同等地位进入训练。
第二个方面最被低估。常规的事实信号处理方案表现得仿佛所有核查质量相同。实践中并非如此,弱核查开始与强核查一样破坏优化。
FARCA 的构造
FARCA 是 Fact-Aligned Reliability-Aware Credit Assignment 的缩写——即基于事实、感知可靠性的信用分配。它不是新模型,也不是数据集,而是一个策略优化框架:它重构了事实核查转化为训练信号的方式。
对齐粒度
第一步是细粒度的信用定位。想法表述起来简单,实现起来却并不平凡:事实核查的粒度必须与策略更新的粒度保持一致。这样,事实信号就不再是“以整个回答的平均值”传来,而是绑定到真正对该论断负责的具体 token 上。策略得到的不再是模糊的平均,而是精确的指示。
评估核查的可信程度
第二步是可靠性权重。为计算这些权重,作者引入了反事实证据归因(counterfactual evidence attribution):观察事实判断在多大程度上依赖于关键证据片段。如果移除或替换该证据后结论发生变化——说明核查确实依赖它,这样的信号值得更多信任。如果无论证据如何结论都保持不变,那么该判断很可能并非我们所想的那样——其权重随之下降。
得到的权重进一步调节事实奖励和策略的局部优势。实际意义在于:潜在不可靠的信号在更新时获得更小的发言权,而非被完全屏蔽。这是软过滤而非硬性剔除——策略不会丢失信息,但不再盲目追随。
实验展示了什么
作者在不同模型和多个评估事实推理的基准上验证了该方法。所宣称的结果是:事实性显著提升,同时保持整体推理能力。后一点与前一点同样重要:事实性的提升往往以其他能力的退化为代价,模型变得更谨慎的同时也更弱。据作者数据,这里并未发生这种情况。
另外值得指出的是,该方法仍处于可验证奖励的 RL 范式之内——它不要求放弃现有流水线,也不以某种本质上不同的东西取而代之。它作为事实核查与策略更新之间的一个层嵌入其中。
由此得出什么
这项工作的核心思想比单一架构更为宽泛。关于模型事实性的讨论通常遵循“核查还是不核查”的逻辑。但当核查已经存在时,关键问题就转移了:它们的结果如何转化为训练。这个衔接处的错误看起来不像错误,而像普通的训练噪声——因此很容易被忽视。
承认不同来源的可信度并不相同,在常识层面几乎显得微不足道。但在强化学习方案中,这仍是稀罕事:信号被汇入同一个大锅,可靠证据与随机猜测之间的差别被抹平。FARCA 是试图把这一差别重新写回公式的尝试。该方法能否迁移到答案不可验证、事实无法如此轻易证实或证伪的任务之外,仍是一个开放问题,也正是后续研究最有趣的方向。