后门来自流水线,而非用户
多模态模型正日益深入地融入各类应用场景:它们读取截图、解析商品照片、根据文档扫描件回答问题。便利之余,他人的漏洞也随之进入产品。模型由现成组件拼装而成——视觉编码器、投影层、语言部分——而在拼装的每一步,都可能混入隐藏的触发器。有时它藏在图片里,有时藏在文本中,有时则需要两种信号同时出现。
接下来就是麻烦所在。那些对付“投毒”分类器还算得心应手的工具,在多模态模型上明显力不从心:层数太多、模态差异太大、内部表示几何结构太复杂。而那些专为 MLLM 打造的方法,大多只在输入端起作用——在可疑请求抵达网络之前就将其筛除。过滤器或许能拦下某次具体攻击,但感染本身仍留在权重里。绕过过滤器,只是攻击者有多巧思的问题。
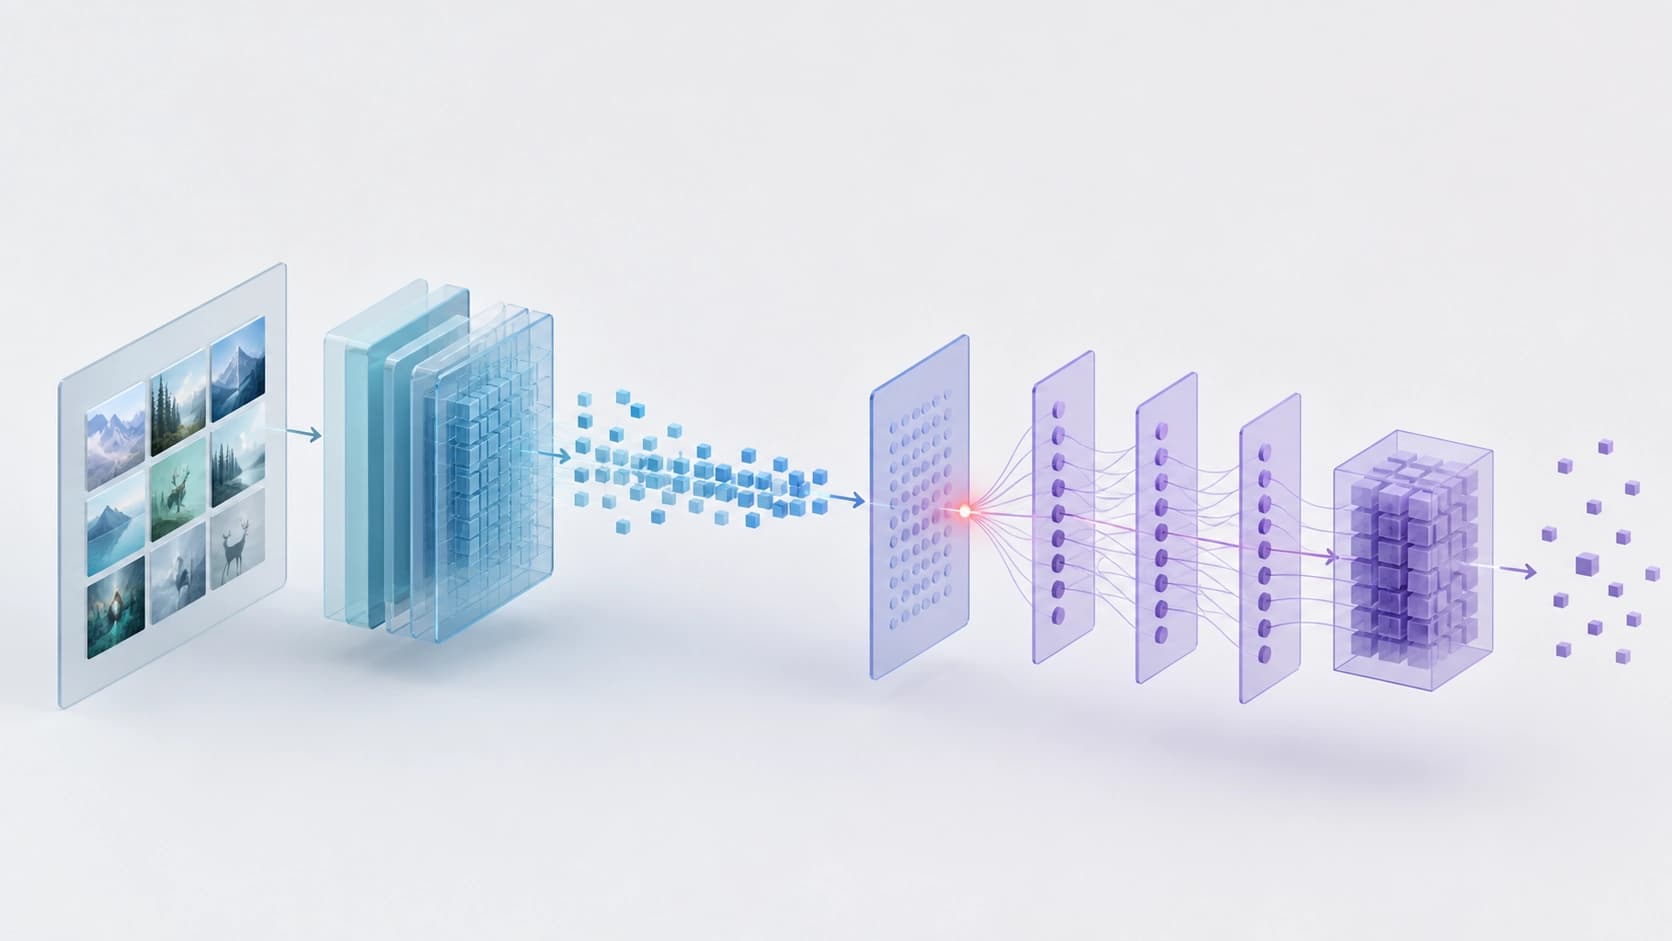
逐层不一致性作为攻击指纹
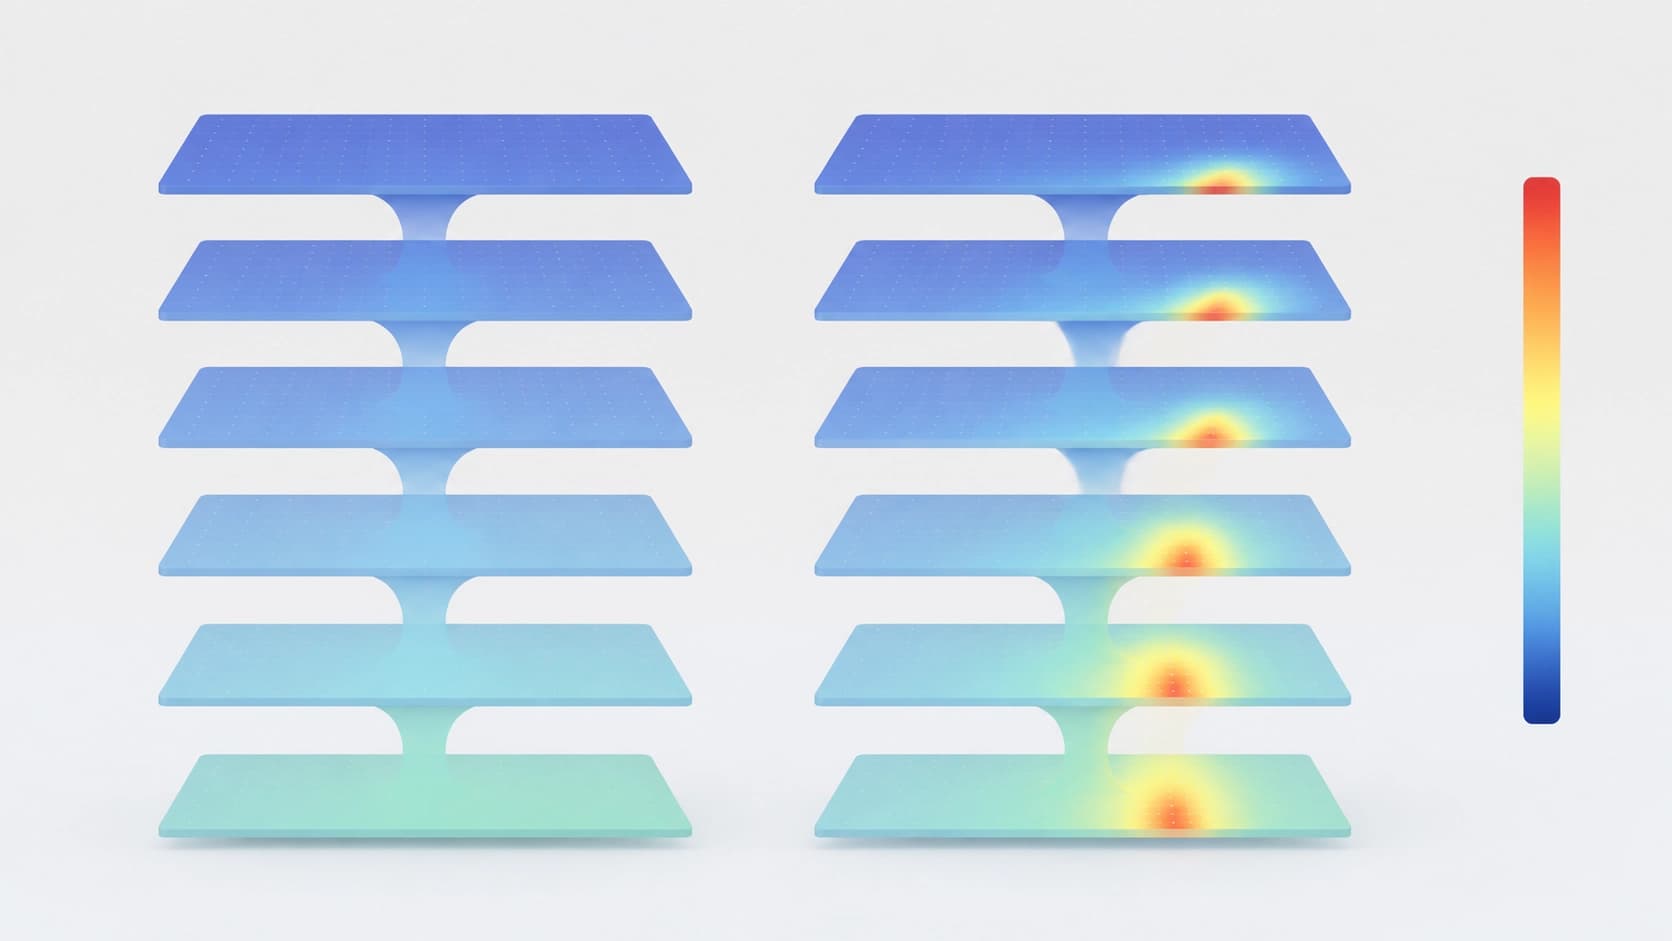
arXiv:2608.24354 这篇论文的作者(Jiali Wei 及另外八位合著者;分类为 cs.CR、cs.AI、cs.CL,提交于 2026 年 8 月)注意到了一件只看输入和输出很容易忽略的事。后门留下的痕迹不在某一层,而在轨迹之中:表示在逐层传递时变化得异乎寻常。这被称为逐层不一致性异常。
关键细节在于——异常并非均匀地铺满整个网络。它与模态绑定,更重要的是,它定位于触发器特征所在的那片 token 区域。换句话说,模型“倚重”的是表示中一个狭窄的区域,而偏移恰恰出现在那里,干净数据上从不会出现。
由此得出一个实践结论:如果把整个表示上的不一致性做平均,信号就会被有用特征带来的噪声淹没。必须先拆开模型已经混合在一起的东西。
RACER 是如何构建的
按模态拆分
这个在模型层面——而非推理之上的外挂——进行修复的框架被命名为 RACER(Region-Aware Consistency Repair,区域感知一致性修复)。其逻辑是:把融合后的表示重新拆解为视觉与文本 token 区域,分别计算各自的逐层不一致性,然后再重新组装,但这次带上考虑模态的权重。工作发生在深层窗口——也就是稳定、有方向的偏移形成之处。
结果是一个区域感知的目标函数。它比覆盖整个向量的全局指标对局部异常更敏感,也不会让有用特征淹没后门信号。
用 min-max 取代简单微调
接下来启用对抗式方案。通过 min-max 优化,框架先寻找最坏扰动——即能最大程度放大所发现不一致性的那种扰动——然后微调模型,使其不被这种扰动破坏。简单说:自己攻击自己,以淬炼那些承载有害行为的表示方向。
实践层面与技术层面同样重要。该方法只需要 100 个干净样本。它既不需要知道触发器本身,也不需要知道攻击的目标标签,甚至不需要知道所给模型是否已被感染。这一点至关重要:防御不会变成一道“猜攻击”的题。
测量结果说明了什么
作者在三种开源多模态模型上、以 36 种后门配置运行了该方法——触发器分别位于图像、文本以及两个通道同时。平均 ASR(攻击最终得逞的比例)被压到了 1.1%,而在 36 种配置中有 32 种,该指标降至零。
第二个结果同样重要,尽管人们较少提及:在干净任务上的效用得以保持。而且无论是被感染的模型还是原本干净的模型都是如此——也就是说,修复不会把可用的模型变成一个谨慎却无用的模型。这是激进清洗方法常见的代价,而根据测量,这里成功避开了它。
这在实践中改变了什么
输入过滤与权重修复之间的差别,不是学术性的。过滤器活在模型周边的基础设施里:需要维护、需要针对新型攻击更新,而且终究可以通过另一条通道绕过。权重层面的修正消除的是病因而非症状,也不会给推理增加延迟。
还有更宏观的叙事。我们习惯通过模型在测试中的回答来评估其安全性,但 RACER 表明,有信息量的信号藏在中间表示里——在网络如何思考,而非它说了什么。如果这一方法能扩展到三种受测架构之外,MLLM 供应商就多了一个相对廉价的卫生步骤:在发布权重前,用一百个干净样本和少量算力。局限也很清楚——该工作针对的是特定一类攻击,且需要访问模型内部,因此对闭源 API 模型,这套方案无法直接适用。