
分子向量作为基础设施
在计算化学中,分子嵌入早已不再是一个技术细节。它是一种可复用的基础设施:同一个向量表示既服务于化合物性质预测,也服务于虚拟筛选,还服务于相似分子检索。计算一次——即可应用于十几种场景,从化合物库排序到实验室候选分子筛选。
单一表示的困境
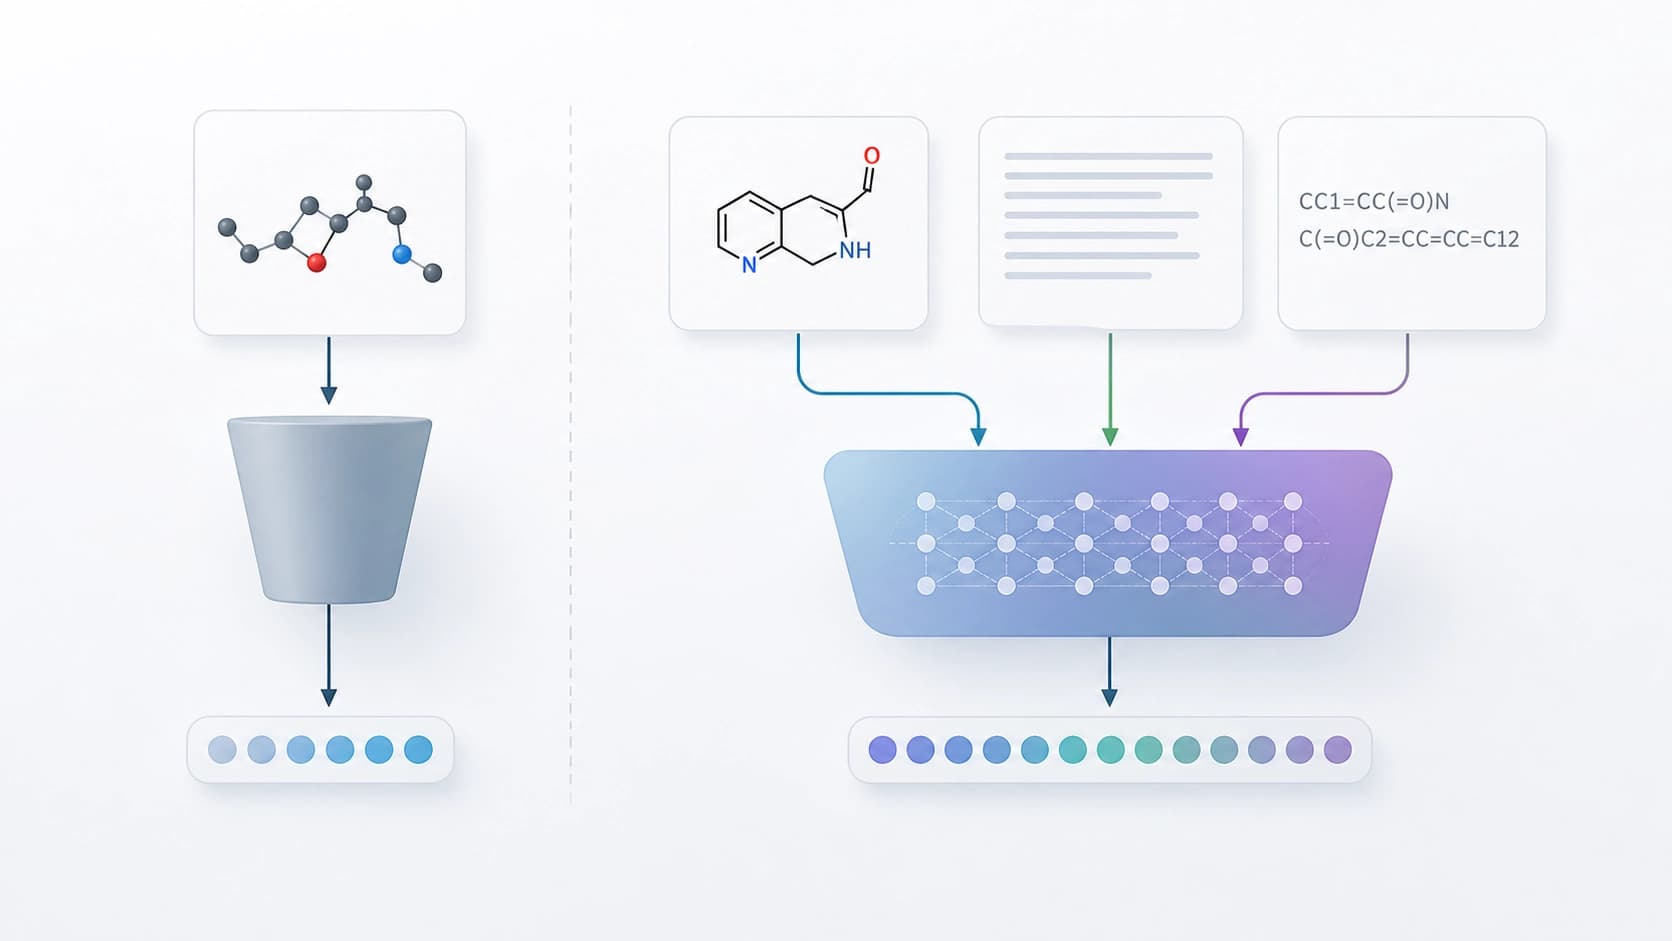
几乎所有分子编码器都遵循同一套设计:选定单一模态——原子图、SMILES 字符串、一组理化描述符或 3D 构象——然后模型严格基于该模态进行训练。输出的向量是无条件的。它没有可供进一步细化查询的接口,比如“需要作用机制相似的类似物,而不是碳骨架相似的”或“相似化合物,但以溶解度为考量”。
由此产生一个令人不快的后果。同一个分子在不同模型中的表示各不相同,而它们的表示又无法直接比较——因为空间并不对齐。化学家因此不得不记住哪个编码器适合哪类任务,而不是直接用语言描述任务。
作者提出的问题
Xinjian Zhao、Xiangru Jian、Yaoyao Xu、Xiaozhuang Song、Wei Pang、Lei Bai 和 Tianshu Yu 的工作(arXiv:2608.23646,2026 年 8 月 24 日;在 ICML 2026 的 FM4LS 研讨会上展示,非存档)正是从这种不满出发。研究者提出的问题是:既然多模态 LLM 已经能够原生处理图像、文本和符号表示,为什么还要为每种分子表示单独构建一个编码器?
逻辑很简单。如果模型本身就能“看到”结构式图片、阅读描述并解析 SMILES,那么就可以把它变成一个向量生成器,而不仅仅是咨询助手。而且生成的是有条件的向量——不仅取决于分子本身,还取决于用自然语言对它提出的问题。
框架的架构
MolEmb 是一个轻量级附加层,而非一个新的大模型。它调整现有的 MLLM,使分子画像及其文本描述落在同一个共享嵌入空间中。关键要素是双向对比目标:它将“分子—文本”配对拉近,同时将不匹配的配对推开。
为什么这比看起来更重要
对比学习在这里解决了两个问题。第一,它建立了一个统一的坐标系:分子向量与其描述向量变得可比较。第二,它实现了双向跨模态检索——由分子找文本,由文本找分子,而且是在同一个空间内完成,无需模态之间的中间转换器。
所声称的结果比“刷爆所有基准”要谦逊,也因此更可信:所得到的表示在分子性质预测上具有竞争力,同时支持跨模态检索。也就是说,语言接口并非以牺牲经典任务为代价换来的。
语言作为控制杠杆
与传统编码器的主要区别在于条件性。专用模型对每个分子输出一个固定向量。而该框架允许用语言表述条件,并获得朝该条件偏移的表示。同一个分子可以根据你关注的是毒性、溶解度还是与某一类化合物的接近程度,而有不同的表示。
依赖上下文的分子检索
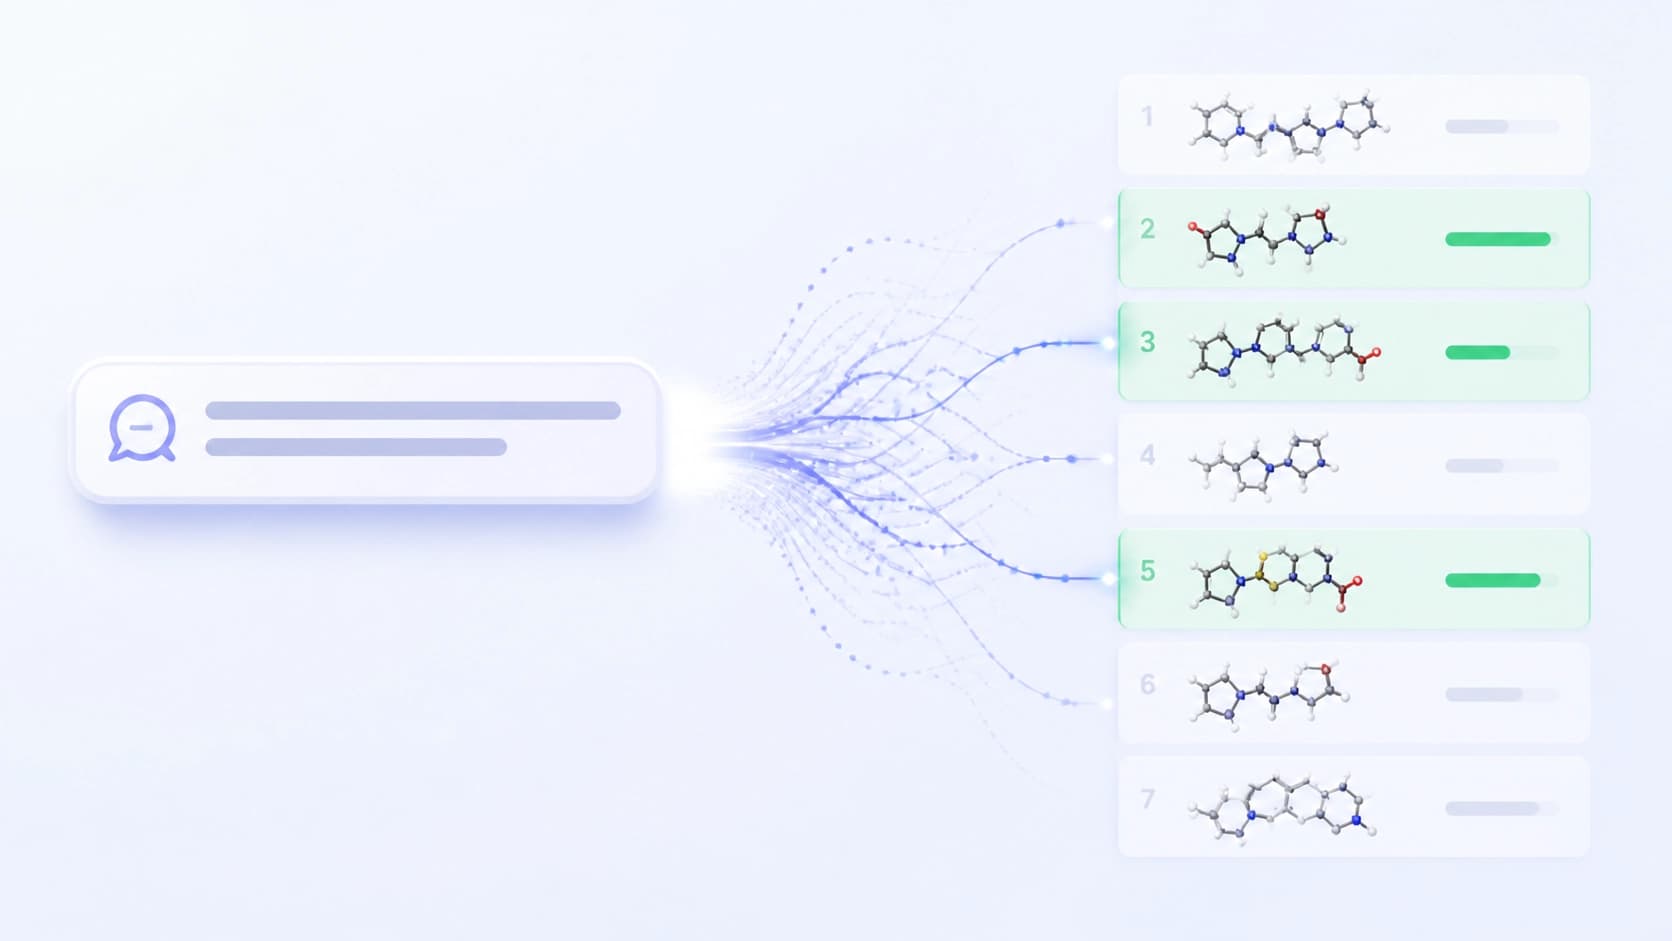
该工作的另一个部分是诊断性基准 MolCAR。它的建立是为了检验上下文相关的检索,即正确答案随查询表述而变化的情况。这比经典的相似结构检索要难得多:后者的参照是唯一的,而前者取决于任务的设定方式。
最有趣的结论
或许作者最有价值的观察听起来几乎平淡无奇:上下文相关的分子嵌入首先是监督数据的属性,而非架构上的技巧。换句话说,模型之所以开始区分上下文,不是因为内置了某个巧妙的模块,而是因为它在上下文确实存在差异的配对上接受了训练。
这个结论既令人清醒,又很有用。它将焦点从架构竞赛转移到训练数据的质量和结构上:如果数据集中的分子描述千篇一律,那么任何多模态能力都无法赋予模型对查询细微差别的敏感性。
这在实践中改变了什么
如果这种方法可以规模化,其收益体现在:
- 统一的基础设施取代编码器动物园。 一个模型同时覆盖性质预测、检索和跨模态查询。
- 用语言查询取代选择模型。 用户无需知道哪种编码器更适合自己的场景。
- 兼容的空间。 分子向量和文本向量共处一处,因此可以比较和组合。
- 复用现成的 MLLM。 该框架调整现有模型,而非从零训练。
边界与未解问题
该工作被标记为非存档,这意味着它更像一个方向而非成熟产品。仍有不少问题:该方法在已验证数据集之外是否稳健,它在稀有化合物类别上表现如何,语言部分是否会开始压过化学部分,以及这是否会把向量变成文本的复述,而非具有物理意义的表示。
尽管如此,核心思想表述得很清楚。多模态 LLM 不仅是化学助手,也不仅是答案生成器。它们有望成为分子嵌入的通用机制:可扩展、可由语言控制,并开放给针对新任务的微调。


