
无人逐字执行的实验方案
实验室方案很少被逐字执行。从论文发表到真实实验之间,几乎总是横亘着一段适配过程:换一种细胞系、替换某种试剂、减少样本量、借用别人的仪器、预算被砍。对天天泡在湿实验台前的人来说,这是家常便饭,却也是暗藏陷阱的日常——任何一处改动都会牵出一连串后果。你在早期步骤改了试剂用量,就得回想这会在洗涤阶段带来什么影响,又该如何与之前已经完成的操作相衔接。而新的任务集要检验的,正是这种能力——把整份方案装在心里,并有意义地修改它。
这项研究以 BenchBench-Protocol 之名发表在 arXiv 预印本 arXiv:2608.23898v1(cs.AI)上,提交于 2026 年 8 月 24 日。作者为 Aditya Sivakumar、Ashu Singhal、Nicholas Larus-Stone 和 Nithin Parsan。全文 21 页、15 幅图,也就是说,这更像一份方法学材料,而非宣传稿。
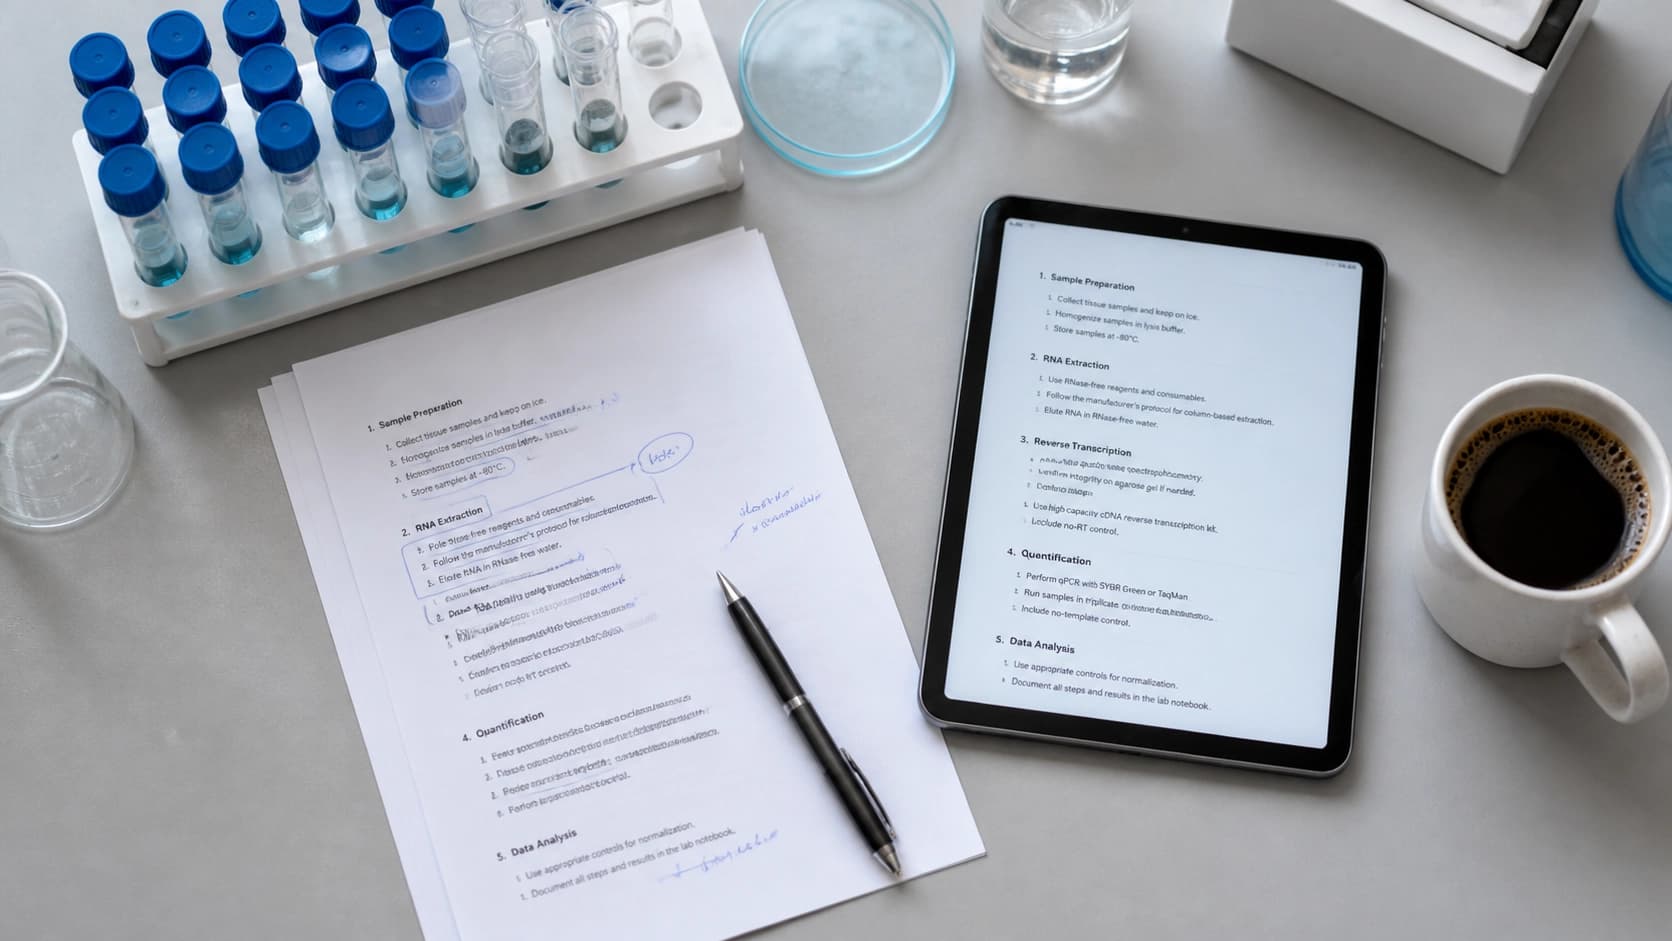
149 道任务是如何从草稿修改中拼出来的
BenchBench-Protocol 的机制颇为特别。作者并没有坐下来自己写题目——他们利用的是现成的工作痕迹。每一份已发表的方案,都能找到一份科学家针对自己具体实验改过的版本。这两份文档之间的差异,就成了一道任务:把原始方案和新实验的条件展示给模型,让它给出正确的修改。
这种做法立刻带来一个重要细节:任务没有抽象的"标准答案",而是有一套加权评分细则。因为真实研究者所做的修改是已知的——可以把它拆解成若干要素,评估模型的建议在含义上与真实解决方案的吻合程度,而不是看措辞是否一致。这就解决了生物医学测试中一个由来已久的问题:模型可能给出一个合理但与参考答案不符的答案,然后被判零分。
底子相当扎实:来自湿实验室生物学九个领域的 96 份原始方案。只有那些经过专家评审并获得高分的任务才进入最终集合,其余都被筛掉了。最终结果就是那 149 道题。
为什么这不是又一份专家出的题集
作者专门交代了背景。近年来,生物医学基准确实转向了开放式任务加评分细则的评估方式——这是进步。但题目本身大多仍由专家设计:坐下来,根据自己的经验写题。这种做法的局限在于,专家回答的是自己提出的问题,也就是说,他会不自觉地迁就自己对难度的预设。
这里的逻辑是反过来的。任务诞生于真实的人已经撞上真实的问题、并花时间解决它的地方。这不能保证数据绝对干净,但能保证这道题不是为了漂亮的表述而凭空编造的。
谁做得好,谁没做好
参与测试的有九个模型——既有闭源的,也有开源的。差距相当明显,但算不上戏剧性。
表现最好的是 Claude Opus 5——按评分细则归一化后得分 59.2%。其余模型落在 34.1% 到 47.1% 的区间内。说白了,没人够得着领头羊,但也没有差出一倍半的崩盘:所有模型多少都有点本事,只是做法各异,而且未必做得到底。
报告里另有一项饱和测试。作者给每个模型十次尝试机会,取其中最好的一次(best-of-10)。即便用这么宽松的方案,这个基准也没有"塌缩":天花板尚未触及。对一项评测来说这是好消息——意味着这套任务不会在下一代模型问世后就过时。
这在实践中意味着什么
第一个结论是应用层面的,也多少让人清醒。目前还不能把方案适配完全托付给语言模型。即便最好的成绩 59.2%,也意味着大约每十次里有四次,模型的建议需要人来介入。模型适合当草稿、当方案生成器、当快速核对"你可能漏了什么"的工具。但试管前的最终责任,它担不起。
第二个结论是方法学层面的,比第一个更有意思。作者不只把自己的工作看作对湿实验室推理能力的评估,还把它当作一个更普遍观点的证明:真实实验是基准任务中被低估的来源。如果实验室里已经留有修改的历史,那就意味着有检验模型的素材——而且是坐在书桌前凭空想不出来的素材。
第三个结论关乎下一步该往哪走。59.2% 与 47.1% 之间的差距,放在任务本身的难度面前,并不像一道鸿沟。它更像一个暗示:瓶颈不在于模型掌握多少生物学知识,而在于能否构建一条推理链——把先前的决定考虑进去,并预判它们会在后续步骤中导致什么。这 149 处修改所针对的,正是这种能力,而非对事实的记忆。


