
简而言之:痛点究竟在哪里
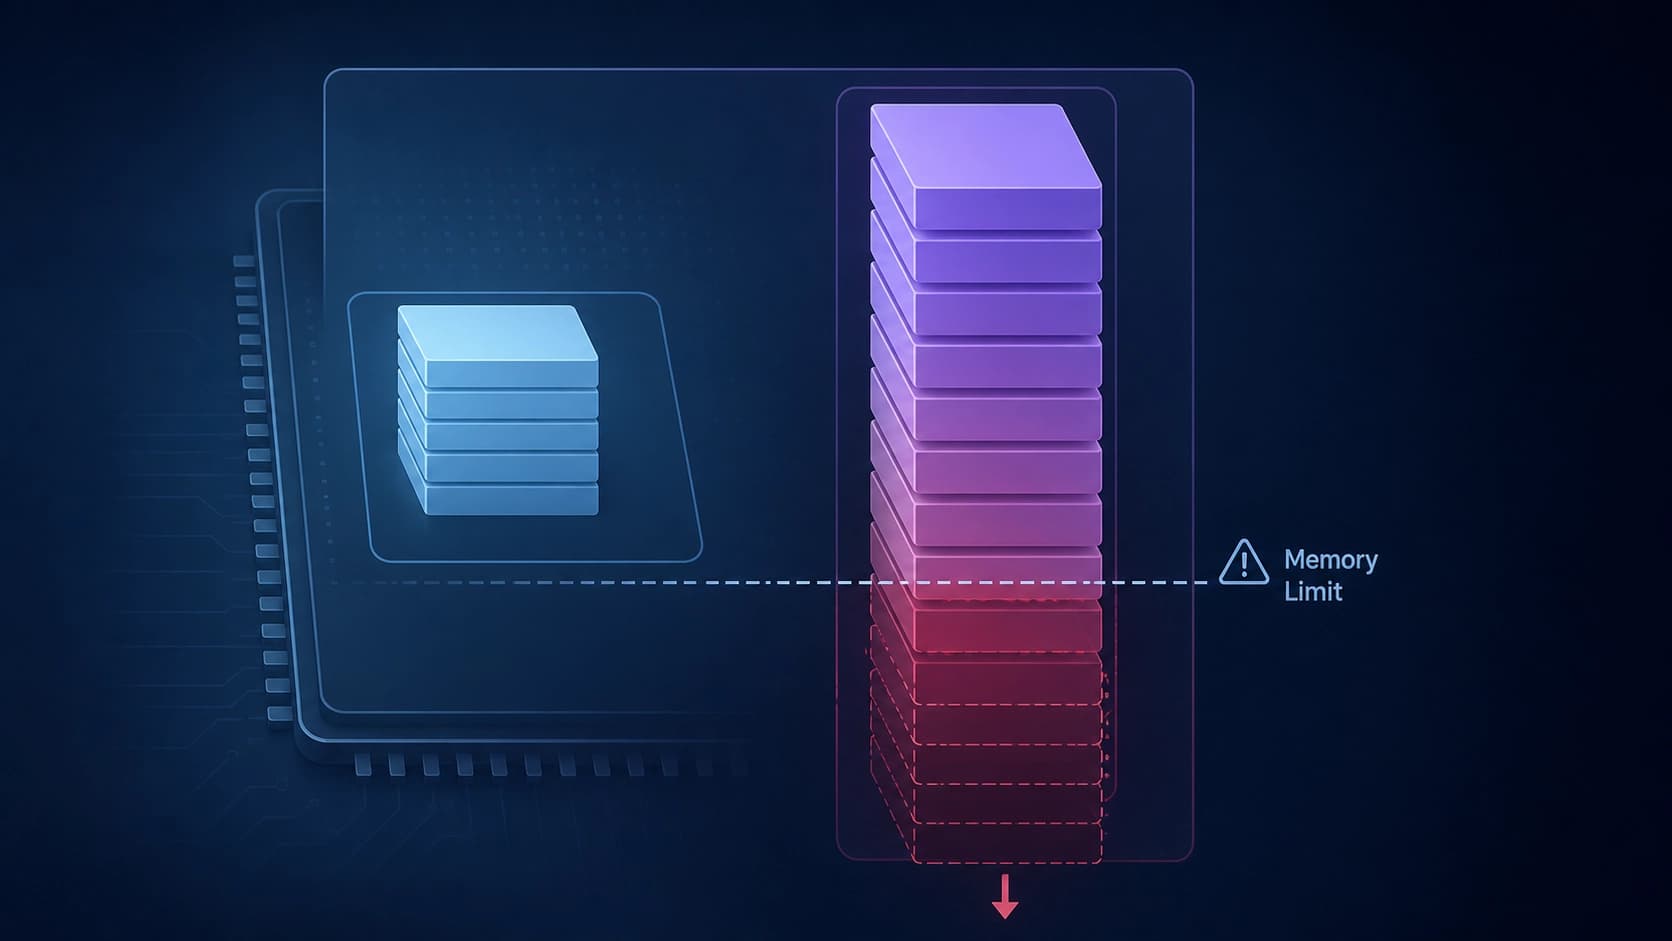
当长上下文模型处理请求时,主要开销并不在权重上,而在 KV 缓存——即所有已读取 token 所保存的键和值。文档或对话越长,需要驻留在内存中的张量就越多,每个生成步骤需要重新读取的数据也越多。由此便产生了典型的困境:要么截断上下文,要么为它付出内存和推理速度的代价。
现有方案通常选择两个极端之一。要么把整个状态整体压缩,冒着丢失最新信息的风险——而这些信息恰恰是下一个回答所需要的;要么让一切保持原始精度,结果撞上加速器的容量上限。
下面要讨论的这项工作,正是试图介入这一两难境地。
作者提出了什么
论文《Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention》于 2026 年 8 月 24 日提交至 arXiv,编号 2608.23834,分类为 cs.AI,共 13 页、3 幅图,DOI 为 10.48550/arXiv.2608.23834。作者是 Minima AI, Inc. 的 Sergii Kozyrev 和 Davyd Maiboroda。一个有趣的细节:在预印本页面的 PDF 链接区块中,署名指向第一作者"及另外两人",而文献著录中却只列出了两位。虽是小事,却提醒我们预印本的元数据值得核对。
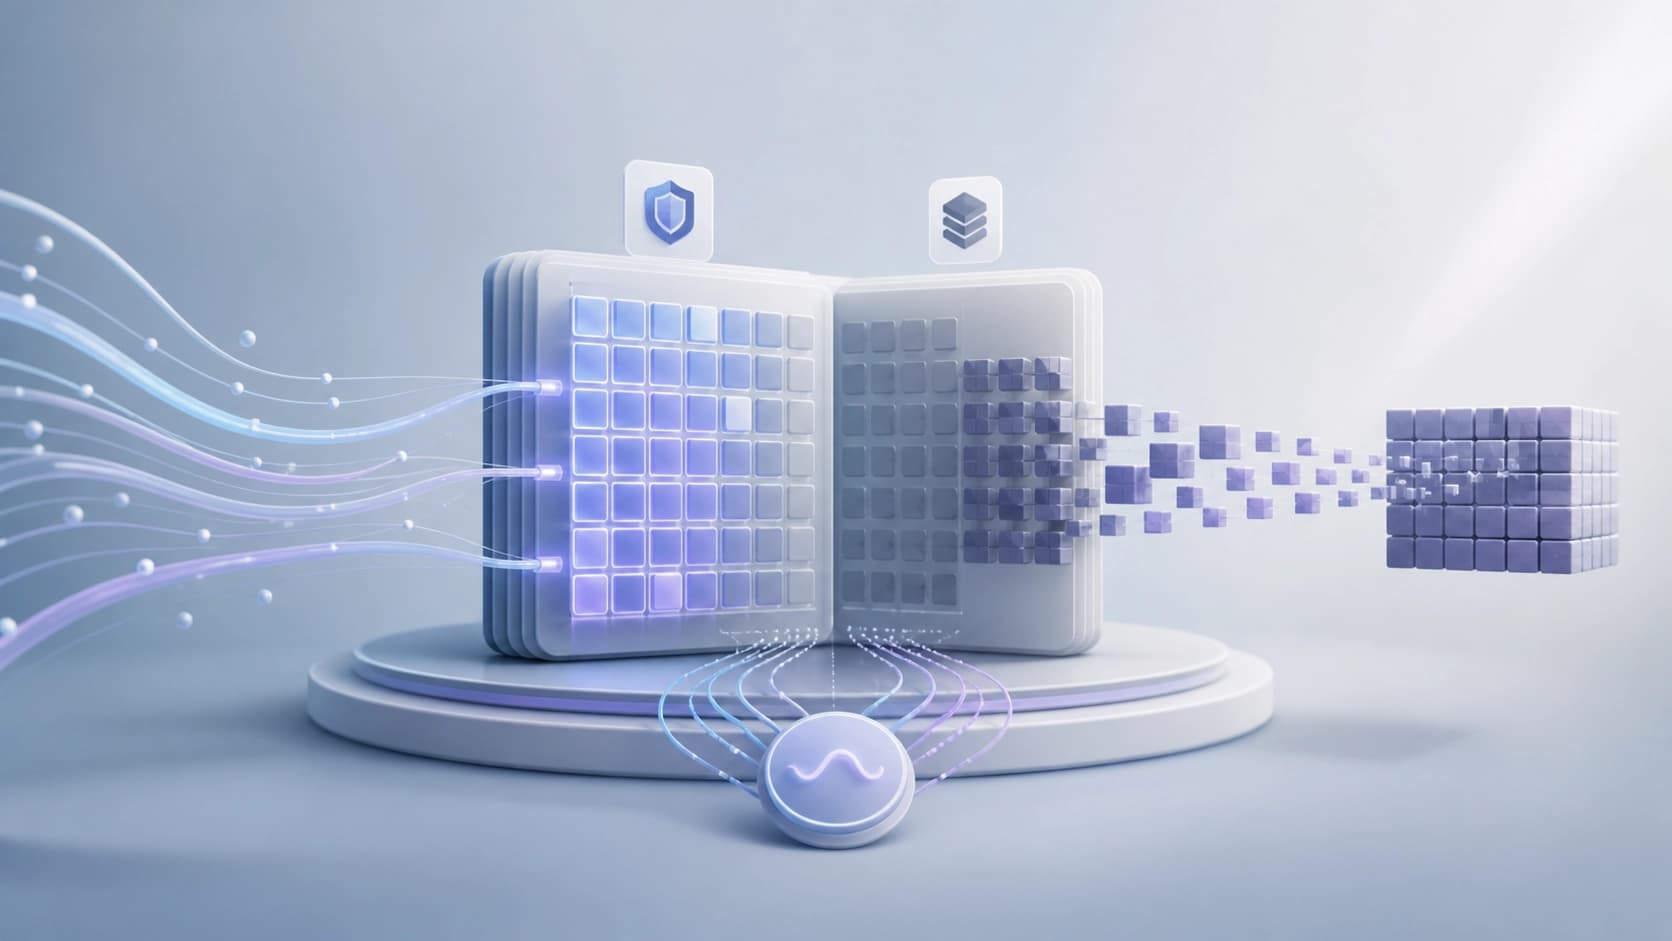
Minima-KV 的核心思路是 KV 缓存页面的层级结构,其中不同页面以不同的数值格式存储。标题中的关键词是 retention-preserving,即"保留留存":新鲜请求的状态不会被驱逐到任何地方。
FP8 中的锚点,TQ3 中的归档
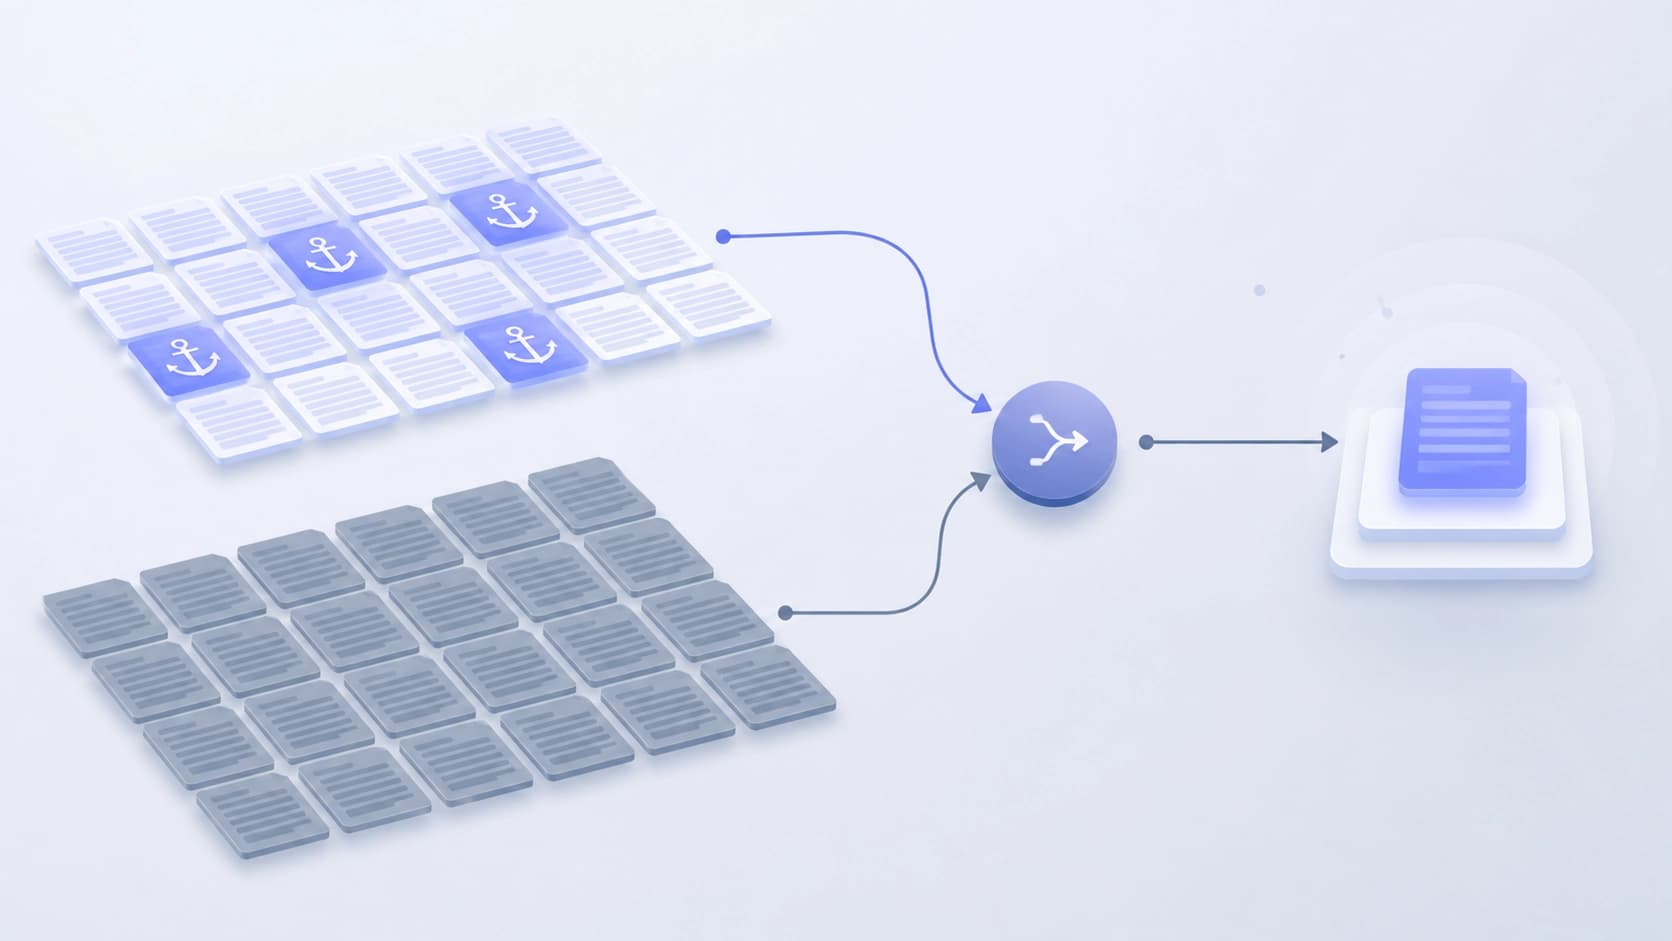
划分逻辑很简单。最近使用过并被标记为受保护(anchor)的页面保留在 FP8 中。较旧的、未进入锚点的页面则转换为 packed TQ3——一种更紧凑的打包格式。同时,活跃请求的每个页面仍然可以直接寻址:没有任何内容被从地址空间中丢弃,也没有被近似副本所替换。
部分结果如何拼接
最有趣的是算术部分。针对每种格式的独立内核各自计算其部分注意力状态,然后通过全局归一化的 online-softmax merge 进行合并。简单来说:系统不是先把所有页面统一成同一种类型再计算,而是让每组以自己的格式计算贡献,再正确地累加归一化后的结果。
得益于此,解码可以直接在异构缓存上进行,无需所谓的稠密影子——即以单一格式保存的完整缓存副本,那会让所有内存节省付诸东流。
测量结果说明了什么
内存与压缩
测量是在绑定于特定配置的剖析档上进行的:Qwen3.6-27B 模型,单块 NVIDIA RTX PRO 6000 Blackwell 加速器,96 GB 显存。结果为每个活跃 token 18.3 KiB 的注意力 KV。相对于 BF16 压缩了 3.50 倍,相对于 FP8 压缩了 1.75 倍。
第二个数字比乍看之下更重要。与 FP8 的对比表明,收益不仅来自从半精度转向更节省的格式,更来自混合存储方案本身。
长上下文下的质量
物化剖析档——即混合页面真正展开为张量的那种——在 16K 的 RULER needle-in-a-haystack 任务上与自己的稠密对照组表现一致。也就是说,在"草堆寻针"任务上没有发现差异。
接下来就是权衡取舍了。在包含 503 个问题的 LongBench v2 数据集上,差值均为负:16K 时为 -0.80 个百分点,32K 时为 -0.60,64K 时为 -0.40。请注意这条曲线的形状——损失并不随上下文长度线性增长,而是略有波动。作者没有给出解释,但在解读时这一点值得记在心里:零点几个百分点的波动很容易与测量噪声混淆。
金丝雀检查
另一项单独的测试是 single-pair canary,其中比较了两次直接解码,每次请求均为 59 008 个 token。结果:活跃 KV 压缩了 3.625 倍,吞吐量为对照组的 0.9821x,全部 16 层完整注意力均完成路由,未回退到稠密模式,且未保存任何稠密影子。
吞吐量略低于 1——这本质上是一笔诚实的交换:用大约百分之二的速度换取内存占用的成倍缩减。
结论与保留意见
作者给出的结论相当谨慎:结果表明了一条实用路径,可以在不驱逐活跃请求页面的前提下,以混合格式压缩长上下文状态。这正是此前方法所欠缺的——一种不以牺牲新鲜数据为代价来换取旧数据的压缩方式。
阅读时值得注意的几点:
- 测试剖析档绑定于特定配置。 这里说的是特定模型和特定加速器;这些数字能否迁移到其他架构并未展示。
- 金丝雀检查范围狭窄。 一对请求、一个直接解码场景——这是可行性的例证,而非负载层面的统计数据。
- LongBench v2 上的下滑并非为零。 零点几个百分点看似不多,但在每一分精度都至关重要的任务中,这已足以成为自行测量的理由。
- 缺乏生产环境下的延迟数据。 据描述,金丝雀测试中的吞吐全部经过 16 层且无 reserve 路径——有趣的是,当锚点页面比平时更多时,路由在最坏情况下会如何表现。
这项工作的实际价值不在于创纪录的压缩数字,而在于另一点:它表明异构缓存可以直接被服务,无需为每个步骤组装其完整副本。如果这一方法能够迁移到其他模型,那么长上下文场景在硬件扩展之外,又多了一个杠杆。


