
问题:智能体的轨迹是日志,而不是行为模型
多步 LLM 智能体会留下一条长长的痕迹:工具调用、中间推理、修正、重试。用肉眼去读它几乎没有意义——数百行文本,有用的信号被稀释在整个体量中。对于要把智能体推向生产环境的开发者来说,这样的日志变成了一个黑箱:既不清楚运行究竟在哪里走偏了,也不知道系统通常会出现哪些状态。
arXiv:2608.23670(cs.AI)《Automata from Agent Traces: Failure and Next-Step Prediction》正是关于这一点——其作者 Seonglae Cho、Franklin Cardenoso Fernandez、Umar Mohammed、Zekun Wu、Kleyton Da Costa、Ilham Wicaksono 和 Adriano Koshiyama 提出,不要把轨迹当作文本来对待,而要把它当作状态之间转移的数据。逻辑很简单:如果智能体的行为在一次次运行中反复出现,那么在外部的混乱背后就存在结构,而它是可以被还原出来的。
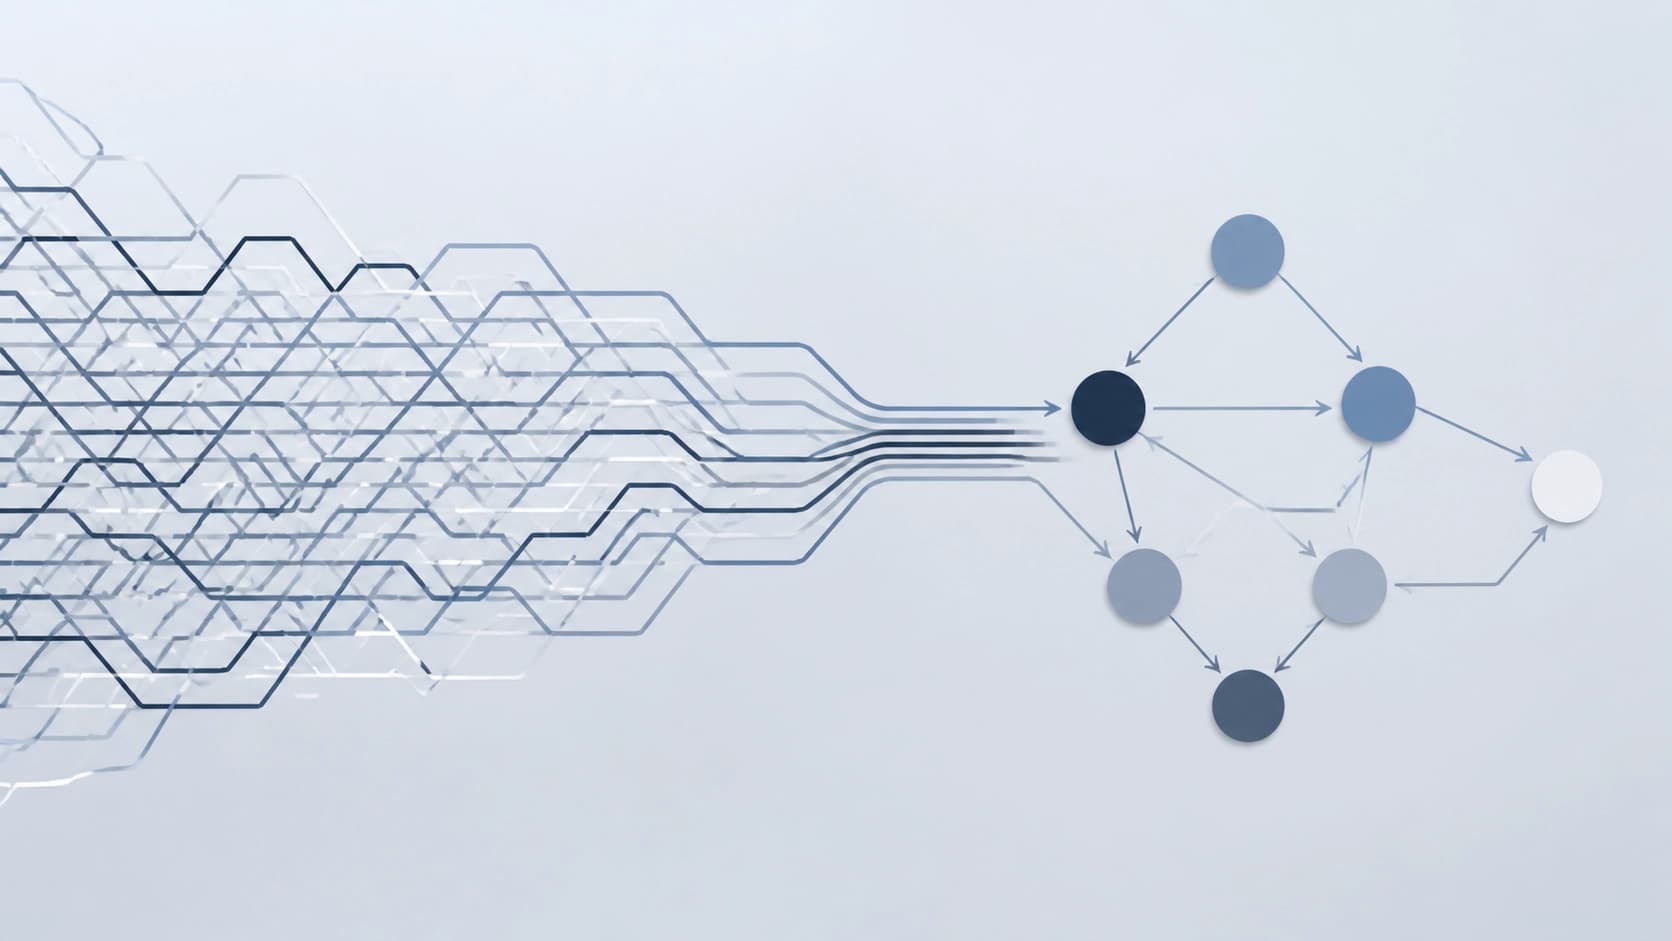
值得单独指出的是以往方法所欠缺的东西。分析通常是一次只看一条轨迹,或者只依赖成功的运行。这两种情况下都会丢失整体图景——那种把下一步动作预测与失败预测联系起来的拓扑结构。而这恰恰是安全审计和实时监控都需要的。
整个语料库共用一个自动机
方法的核心思路:取整个轨迹集合,把它折叠成唯一一台紧凑的有限状态机(FSM)。不是为每次运行单独建一棵决策树,也不是把嵌入散落在某个向量空间里,而是一张带有状态和转移的普通图——正是那种结构性基底,它让智能体的行为即便算不上可预测,至少也是可描述的。
在十二个公开数据集上的结果看起来令人鼓舞:
- 自动机很小——从 7 到 43 个状态,也就是说它们真的可以画出来并在电话会上讨论;
- 在留出数据上,它们复现轨迹的 fitness 不低于 0.997——几乎是完美吻合;
- 在同一数据集的不同划分上构建的拓扑结构,结果几乎相同;
- 构建本身只需毫秒级,而不是数小时的训练。
最后一点比看起来更重要。一个能瞬间构建出来的方法,可以在每次修改提示词或配置之后重新构建——并立刻看到系统的行为是否发生了变化。
为什么这不仅仅是一张漂亮的图
紧凑在这里并不是目的本身。当你拥有 20 个状态而不是数千行文本时,就有机会去讨论智能体的运行模式:这里是「尝试—报错—重试」的循环,这里是「任务转入澄清提问」的分支,这里是一个几乎没有出口的罕见状态。接下来就可以对这些模式做工程化处理——例如,构建按每个状态计算的各类特征。
下一步预测:状态比记忆更重要
为了预测智能体的下一个动作,作者使用了 FSM 的状态上下文。而这种方法在每一个标注与实际执行过程一致的 数据集上都胜过 Agent Workflow Memory。换句话说,「智能体当前处于哪种模式」这一知识,比关于以往工作回合的累积记忆更有用。
这里有一个有趣的细节。状态上下文并不只是节点编号,而是对已经发生了什么、以及接下来以何种概率会发生什么的压缩描述。于是得到了一种可能延续的图谱,它不是建立在文本语义之上,而是建立在转移统计之上。对实践而言,这意味着下一步预测器可以更廉价地训练:它不需要访问模型的隐藏状态,有结构就够了。
失败预测与基于部分轨迹的监控
工作的另一半是关于诊断的。按自动机各个状态计算出的特征,在留出数据上给出的 AUROC 最高可达 0.94。也就是说,一个对 LLM 内部一无所知的模型,仅凭行为特征就能区分哪些运行最终会失败、哪些能走到终点。
这里最实用的是在线监控器。它观察不完整的轨迹,在不等最终结果的情况下,把有问题的运行排在成功运行之上。这足以在智能体彻底走偏之前很早就触发提前停止:节省 token、时间,更重要的是,不让它造成危害。对于会写入数据库、调用支付 API 或管理基础设施的智能体来说,这种中途中断执行的能力不是奢侈品,而是硬性要求。
主要结论:行为由外围框架决定,而不是模型
也许论文中最具挑衅性的论点是:智能体的行为拓扑在很大程度上并非由语言模型本身决定,而是由 deployment harness——模型运行所处的那套外围框架——决定。提示词模板、工具集、错误处理规则、步数限制——正是这些塑造了转移图。
由此可以得出几个结论。第一,在相同外围框架下把模型换成另一个,可能不会从根本上改变行为结构——因此,在一套模型上构建的自动机,值得在另一套模型上验证。第二,改进智能体往往通过修改 harness 比通过升级权重更有效。第三,出现了一种与模型无关的结构性原语:无论你调用的是谁的 API,同一套方法都适用于安全审计和运行时监控。
值得记住的几点
这种方法并不免除谨慎。十二个数据集仍然是一个有限的样本,而 fitness 0.997 说明的是自动机对已经收集到的轨迹描述得有多好,而不是它能预测系统在陌生环境中的行为。用于失败预测的高 AUROC 也是在具体任务上得到的:在新的领域里,特征需要重新计算。
尽管如此,这个方向看起来是靠谱的。与其无休止地扩大上下文窗口并指望模型「自己会搞明白」,不如一次性为自己外围框架构建一个紧凑的行为模型——然后把它当作一张图来使用:看智能体卡在哪里、哪些状态会导致失败,以及如果调整配置会发生什么变化。自动机并不比 LLM 更聪明,但它更诚实:它可以被完整地装进脑子里,而这已经是调试成功的一半。


