
分子科学长期以来被认为是人工智能最有前景——也最复杂——的方向之一。arXiv:2608.23104 预印本《Molecular LLM Agents: From Architectural Design to Scientific Autonomy》正是对此的探讨:25 页,分类为 cs.CL 和 cs.AI,2026 年 8 月 24 日的 v1 版本以及 8 月 25 日的修订版 v2。作者团队包括 Jiatong Li、Wengyu Zhang、Weida Wang、Yuxuan Ren、Wei Liu、Chenyang Mao、Yuqiang Li、Yatao Bian、Changmeng Zheng、Xiaoyong Wei 和 Qing Li。这项工作引人注目的不是又一次刷新基准测试纪录,而是试图厘清术语:究竟什么才算分子智能体,它由哪些节点构成,以及它能在多大程度上自主行动。
分子智能体与“普通”智能体有何不同
对话助手和代码智能体生活在文本、代码仓库和网页的世界里。它们所操作的工具几乎总是接收和返回可以用眼睛阅读的内容。但化学领域行不通:分子不是段落。
领域智能体必须同时处理多种互不兼容的数据类型:
- 符号表示法,如 SMILES——紧凑的字符串,其中一个错误的字符就会把候选药物变成另一种物质;
- 分子图,其中重要的不仅是原子,还有键序、电荷、立体化学;
- 三维构象——因为分子的性质由其形状决定,而不仅仅是化学式;
- 光谱和模拟结果——长长的数值序列,需要从中提取意义;
- 来自“湿”实验室的测量数据,即针对真实物质而非文件的实验数据。
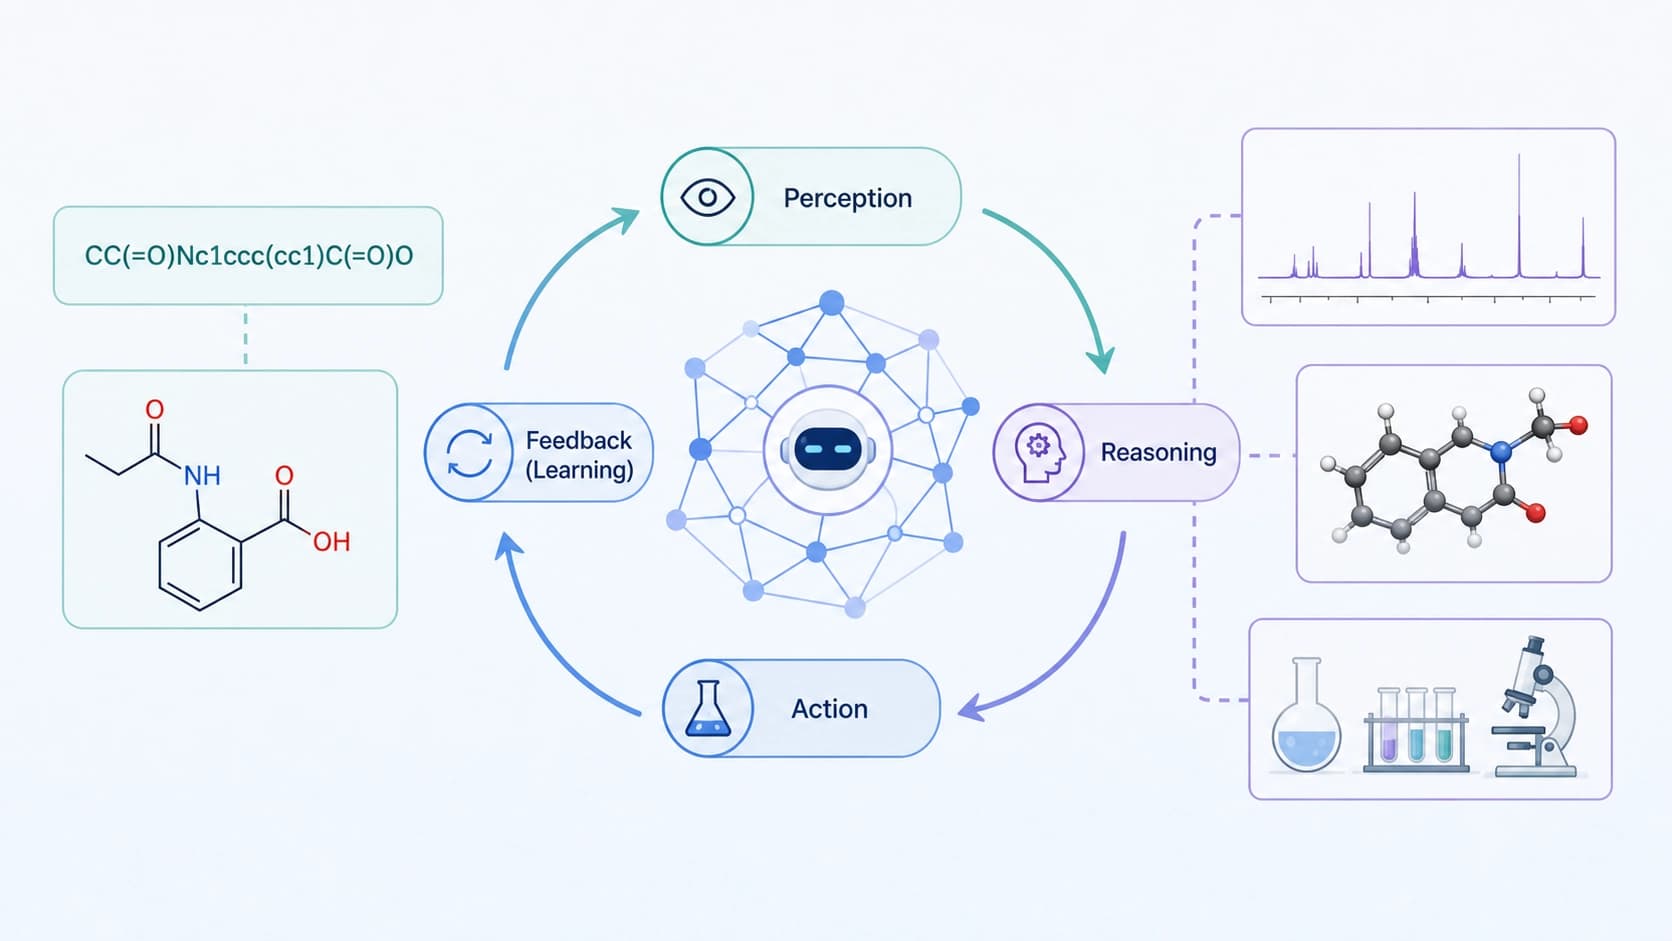
由此引出作者的核心观点:这类智能体的能力并非来自单一出色的模型,而是同时建立在多个支柱之上。它需要化学上正确的分子对象感知能力、以语言模型为核心的智能体框架、与特定领域绑定的工具,以及反馈通道——计算反馈或实验反馈。在此之上,还需要规划和及时调用合适工具的能力。
架构视角:分子智能体由什么构成
文章两个视角中的第一个是工程视角。作者将构造拆解为四个层次,并建议以这种方式审视任何现有项目。
感知:分子是对象,而非段落
语言模型是在文本上训练的,因此它们起初会把 SMILES 字符串看作一组 token,很容易“幻觉”出不存在的化合价。这里与领域模型的结合会有所帮助:例如,AlphaFold 展示了专用架构如何比通用架构更精确地解决狭窄的分子任务。对智能体而言,这意味着一个简单的道理:在推理之前,它必须能够验证——检查分子是否真实存在,其图是否与化学式一致,在格式转换之间立体化学是否丢失。
框架、工具箱与训练
第二和第三层是“大脑”和“双手”。语言模型负责规划并决定运行哪种计算;领域工具箱为它提供对接、量子化学计算、数据库检索、性质预测。ChemCrow 智能体是这种思路的一个很好的例子:在那里创造价值的不是模型本身,而是它所调用的精心描述的工具。
第四层是训练与优化。智能体可以在成功决策的轨迹上进行微调,也可以仅仅改进工具的描述和选择策略。第二条路径更便宜,作者明确暗示:这一领域一半的失败并非源于模型太弱,而是源于设计糟糕的反馈回路。
科学自主性阶梯:L1–L4
文章的第二个视角就是那条“自主性阶梯”,借用了工程系统中等级逻辑的思路。它的作用在于,不必抽象地争论“智能体是否聪明”,而是理解它实际承担了多少决策。
L1——固定流程的助手
在这里,人类设定步骤顺序,模型执行单独的操作:转换结构、计算描述符、提出方案。几乎没有自主性,但可预测性最高。
L2——自适应计算智能体
智能体自行决定调用哪个工具以及以何种顺序,在出错时重新规划,完全在数字回路中工作。这是当今的主流:风险仅限于计算错误,而非样品损坏。
L3——考虑真实实验结果的智能体
最有趣也最危险的层级。智能体不仅进行规划,还从物理实验室获取反馈——光谱、色谱图、合成数据——并据此调整计划。这类系统的例子已经存在:Coscientist 展示了借助实验室自动化进行合成规划。但正是在这里,错误的代价不再是抽象的:错误的一步会消耗试剂、仪器时间,最坏的情况下还会危及人员安全。
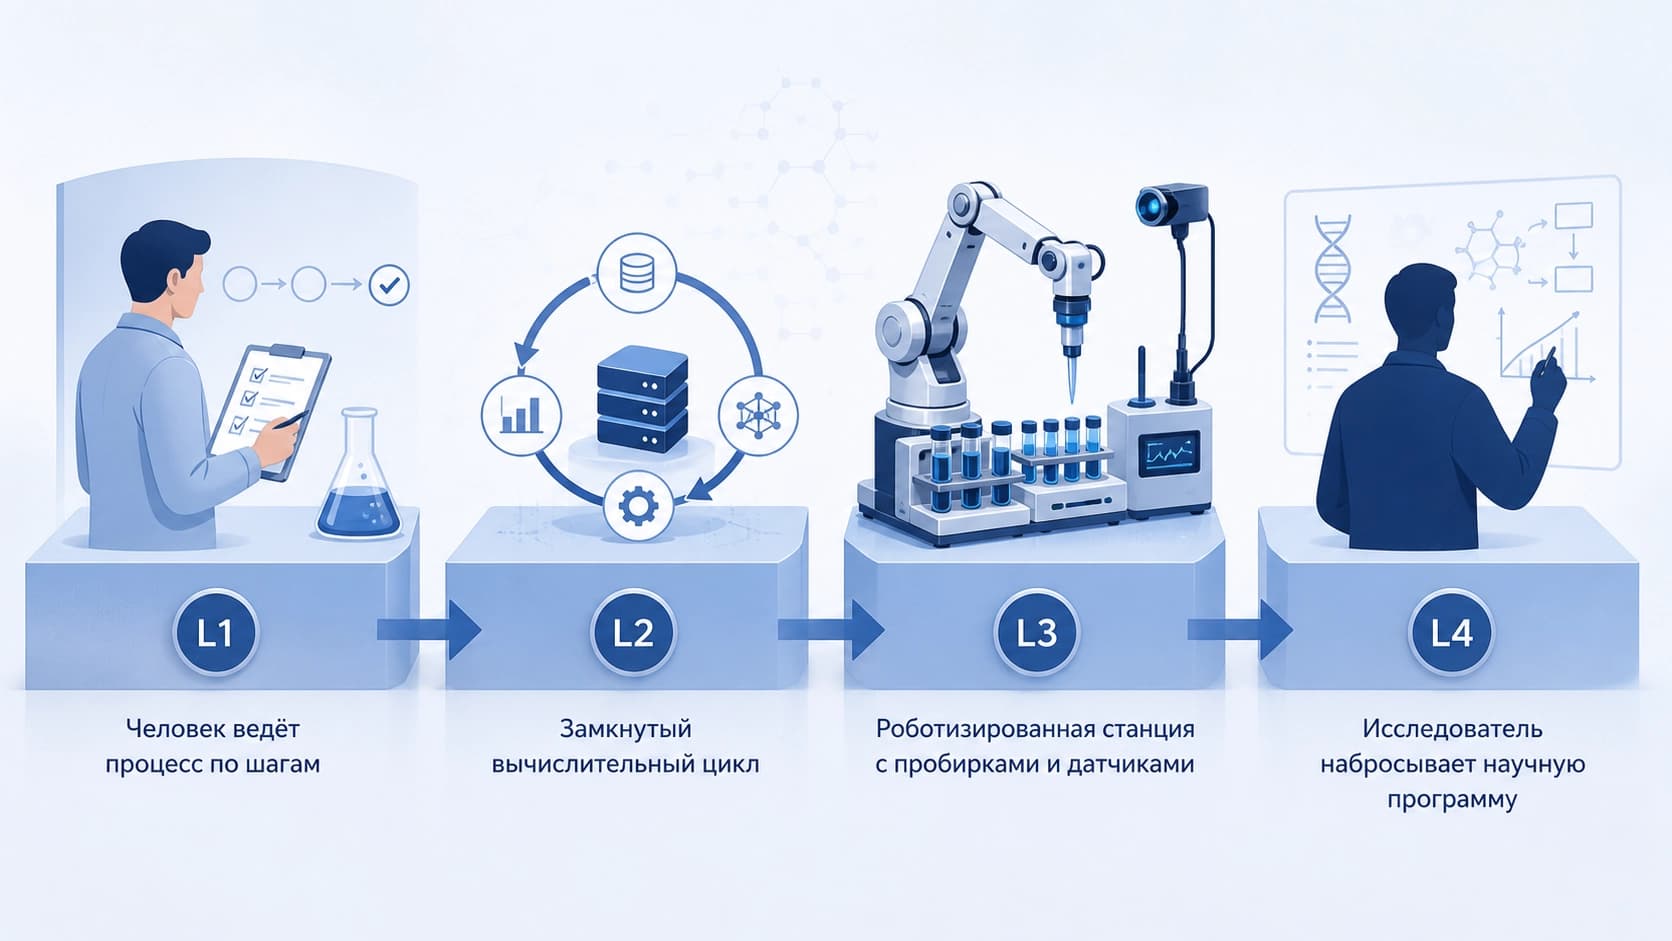
L4——塑造科学议程的智能体
最高一级——系统自行选择要验证哪些假设、哪些方向应被视为优先,以及在哪里寻找文献中的空白。目前这更像是一个方向标,而非对可行方案的描述。但正是它指明了方向:“快速执行者”与“共同构思者”之间的区别是根本性的,值得用语言而非直觉来界定。
为什么需要这样的框架
这两个视角的实际价值在于能够比较不可比较之物。如果两个智能体都自称“自主”,但一个在模拟器中运行,另一个操控合成机器人,那么它们属于不同责任等级的体系。
作者建议将该框架用于三项任务:
- 诊断。 将智能体按层次拆解后,可以看出它的短板在哪里:在分子感知、工具还是规划方面。
- 风险评估。 层级越高,故障后果越严重——也就越需要在行动前而非行动后进行检查。
- 设计。 理解任务实际需要哪个自主性等级,可以避免在本只需精心设计的 L2 的地方去构建 L4 的诱惑。
局限与尚未解决的问题
一个诚实的说明:这条阶梯是概念模型,而非经过测量的量表。它有助于思考,但不能替代验证、认证和结果的可复现性。此外,化学很难容忍“差不多正确”:文本中的笔误——令人遗憾,结构式中的笔误——已经是另一种物质了。
一个单独未解决的问题是数据。来自真实实验室的反馈昂贵且稀少,没有它,L3 智能体只能停留在理论层面。第二个问题是可解释性:化学家需要理解系统为什么提出了这条合成路线,否则就不会有信任。
要点速览
分子 LLM 智能体不仅仅是“化学加聊天机器人”。它是一个独立的系统类别,其中语言模型充当图、光谱、计算软件包和实验室设备之间的调度器。arXiv:2608.23104 这项工作的价值首先在于其术语体系:四个架构层次和四个自主性等级提供了共同语言,用来讨论这类智能体已经能做什么、还缺什么,以及有用的日常加速与最好留给人类来做的决策之间的界限在哪里。


