
选择编码器时用错了指标
人们通常在选择冻结编码器时只看一件事:在它的表示之上训练一个轻量头部——线性层、小型 MLP 之类——效果有多好。如果简单头部就能提取出所需特征,就认为这个编码器不错。但这种评估回答的是"从这些嵌入中读取信息是否方便",而不是"特征本身是否被空间的几何结构所区分"。这是两个不同的问题,把它们混为一谈代价高昂:在任务简单、类别不多时,头部会掩盖表示的弱点。
平衡问题另当别论。当各类别大致均衡时,"编码器有能力"和"头部能提取"之间的差异几乎看不出来。一旦某个类别变得稀少,基于最近邻的指标就开始系统性地失真。
为什么基于最近邻的不一致性会失真
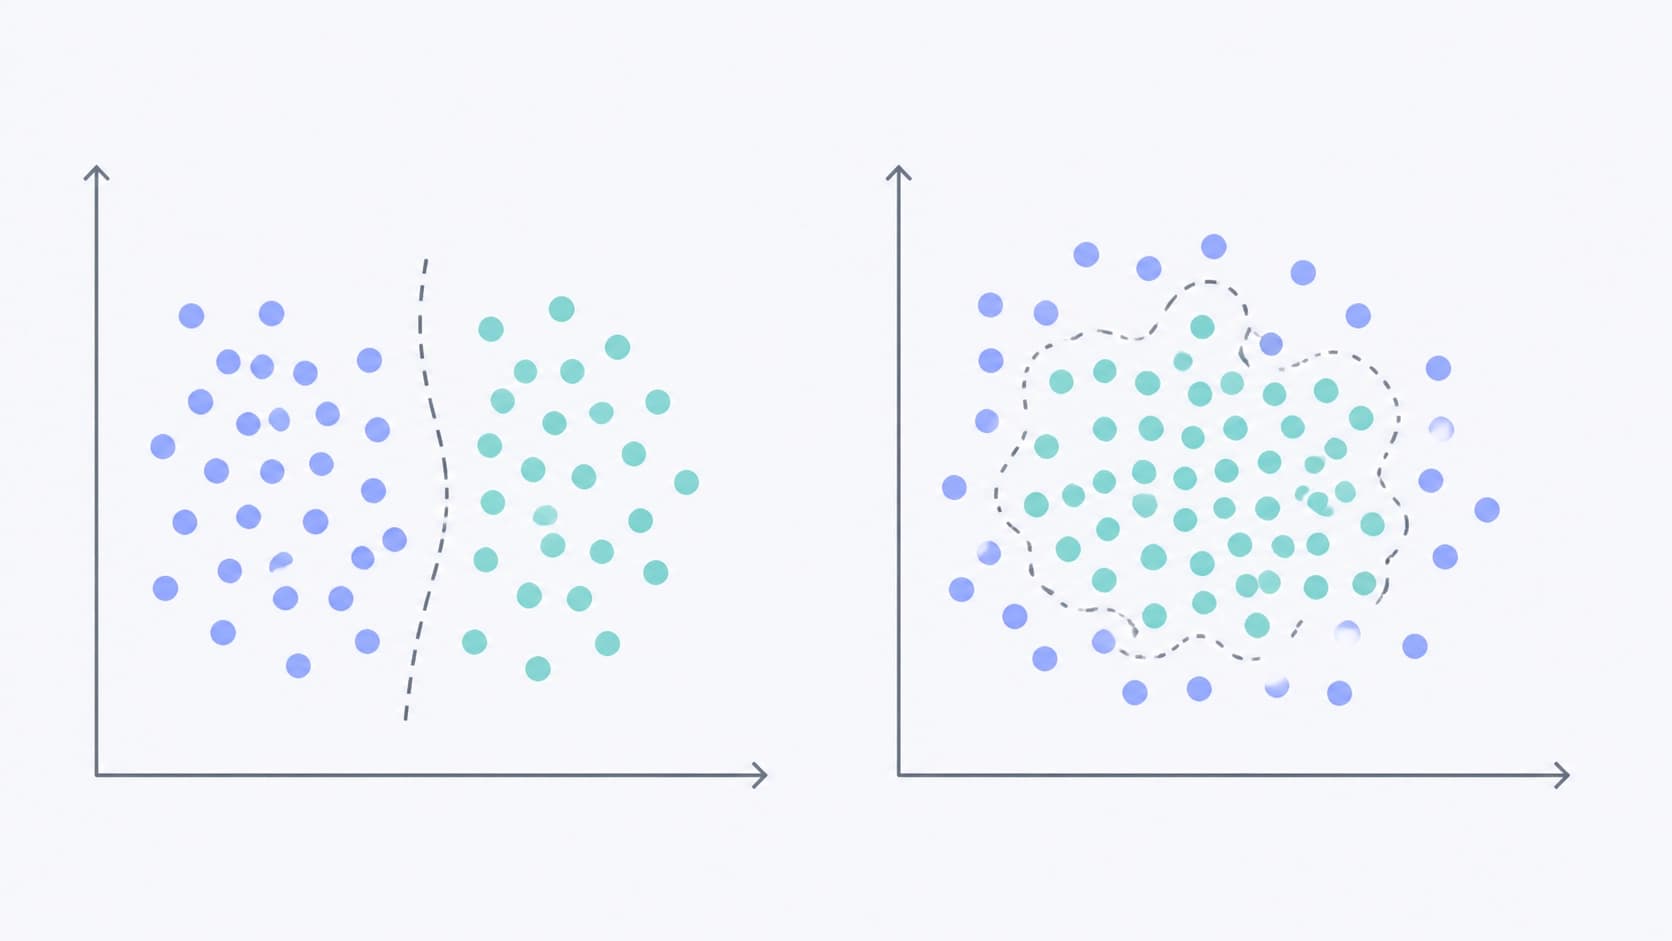
经典的不一致性指标构造很简单:对每个点,在嵌入空间中寻找邻居,如果最近邻带有相反的标签——就把该样本记为不一致。在单个类别内部,几何结构表现极好,对邻居没有任何异议。
问题出在流程的不对称性上。当正例和负例的邻居是从不同大小的集合中采样时,带有相反标签的最近邻胜出,不是因为几何结构如此,而是因为它的类别在邻域中分布得更密集。换句话说,类别流行度(prevalence)——数据集的统计量,而非表示的性质——渗入了结果。这个效应令人不快:一个完全无信息的编码器开始看起来像是盲的,而实际上它和一枚诚实的硬币一样无用,并不更差。
CANDOR 究竟改变了什么
CANDOR——Chance-Calibrated Discordance in Frozen Foundation Encoders(冻结基础编码器中的机会校准不一致性)——重新定义了计数流程本身。这里的邻居库按等大小采样,指标构造对标签置换是对称的:把正例和负例互换,数值不变。因此,随机猜测的水平被固定在恰好二分之一——50%。不是"大约一半左右,取决于数据集",而是严格的 1/2 基准点。
这不是表面上的修正。正是浮动的基准点妨碍了编码器之间以及数据集之间的比较:在不平衡更严重的地方,随机猜测看起来比实际更差,模型获得了不应得的信任。当基准点被固定后,比较才变得公平。
还有一个对实践很重要的细节:既然基准点固定,CANDOR 可以在训练任何头部之前计算。无需微调,无需调超参数——该指标描述的是表示本身,并提前提示某个具体的冻结编码器对哪些发现支持得不好。
大规模验证
作者进行了广泛的评估:22 个编码器,来自 7 个学科领域的 20 个数据集,总计 605,443 张图像。如此大的规模正是为了把指标效应与单一任务的特性区分开来。
结果颠覆了旧流程得出的结论。经过修正后,表示的坍缩几乎在所有地方都低于随机猜测水平。这样解读:所检验的编码器没有一个是盲的——表示中确实存在关于特征的信息——但它们全都很弱。"全都弱,没有一个是盲的"这一表述听起来比之前的说法温和,却更准确地描述了现实。
临床案例:强头部配弱几何
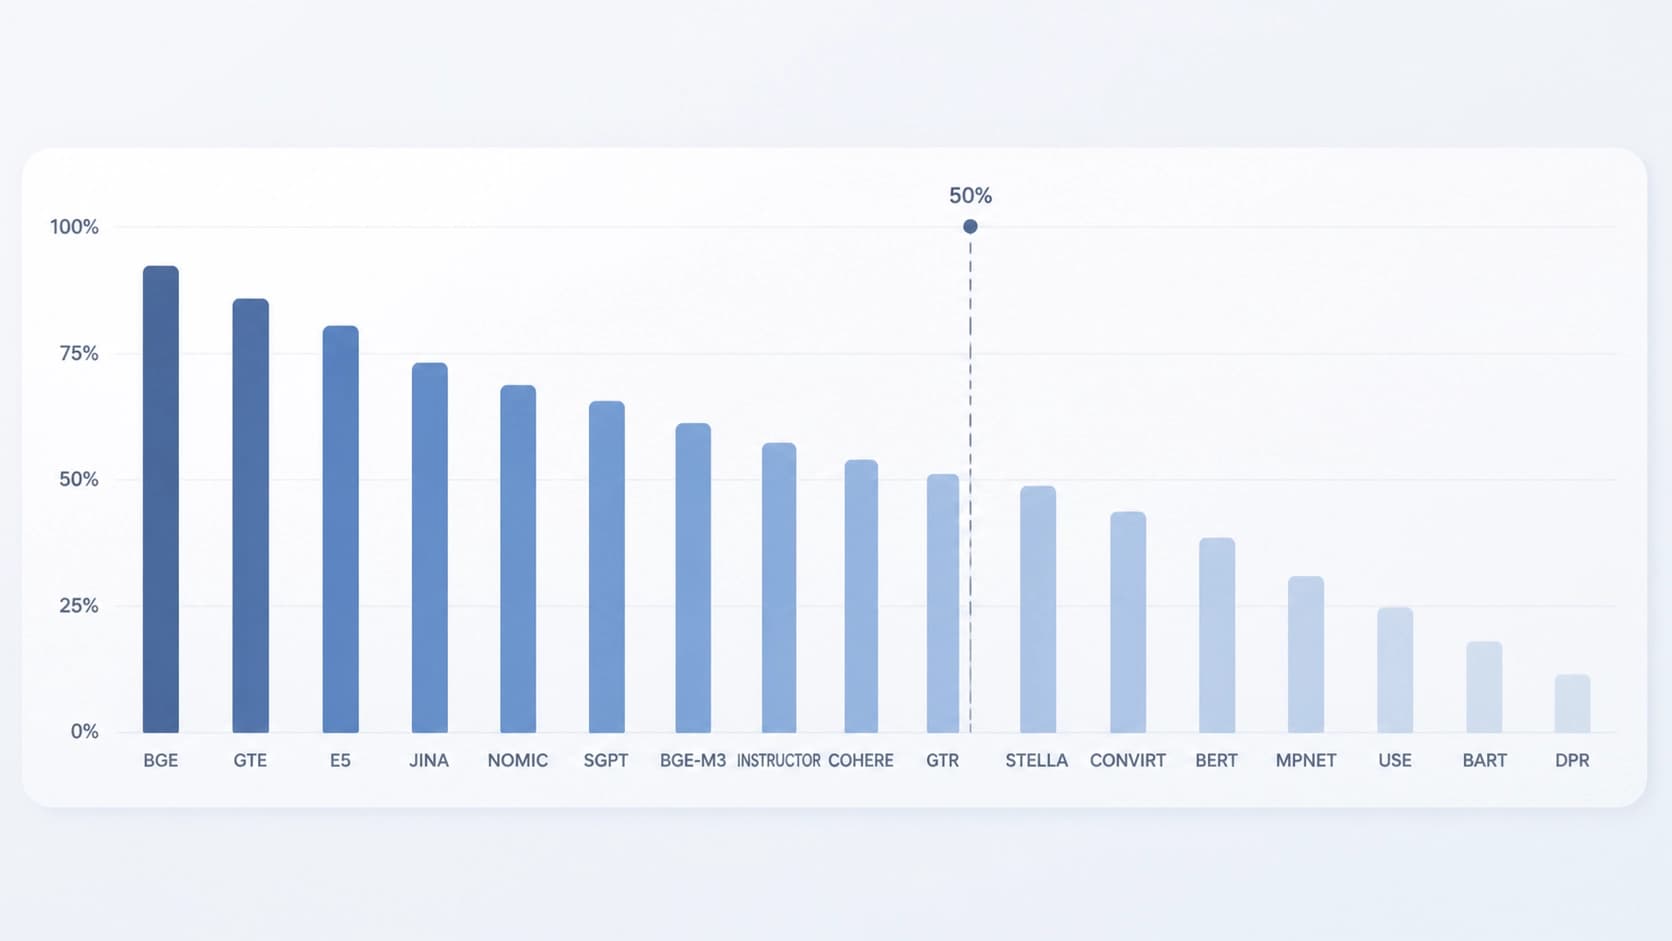
最直观的例子是医学影像。用于胸部的最佳模型读取气胸的 AUROC 为 84.5。这个数字很扎实,通常也是选择模型时看的指标。但同一个模型把 18.4% 的正例放得离带有相反标签的图像更近,而不是离带有相同发现的自身图像更近——还是在同一家医院内,也就是说不能用域偏移来解释。
"头部很好地解决了任务"与"几何结构混淆了正例和负例"之间的落差——这正是那种分歧。头部补偿了弱表示;CANDOR 指标显示,需要补偿的量很大。
接下来是跨领域的比较。同一个编码器区分鸟类物种的水平达到 4.5(即几乎完美),而胸部发现停留在 42.8,青光眼为 49.8。最后一个数字处于随机猜测水平,实质上——比随机权重还差。同一个编码器,同一次训练,三种截然不同的几何质量。
是选择不足,而非信息不足
由此引出一个自然的问题:那么表示是没救了吗?不完全是。随机性限制了任何 Lipschitz 头部——即对输入扰动敏感度受限的头部——的归一化间隔(normalized margin)。然而,在十一个头部组成的集合中,存在一个头部除 2.8% 的情况外全部正确,而单独一个头部则在 35.9% 的情况下出错。表示中确实存在关于特征的信息——只是它对不同的读取器并非同等可及。因此,不足与选择(selection)有关,而非信息的缺失。
在另一处还发现了有趣的关联:擦除保留(erasure retention)与坍缩相关。而与训练目标、模型规模、发布时间或发现大小则未发现关联。简而言之,"拿一个更大更新的模型"并不能解决问题——它无关规模,也无关新旧。
这对实践意味着什么
三个实践结论。
- 在训练头部之前计算 CANDOR。 这是一项廉价的检查,能显示编码器是否支持某个具体的罕见发现,让你在花时间调优之前就筛掉不合适的骨干。
- 不要把头部的 AUROC 与表示质量混为一谈。 84.5 配 18.4% 的不一致正例——这是正常而非罕见的情况,值得单独测量。
- 不要指望规模和新鲜度能解决一切。 未发现与规模、训练目标和新旧程度的关联;冻结编码器的弱点看起来是系统性的。
这个故事的主要价值甚至不在于指标本身,而在于被颠覆的结论。以前人们以为编码器对某些类别"盲"。经过机会校准后,看到的却是另一番景象:它们几乎处处都看得见,但处处都很弱。这是一幅远没那么戏剧化、却远更实用的图景——有了它,就清楚该修什么、按什么顺序修。


