
WILSON: объединение увеличений и стёкол пациента для патоморфологического анализа и формирования заключений
Препринт представляет WILSON — vision-language модель, которая кодирует изображения целых стёкол и серии препаратов одного пациента при разных увеличениях, а не только отдельный «лучший» слайд. Без дообучения под задачу она обходит специализированные и более крупные слайды-модели по ряду метрик при существенно меньшей вычислительной нагрузке, а её диагностические описания получили более высокие оценки патологов.
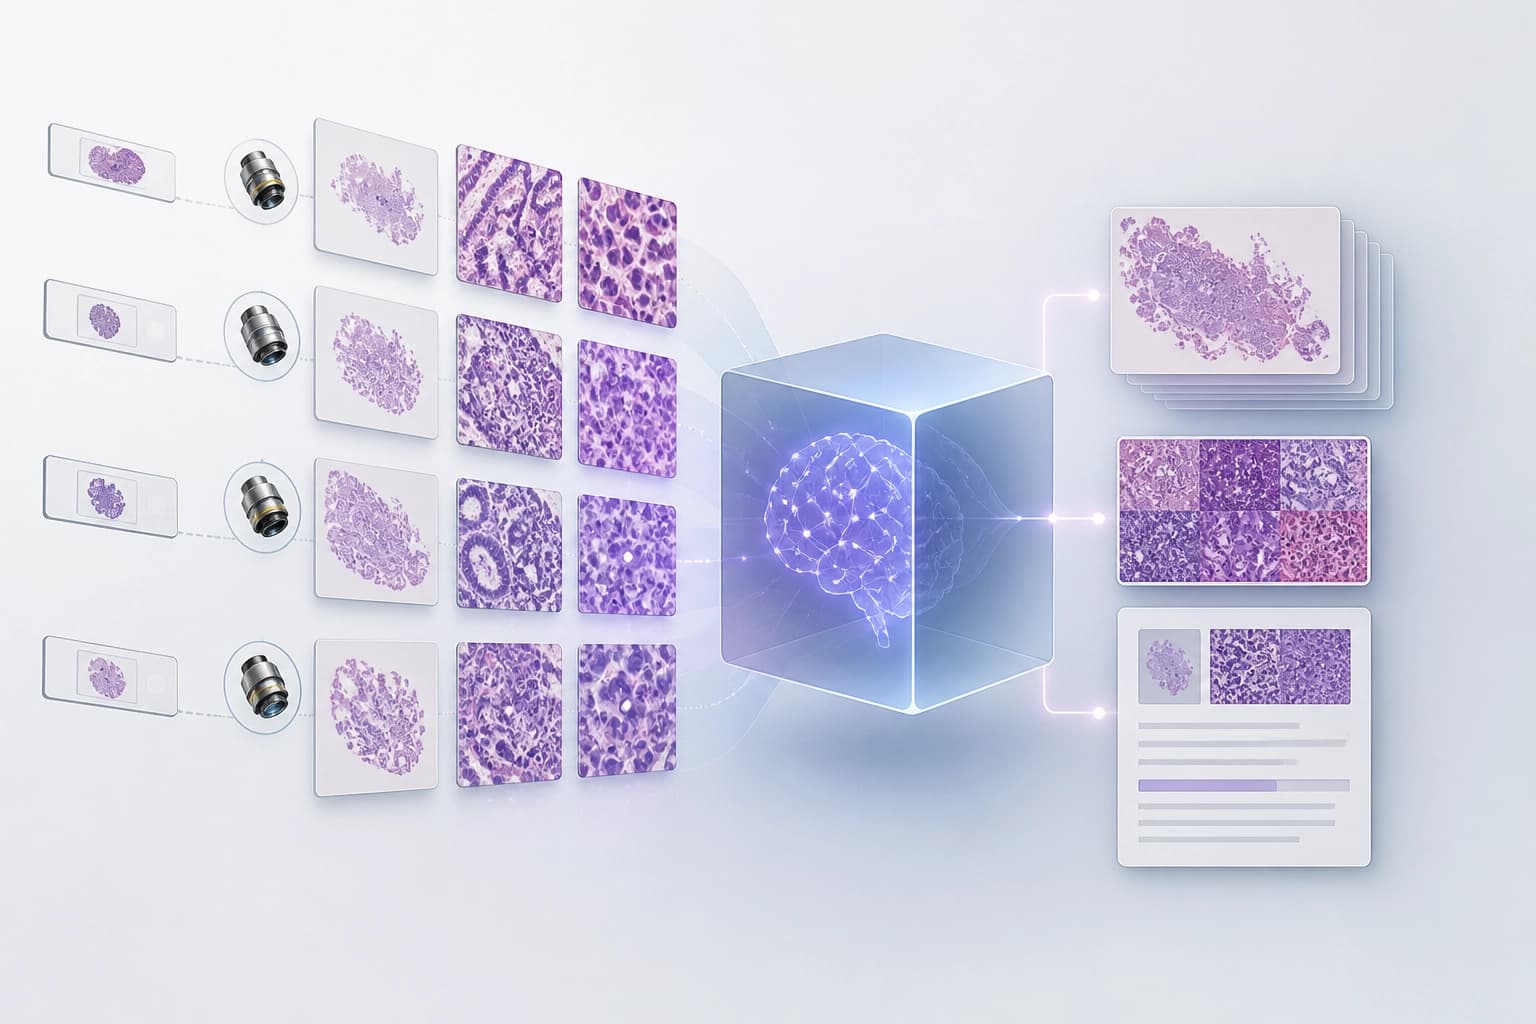
Почему одного репрезентативного стекла недостаточно
Патологи исследуют срезы тканей при разных увеличениях и на нескольких предметных стёклах. Они объединяют морфологическую информацию для постановки диагноза. Большинство foundation-моделей для патологии кодируют тысячи фрагментов изображения с одного репрезентативного («best») стекла. Затем модели агрегируют эти признаки.
Ограничения такого подхода:
- модель получает одно «best» стекло, а не весь случай;
- признаки с разных увеличений не связываются в общее представление;
- контекст на уровне пациента теряется при агрегации фрагментов.
Практический критерий: для case-level задачи нужна модель, которая принимает несколько стёкол и разные увеличения. Один репрезентативный слайд не покрывает такую постановку.
Как модель объединяет увеличения и стёкла
WILSON — vision-language foundation model. Модель представляет whole-slide images и случаи с несколькими стёклами через multi-magnification composites. Она поддерживает анализ на уровне пациента.
Что входит в представление:
- whole-slide images;
- случаи с несколькими предметными стёклами;
- несколько увеличений в составе multi-magnification composites.
Вывод: модель сохраняет морфологическую информацию с разных масштабов и стёкол в одном представлении. Это отличает её от схемы с одним «best» стеклом.
Обучение и охват данных
Обучающая выборка WILSON — около 189 000 слайдов. Данные охватывают 42 органа и 838 диагностических сущностей.
Охват:
- 189 000 слайдов;
- 42 органа;
- 838 диагностических сущностей.
Перечень органов и сущностей задаёт рамку для проверки задачи. Специалист сверяет орган и диагностическую сущность с этим перечнем.
Результаты без task-specific training
WILSON превзошла специализированную case-level model по macro-F1 без task-specific training. Значение составило 0.52 против 0.38.
| Сравнение | WILSON | Альтернатива |
|---|---|---|
| Macro-F1 на case-level задаче | 0.52 | 0.38 |
| Вычислительные операции | в 400–1 350 раз меньше | существенно более крупные slide-level models |
Модель также показала результаты на уровне существенно более крупных slide-level models. При этом ей требуется в 400–1 350 раз меньше вычислительных операций.
Вывод: качество case-level анализа не обязано расти вместе с вычислительной стоимостью. Компактное многомасштабное представление даёт практический ориентир.
Дообучение под конкретные задачи
End-to-end fine-tuning улучшил результаты WILSON в задачах:
- субтипирование рака молочной железы;
- градация stromal lymphocytes.
Практический критерий: для узкой задачи стоит рассматривать end-to-end fine-tuning. Базовая модель без дообучения решает case-level анализ, а дообучение улучшает отдельные задачи.
Поиск и генерация диагностического текста
В image-text retrieval WILSON превзошла PRISM по recall@1. Результат — 75.6% против 58.1%.
| Метрика | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
Диагностические описания WILSON получили более высокие оценки от пяти патологов с board-сертификацией. Конкурирующие модели получили более низкие оценки.
Практический критерий: для поиска и подготовки заключения важны две способности — retrieval и генерация текста. Их проверяют на задачах, близких к рабочему процессу.
Что это значит для выбора модели
Авторы заключают, что компактные многомасштабные представления могут поддерживать вычислительно эффективные и клинически ориентированные foundation-модели. Для практического выбора это означает несколько проверок.
Критерии:
- модель принимает несколько стёкол;
- модель связывает разные увеличения;
- анализ идёт на уровне пациента;
- качество измеряется на case-level задачах;
- вычислительные операции учтены;
- retrieval и генерация текста проверены отдельно.
Вывод: один «best» слайд и агрегация тысяч фрагментов не покрывают контекст пациента. Модель выбирают по тому, как она собирает этот контекст и сколько вычислений требует.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Поэтапная диагностика GUI-агентов при анализе дашбордов: бенчмарк DashAct
Представлен DashAct — бенчмарк из 348 проверенных человеком траекторий, который разбирает работу GUI-агентов с интерактивными панелями на три этапа и четыре визуальных условия. Результаты показывают устойчивые проблемы с предсказанием действий и привязкой к визуальным целям, а также зависимость реакции агентов от контекстной и пространственной поддержки.
11 ноября 2026
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026