
Люди понятны, LLM — нет: эксперты не смогли объяснить логику моделей
Исследователи сравнили скрытые факторы, стоящие за ответами людей и шести языковых моделей на задачи по количественным рассуждениям и химии. Факторы, извлечённые из ответов людей, эксперты успешно интерпретировали, а вот большинство модельных конструктов оказались для них непрозрачными.
Люди понятны, LLM — нет: эксперты не смогли объяснить логику моделей
Когда мы смотрим на результаты тестов, кажется естественным предполагать, что искусственный интеллект решает задачи «как человек»: использует те же понятия, правила и рассуждения. Однако новое исследование ставит это допущение под сомнение. Учёные выяснили, что скрытые структуры, которые определяют ответы LLM, в большинстве случаев не поддаются человеческой интерпретации — даже у профильных экспертов.
Что именно проверяли
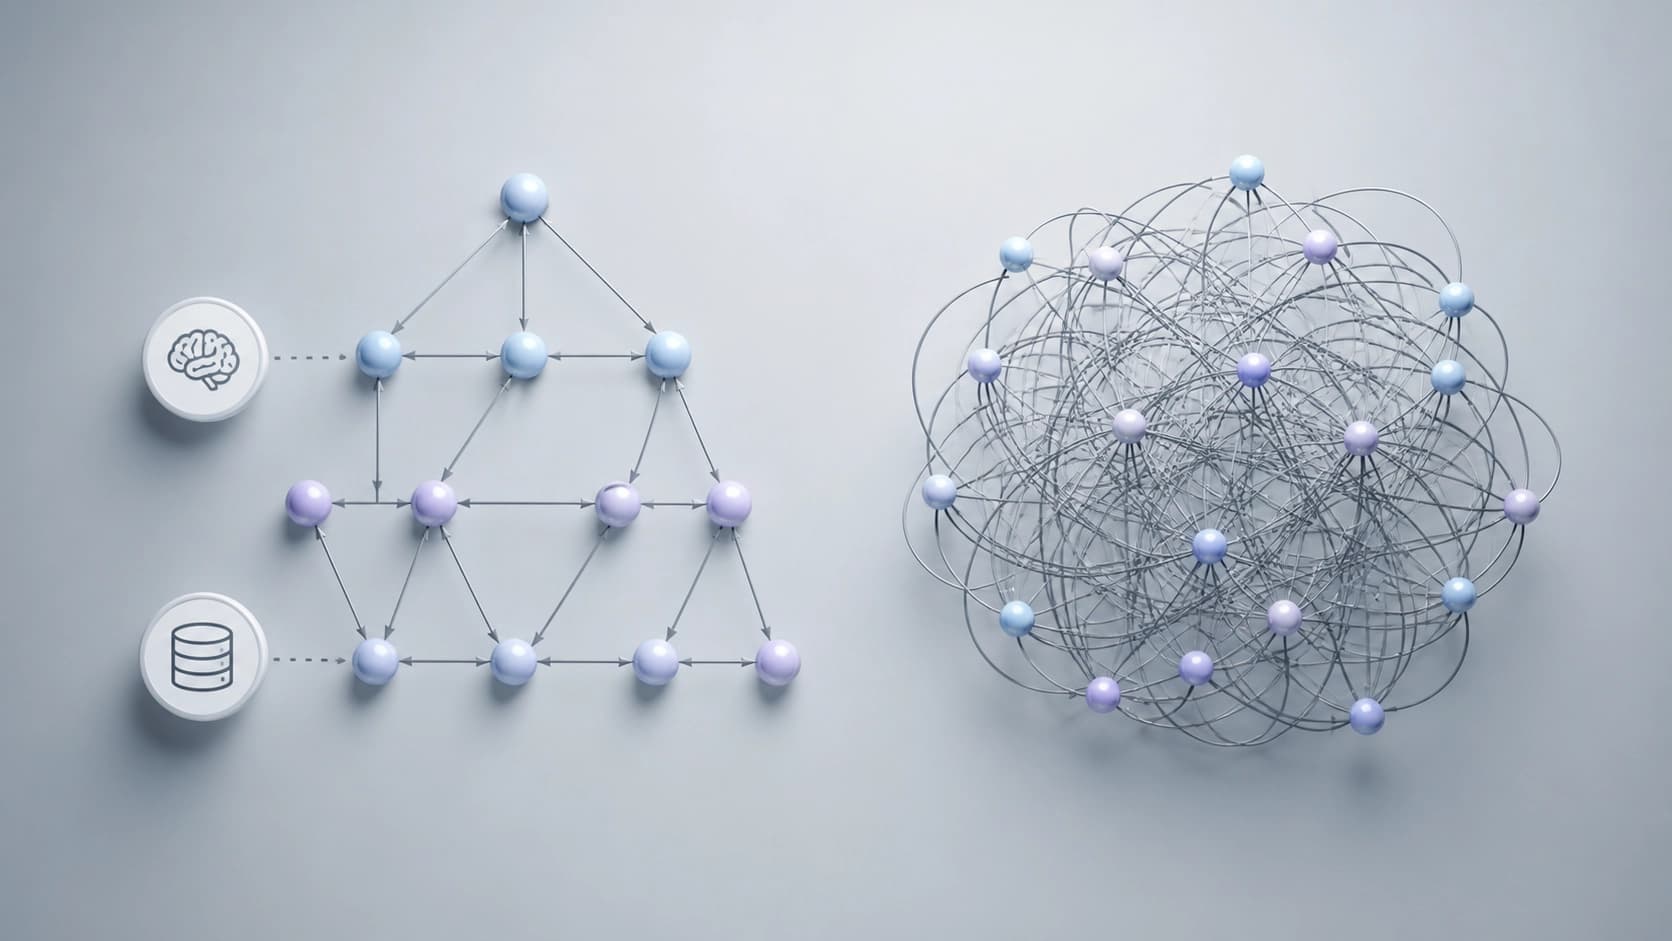
Авторы работы (arXiv:2608.17810) — Алона Стругацки, Ликоль Зейнфельд, Джейсон Купер и их коллеги — взяли ответы людей и шести разных LLM на задания по количественным рассуждениям и химии. С помощью эксплораторного факторного анализа они выделили для каждой группы скрытые латентные факторы, которые предположительно стоят за успешностью выполнения этих заданий.
Затем предметные эксперты вслепую изучали полученные структуры и пытались приписать факторам педагогический смысл: например, «умение работать с формулами» или «понимание стехиометрии». Слепой формат исключал подсказки — специалисты не знали, относятся ли графы к людям или к моделям.
Результат: разрыв в интерпретируемости
Эксперты почти без проблем разобрались в факторах, полученных на основе человеческих ответов. Большинство конструктов получило осмысленное объяснение, которое легко было перевести в рекомендации для обучения или диагностики.
С LLM картина оказалась иной:
- В количественных рассуждениях эксперты не смогли осмысленно интерпретировать ни один из факторов, выявленных для моделей.
- В химии ситуация была чуть лучше, но всё равно далекой от идеала: удалось объяснить лишь около половины структур.
Что это значит
Авторы делают важный вывод: когда LLM показывают высокие результаты на тестах, это не означает, что они рассуждают привычным нам образом. Модели могут находить статистически эффективные, но совершенно «чужие» для человека способы решения задач. Их внутренние механизмы работают на уровне паттернов, которые не несут понятного педагогического или когнитивного смысла.
Это наблюдение бросает вызов распространённой практике, когда по результатам ИИ пытаются делать выводы об уровне знаний или компетенций. Если мы не можем объяснить, какие именно конструкции стоят за ответами, мы рискуем приписывать моделям несуществующие способности — или наоборот, пропускать реальные ограничения.
Куда двигаться дальше
Исследование не утверждает, что интерпретировать LLM невозможно в принципе. Оно лишь показывает, что классический подход, созданный для изучения человеческого познания, не переносится на модели напрямую. Возможно, потребуется разрабатывать принципиально новые методы анализа — такие, которые учитывают «нечеловеческую» природу латентных структур.
Пока же остаётся открытым вопрос: если эксперты не могут объяснить логику моделей, можем ли мы полагаться на их использование в образовании и оценке знаний? Ответ, вероятно, потребует пересмотра как подходов к проверке ИИ, так и наших ожиданий от «интеллекта» машин.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Подтверждение кандидатов дороже их генерации: приманки против LLM-поиска уязвимостей
В работе разобрана ценовая асимметрия агентного поиска дефектов: генерация версий дешева, а их подтверждение через анализ достижимости, исполнение и PoC требует основного бюджета, поэтому верификацию можно сделать самостоятельным объектом обороны. Предложенный RedHerring — подстраиваемые под репозиторий приманки с закрытым сертификатом — при равных затратах снижал число найденных настоящих уязвимостей на 38,7–60,4% в 33 проектах OSS-Fuzz; даже после предупреждения агента падение сохранялось на уровне 37,2%.
9 ноября 2026
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026