
Управляемое развитие LLM-агентов в автономных инвестициях: мультиагентная схема с неизменяемым защитным контуром
Статья описывает Steward — систему из девяти ролевых LLM-агентов, где решения по портфелю проходят проверку риск-менеджера, а изменения промптов допускаются только через обратимый контроль и воспроизведение записанных данных. Ключевой вывод — неизменяемое ядро и процедуры аудита позволяют развивать агентов, не отдавая им контроль над риск-правилами и исполнением ордеров.
Необратимость действий как исходное ограничение
Автономное инвестирование работает с live Web data и untrusted Web content. Каждое действие в такой среде необратимо. Поэтому развитие LLM-агента требует границы между адаптацией и защищённым ядром. В статье «Governed Self-Evolution for Autonomous Investing: A Multi-Agent LLM System with an Invariant Core» авторы описали систему Steward. Это мультиагентная LLM-система для автономного инвестирования. Авторы статьи — Yebo Feng, Jingyang Dai, Liangrui Pan, Nelson Lau, Jiahua Xu, Yang Liu. Авторы подали статью 22 октября 2026 года. Критерий: архитектура должна отделять адаптацию от защищённого ядра. Иначе необратимое действие может опередить проверку.
Мультиагентная схема принятия решений
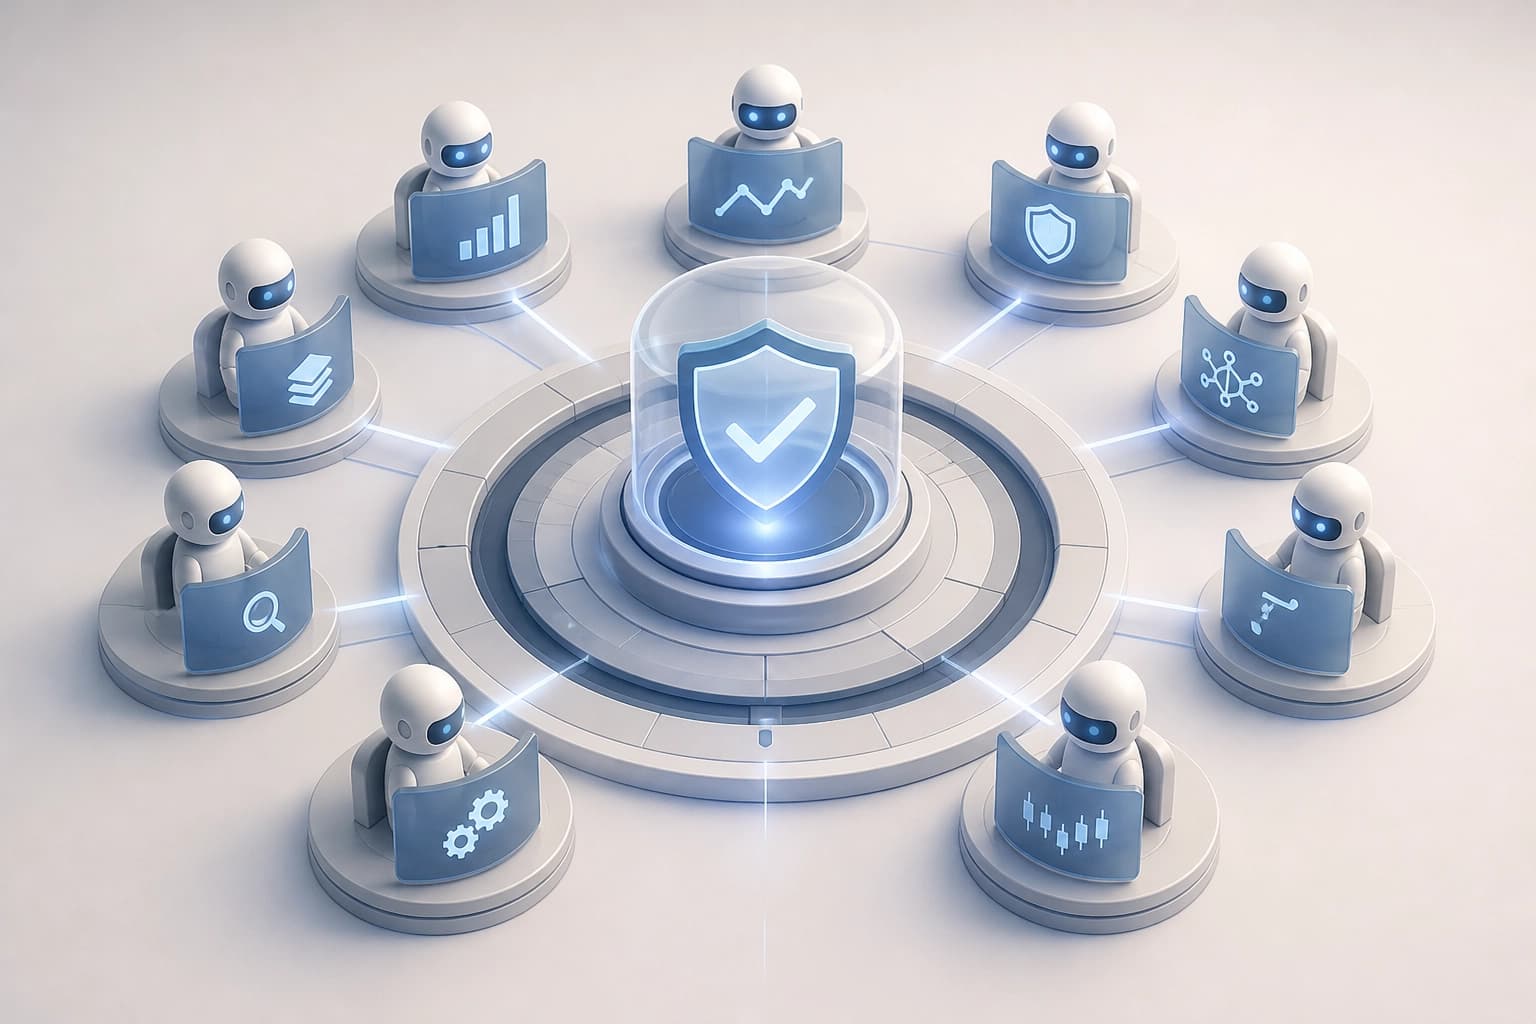
Девять специализированных по ролям агентов принимают решения совместно. Четыре аналитика читают news feeds, SEC filings, macroeconomic series и market data. Они формируют типизированные отчёты.
- Portfolio Manager задаёт целевые позиции на основе этих отчётов.
- Защищённый Risk Manager проверяет целевые позиции. Критерий: у каждого этапа должна быть отдельная роль и проверяемый выход. Типизированный отчёт отделяет исходные данные от решения.
Семислойная память и контекст решения
Код собирает общую семислойную память из записей самой системы. Она даёт каждому решению контекст позиции, рыночный нарратив, калибровку и прошлые решения агента.
Критерий: решение должно опираться на зафиксированный контекст. Память из записей системы хранит этот контекст вместе с прошлыми решениями.
Контур ревизии: ночная оценка и обратимое улучшение
Ревизия идёт по этапам:
- Ночная оценка: код оценивает каждую сделку и прогноз, затем записывает оценки в память.
- Квартальное предложение: reflector предлагает улучшения промптов.
- Применение: детерминированный gate применяет улучшения обратимо.
- Проверка: replay записанных входных данных проверяет результат. Такой контур отделяет предложение улучшения от внедрения. Reflector установил коренную причину главного сбоя. Gate применил найденное улучшение. Агент использовал его в trigger evenings и не использовал ни в один control evening. Критерий: изменение промпта должно проходить через gate и replay. Обратимость и проверка на записанных данных удерживают развитие в контролируемом контуре.
Защищённое ядро и границы самоизменения
Неизменяемое ядро включает три элемента:
- арифметику ордеров;
- правила риска;
- промпты дисциплинарного агента. Самоизменение не может затронуть эти элементы. Ядро задаёт предел развития системы. Критерий: контур самоизменения не должен затрагивать эти элементы. Их изменение не должно зависеть от работы reflector.
Проверка в live-режиме, replay и backtest
В пятимесячном live deployment (102 торговых дня, 1 632 вызова LLM) система ограничила просадку сектора 24,6% убытком 0,3%. В replay записанных входных данных одна модель получила те же raw data. Она торговала чаще и за пять дней уступила рынку 1,35 пункта. Совместная система за этот период не показала значимого убытка. Система не выполнила ни одну внедрённую инструкцию. В backtest за 2015-2026 одно лишь ядро снизило максимальную просадку при всех 50 random entry policies.
| Проверка | Что проверялось | Результат из статьи |
|---|---|---|
| Live deployment | Работа с live Web data | Система ограничила просадку сектора 24,6% убытком 0,3%; 102 торговых дня, 1 632 вызова LLM |
| Replay | Одна модель на тех же raw data | Торговала чаще; за пять дней уступила рынку 1,35 пункта |
| Replay | Совместная система | За тот же период не показала значимого убытка |
| Replay | Внедрённые инструкции | Система не выполнила ни одну |
| Backtest 2015-2026 | Одно лишь ядро | Снизило максимальную просадку при всех 50 random entry policies |
Критерий: проверять систему в live, replay и backtest отдельно. Каждый режим отвечает на свой вопрос и не заменяет остальные.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Британский инспектор по иммиграции решает, проверять ли GPT-4 в Home Office
Независимый надзорный орган по границам и иммиграции запросил у правозащитной организации сведения о двух системах на базе OpenAI, которые Home Office применяет при работе с материалами просителей убежища. Статья объясняет, почему сомнения в точности сводок, отсутствие публичного реестра и скрытость применения могут привести к официальной проверке и юридическим претензиям.
3 ноября 2026
Переход к вероятностному симплексу сокращает модальный разрыв в контрастивных мультимодальных моделях
В работе arXiv:2610.32890 предлагается заменить сферические эмбеддинги вероятностным симплексом, добавив лёгкие softmax-адаптеры и сходство Total Variation. На пяти бенчмарках поиска центроидное ℓ2-расстояние между модальностями снижается на 97–99% при сохранении или росте качества поиска.
3 ноября 2026
Как ActionRAG пересматривает свидетельства при диффузии по графу памяти LLM-агентов
Предложена архитектура графовой памяти, которая на этапе индексации аккуратно согласует сущности, а при запросе заново оценивает связи с опорой на локальную структуру. На MemoryAgentBench метод показал среднюю точность 55,1 и прирост 5,4 п.п. к сильнейшему извлекающему baseline при стоимости синтеза ниже $0,001 за запрос.
3 ноября 2026