
RLTLDR: агент сам формулирует вывод из неудачи и учитывает его в следующей попытке
После провала агенту показывают сигнал верификатора и просят сжать его в одну подсказку; обучение идёт на связках «задача — подсказка», без учителя и эталонных решений. На сложных наборах для программирования и вызова инструментов метод поднимает Pass@1 с 0–1% у GRPO до 12–31%, причём решающий вклад даёт именно усвоение такой связки.
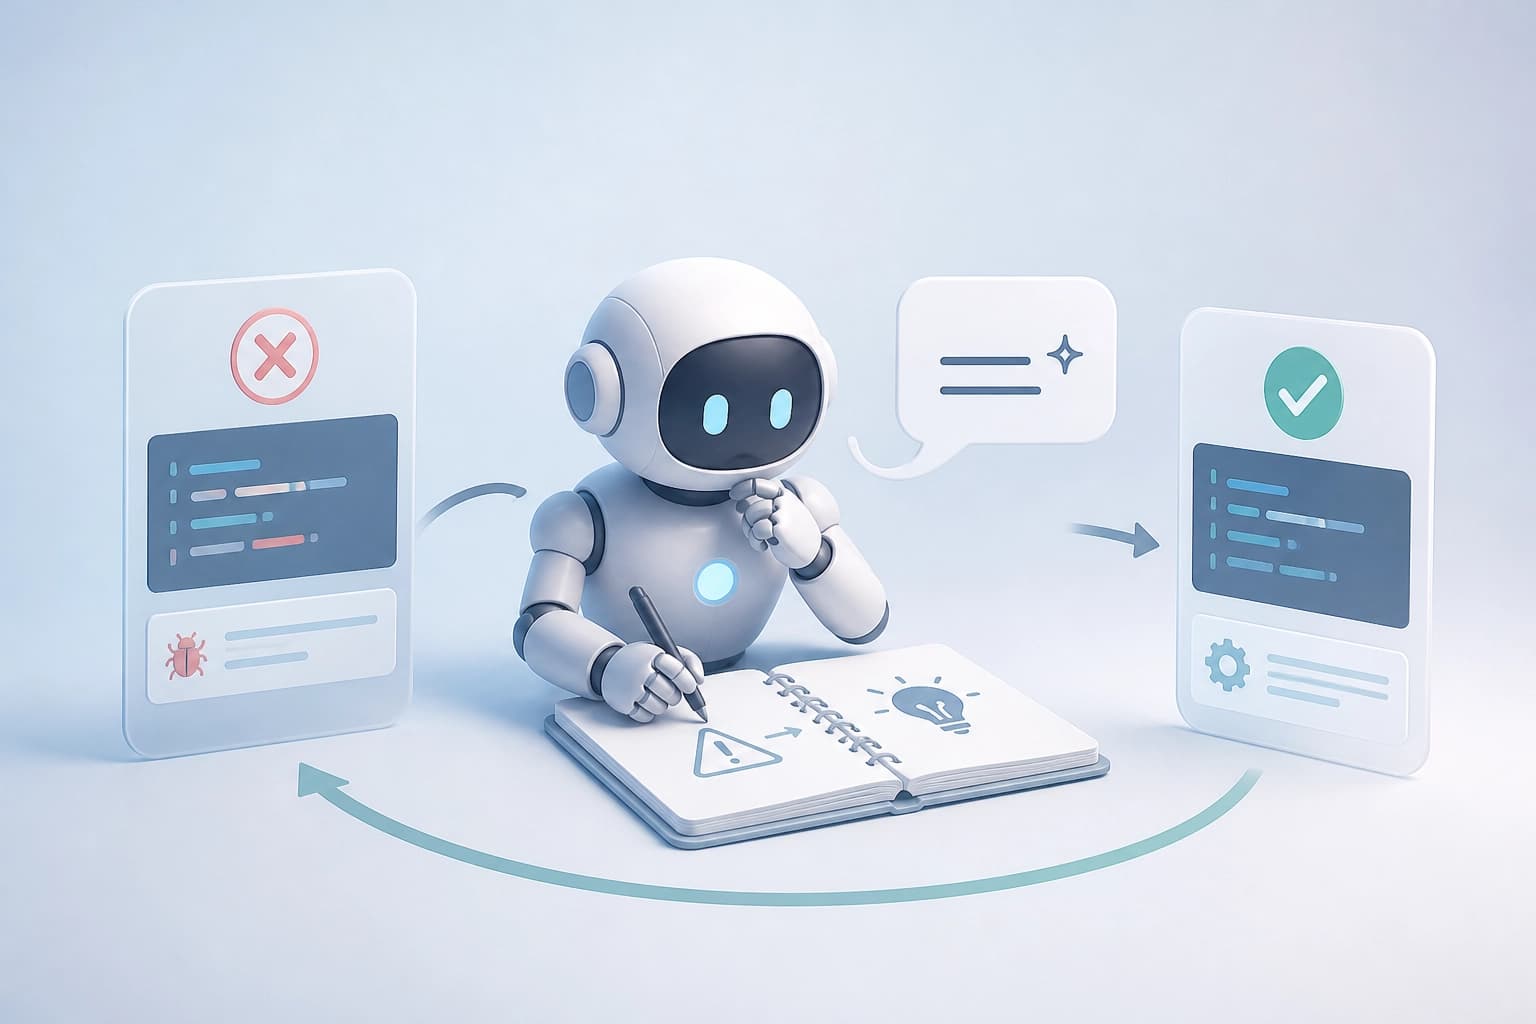
RLTLDR — метод самоулучшения агента в задачах, где успех даётся тяжело. После неудачной попытки агент видит вывод верификатора и сам формулирует один краткий вывод — TL;DR insight. Следующая попытка учитывает все предыдущие выводы. Работа Michael Kirchhof, Eleonora Gualdoni, Andrew Szot и соавторов описывает этот подход. Первая версия подана 29 сентября 2026 года. Последняя редакция — 19 октября 2026 года.
Задача, которую решает RLTLDR
RLTLDR нацелен на самоусовершенствование агента. В таких задачах агенту трудно добиться успеха. Моделей-учителей и примеров решений для дистилляции нет. Поэтому источником обратной связи становится неудача и вывод верификатора.
Условия задачи:
- нет моделей-учителей;
- нет примеров решений для дистилляции;
- агенту трудно добиться успеха;
- после неудачи доступен вывод верификатора.
Вывод: RLTLDR нужен там, где нет готовых решений и учителя, но есть проверяемая неудача. Практический критерий — наличие верификатора, чей вывод можно передать агенту.
Как работает цикл
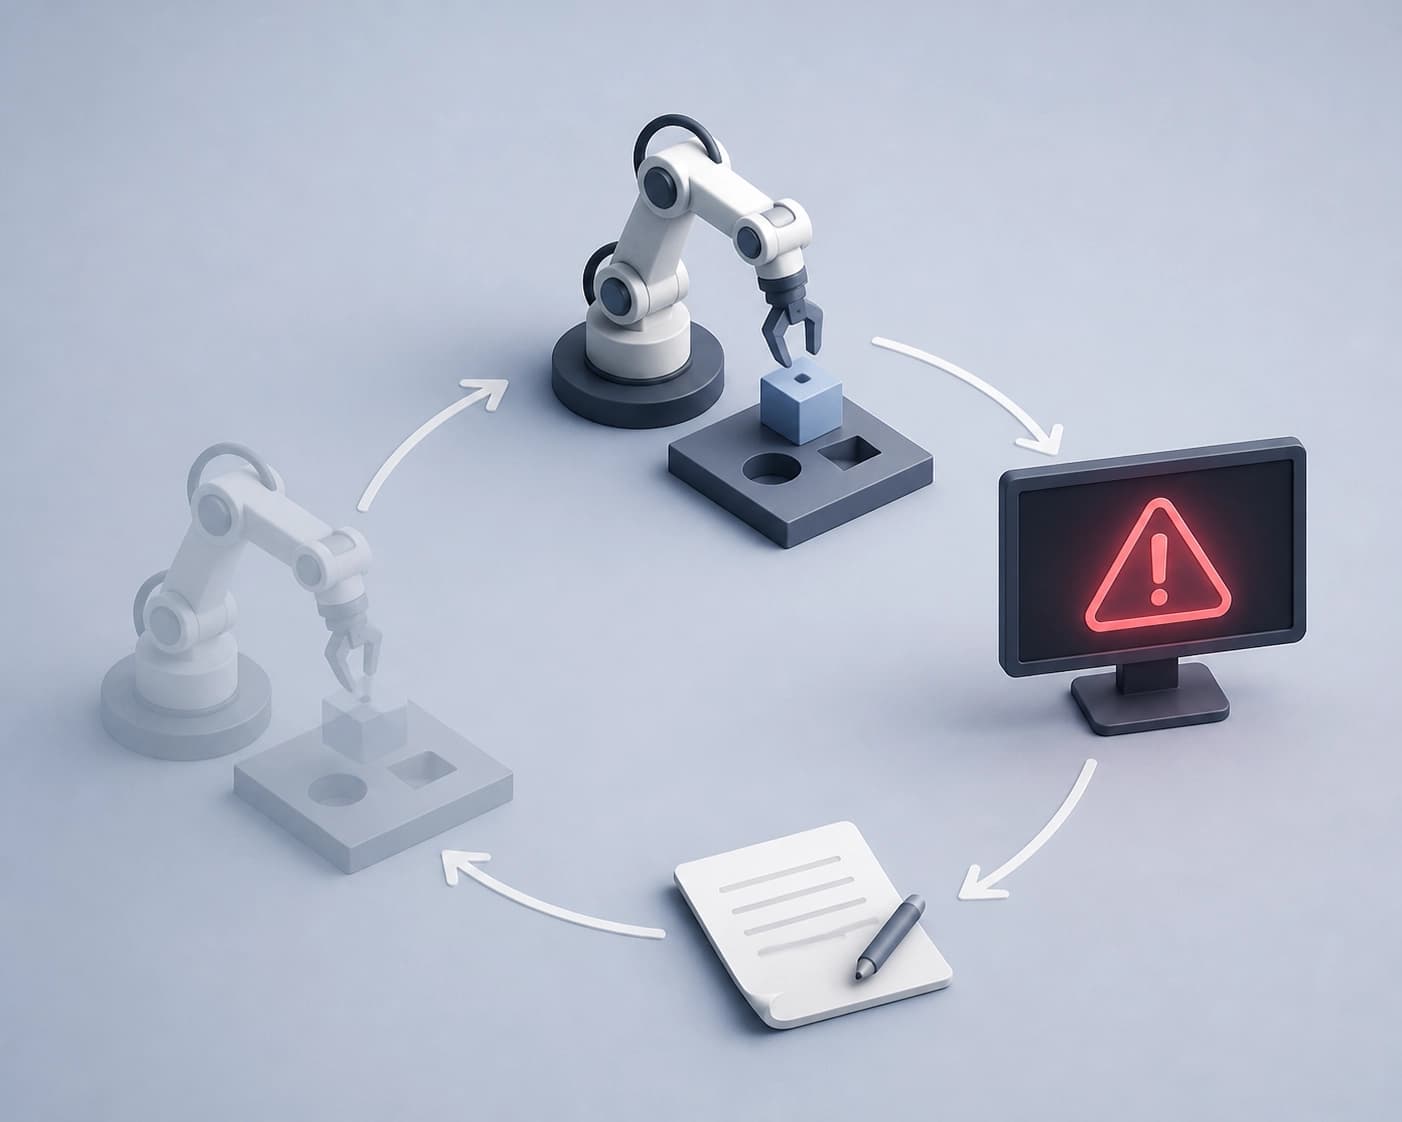
Цикл RLTLDR строится вокруг последовательных попыток. Каждая неудача даёт материал для следующего шага.
Этапы:
- Агент выполняет rollout и терпит неудачу.
- Агент видит вывод верификатора.
- Агент формулирует собственную обратную связь — один краткий TL;DR insight.
- Следующий rollout учитывает все предыдущие выводы.
- Rollouts идут последовательно, пока не найдено решение.
- Обучение с backpropagation по выводам в контексте усваивает соответствие «задача → вывод».
Вывод: ценность цикла не только в подсказке на следующую попытку. Ключевой фактор — усвоение связи между задачей и выводом.
Результаты на сложных задачах
Тесты шли на сложных наборах для tool-calling и coding. Авторы отфильтровали наборы по условию Pass@128=0. Сравнение идёт на политике Qwen 3.5 9B Thinking.
| Подход | Условия оценки | Pass@1 |
|---|---|---|
| Стандартное обучение GRPO | Без описанного цикла выводов | 0–1% |
| RLTLDR | Выводы в контексте во время обучения | 14–31% |
| RLTLDR | Выводов в контексте нет во время оценки | 12–13% |
Стандартное обучение GRPO остаётся на уровне Pass@1 от 0% до 1%. RLTLDR достигает 14–31% при наличии выводов в контексте во время обучения. Без выводов в контексте во время оценки результат составляет 12–13%. Авторы выделяют усвоение соответствия «задача → вывод» как ключевой фактор.
Вывод: контекст выводов повышает Pass@1. Для проверки усвоения нужно оценивать метод и с выводами, и без них.
SFTLDR: обучение на парах «задача — вывод»
SFTLDR — компактный вариант обучения. Он учится только на парах (задача, вывод). Rollouts и backpropagation по ним не используются.
Что известно об SFTLDR:
- обучение идёт только на парах (задача, вывод);
- SFTLDR не показывает rollouts;
- SFTLDR не применяет backpropagation по rollouts;
- обучение на 4k таких парах восстанавливает почти полную производительность RLTLDR;
- SFTLDR почти достигает производительности классического SFT на полных rollouts;
- авторы описывают подход как компактную парадигму: «для задач такого типа держи в уме вещи такого типа».
Вывод: SFTLDR — вариант для компактного обучения. Критерий: проверять его там, где можно собрать пары «задача — вывод».
Критерии применимости
RLTLDR требует проверяемой обратной связи и последовательных попыток. Без этих условий цикл не собрать. Критерии ниже помогают оценить применимость.
Критерии:
- задача допускает неудачные попытки и повторные rollouts;
- есть верификатор, чей вывод можно показать агенту;
- агент способен сформулировать один краткий вывод;
- следующая попытка учитывает все предыдущие выводы;
- оценка включает режим без выводов в контексте, если важно проверить усвоение.
Вывод: RLTLDR выбирают для задач, где есть верификатор и успех даётся тяжело. SFTLDR выбирают, когда нужен компактный режим на парах «задача — вывод».
Часто задаваемые вопросы
Похожие материалы
Все материалы
Вероятностная коррекция волновых прогнозов: BridgeCast связывает физические модели с реанализом через потоковое сопоставление
Представлен гибридный метод, который с помощью условного потокового сопоставления, трансформерной архитектуры и экзогенных атмосферных признаков преобразует выходы физических моделей волнения в поля, близкие к реанализу. Авторы сообщают о стабильном преимуществе над прежними передовыми базовыми решениями при различных сроках заблаговременности и в разных регионах.
12 ноября 2026
OpenCollab: программируемая координация агентов, контролируемая среда исполнения и метрика соблюдения регламента
Фреймворк сводит воедино задание структуры взаимодействия агентов, общее окружение для экспериментов и подробную трассировку событий, а вводимый показатель Adherence отражает, насколько реальное выполнение соответствует заявленной схеме. В бенчмарках конфигурация Duo выходит на новый уровень SOTA, тогда как одноагентный вариант отличается наименьшим расходом токенов.
11 ноября 2026
Toollery: выбор инструментов для LLM-агентов из десятков тысяч опций без дообучения
Toollery строит поисковый индекс по описаниям навыков и инструментов, а при запросе передаёт модели лишь ограниченный набор кандидатов. В экспериментах на библиотеках масштабом до десятков тысяч функций подход позволяет удерживать качество выбора при фиксированном top-K, хотя итоговый эффект зависит от профиля нагрузки и кэширования у провайдера.
11 ноября 2026