Что именно повторно используют
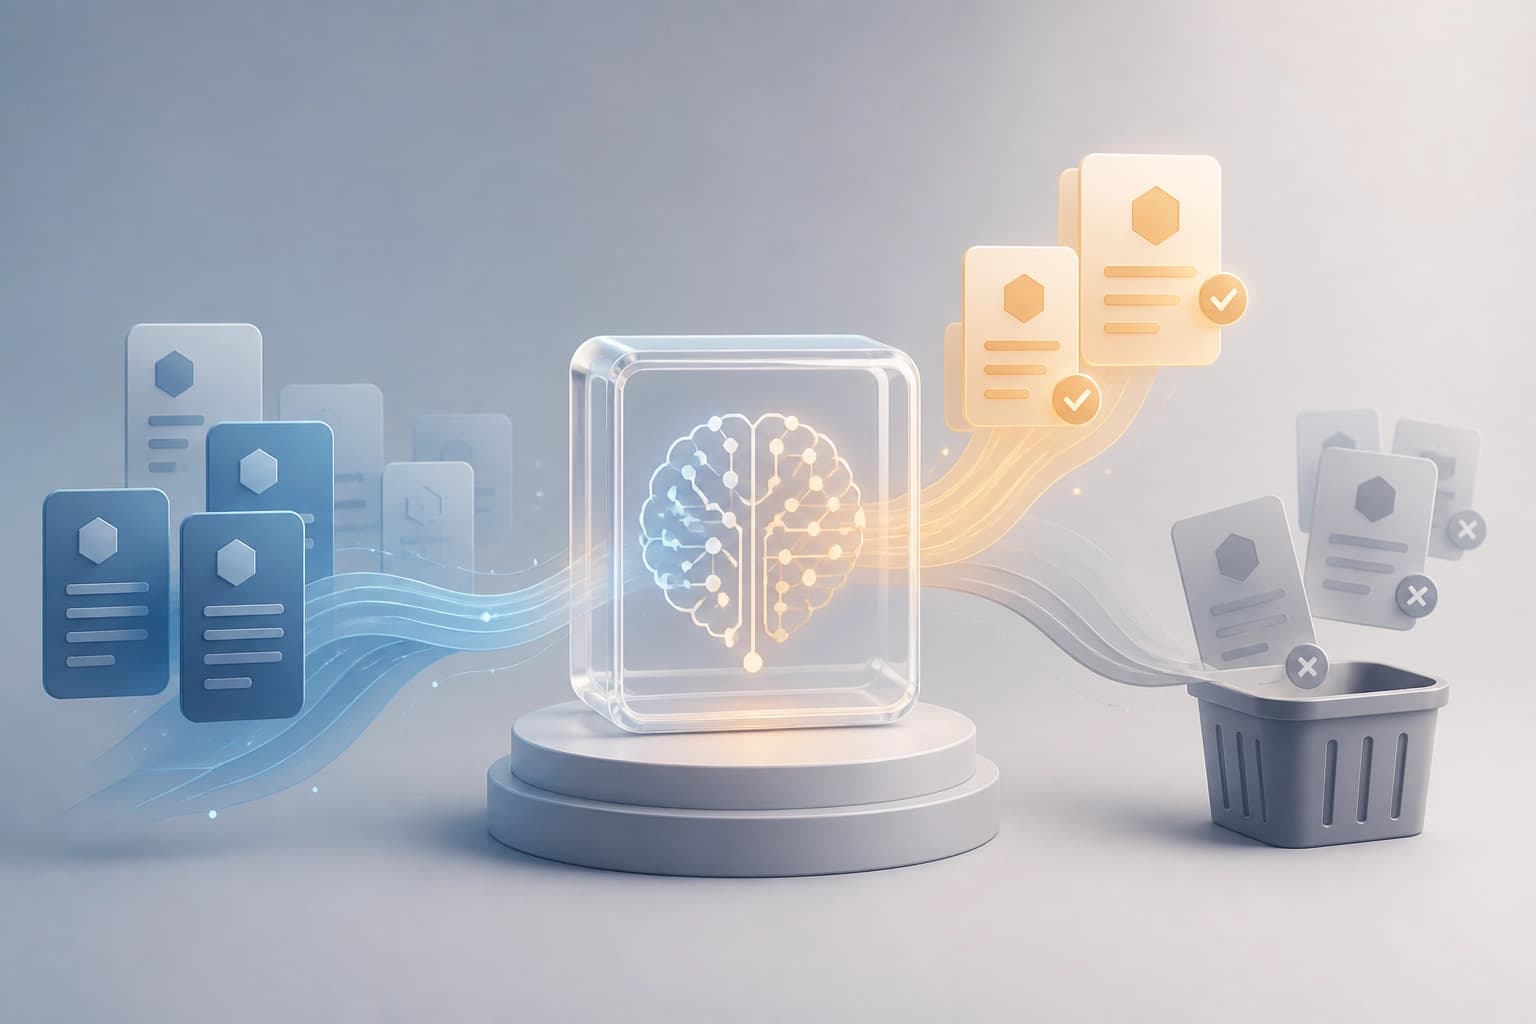
В обычном GRPO каждый rollout участвует в одном gradient update, после чего его отбрасывают. Метод из статьи меняет этот цикл: он сохраняет отдельные rollout’ы и возвращает выбранные в обучение.
Буфер хранит не целые группы, а отдельные генерации. Replay приоритизирует их по величине advantage: rollout’ы с большими значениями используют повторно.
Практический критерий: речь идёт о повторном использовании отдельных rollout’ов, а не групп.
Как устроен replay
Каждый batch формируется в два этапа:
- В него включают свежие on-policy rollout’ы.
- К ним добавляют отдельно выбранные rollout’ы из буфера.
При выборе replay-элементов учитывают величину advantage каждого rollout’а. Размер доли replay в batch в описанных фактах не указан.
Ключевое отличие метода — свежие rollout’ы остаются в batch, а буфер дополняет их выбранными генерациями.
Как ограничивают устаревание
Авторы отмечают проблему naive replay: LLM policies быстро меняются с каждым gradient step. Сохранённые rollout’ы могут устареть и дестабилизировать обучение.
Метод удаляет из буфера любой rollout, который старше tau_max training steps. Это задаёт предел хранения, но не отменяет сам факт повторного использования.
Критерий контроля здесь — возраст отдельного rollout’а в training steps, а не принадлежность к группе.
Что показала оценка
Метод проверили на трёх масштабах Qwen3-Base и пяти математических benchmark’ах. Он превзошёл GRPO и naive replay baselines.
- На каждом масштабе прирост по среднему пяти benchmark’ов был положительным.
- На масштабе 4B прирост достиг +1.66 pp.
- По AES, метрике совместной оценки accuracy и token efficiency, метод стал единственным вариантом с положительным отрывом от GRPO на каждом масштабе.
Практический критерий выбора зависит от целевой оценки: результаты охватывают accuracy, token efficiency и сравнение с двумя baseline.