
Omanic: пошаговый разбор того, где именно ломается логика LLM
Новый открытый бенчмарк Omanic предлагает судить о reasoning-способностях модели не только по финальному ответу, но и по каждому промежуточному выводу. В основе — примерно 10,3 тыс. синтетических обучающих примеров и 967 тестовых вопросов, размеченных экспертами вручную.
Финальный ответ как единственная метрика — и что она прячет
Большая часть бенчмарков для языковых моделей устроена как школьная контрольная: есть вопрос, есть эталон, есть проверка совпадения. Считать такую метрику удобно, сравнивать модели — тоже. Но у этой схемы есть встроенный дефект: она оценивает результат, а не путь к нему.
Представьте задачу, где нужно связать четыре факта. Модель путается на втором, случайно угадывает на четвёртом — и получает балл. Или наоборот: три звена выстроены безупречно, а последний ответ отличался одной формулировкой — и балла нет. В обоих случаях итоговое число врёт о том, что на самом деле произошло внутри. Особенно болезненно это для многошаговых вопросов: там проверяется не один навык, а их последовательность — найти сведения, удержать их, соединить со следующими, не растерять по дороге.
Диагностика «где именно сломалось» — не академическая придирка. От неё зависит, что чинить: корпус данных, стратегию обучения или формулировку промпта. Финальная точность на такой вопрос ответить не может по определению.
Что такое Omanic
Именно эту слепую зону закрывает работа «Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models» (arXiv:2603.16654, проходит по секции cs.CL, также отнесена к cs.AI и cs.LG, принята в EMNLP 2026 Findings). Авторский коллектив широкий и интернациональный: Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li. Первая редакция выложена 17 марта 2026 года, затем последовали две ревизии — в мае и в августе.
Omanic — это open-domain бенчмарк на четыре шага рассуждения. Слово «open-domain» здесь ключевое: модель не выбирает вариант из готового списка и не роется в одном заранее подготовленном документе. Сведения нужно найти самостоятельно и лишь потом выстроить из них цепочку. Такая постановка ближе к реальным сценариям, где ответ почти никогда не лежит в одном абзаце.
Два корпуса вместо одного
Внутри Omanic живут два разных набора данных, и путать их не стоит.
Первый — OmanicSynth, 10 296 примеров, сгенерированных машиной. Это обучающий материал: его можно использовать как супервизию, и именно на нём авторы проверяли, передаётся ли способность рассуждать по шагам.
Второй — OmanicBench, 967 примеров, которые прошли экспертную проверку и снабжены ручной аннотацией. Это оценочная часть, и она существенно меньше — что логично, поскольку человеческая разметка на уровне шагов стоит дорого.
Такое разделение — не формальность. Оно позволяет отделить «модель натренировали» от «модель действительно умеет»: обучающий корпус большой и машинный, проверочный — компактный и выверенный.
Как устроена пошаговая разметка
Главное отличие Omanic от привычных QA-наборов — в том, что каждый вопрос разобран на составляющие. Одношаговые подвопросы, промежуточные ответы, структурированные графовые топологии — то есть схема того, как именно факты связаны друг с другом.
Это превращает оценивание из одной точки в набор контрольных точек. Теперь можно посмотреть не только «модель ответила верно или нет», но и «на каком именно переходе она поехала». Графовая структура здесь важна ещё и потому, что разные типы связей даются моделям с разной лёгкостью: одно дело — вытащить свойство объекта, совсем другое — проследить цепочку из четырёх последовательных зависимостей.
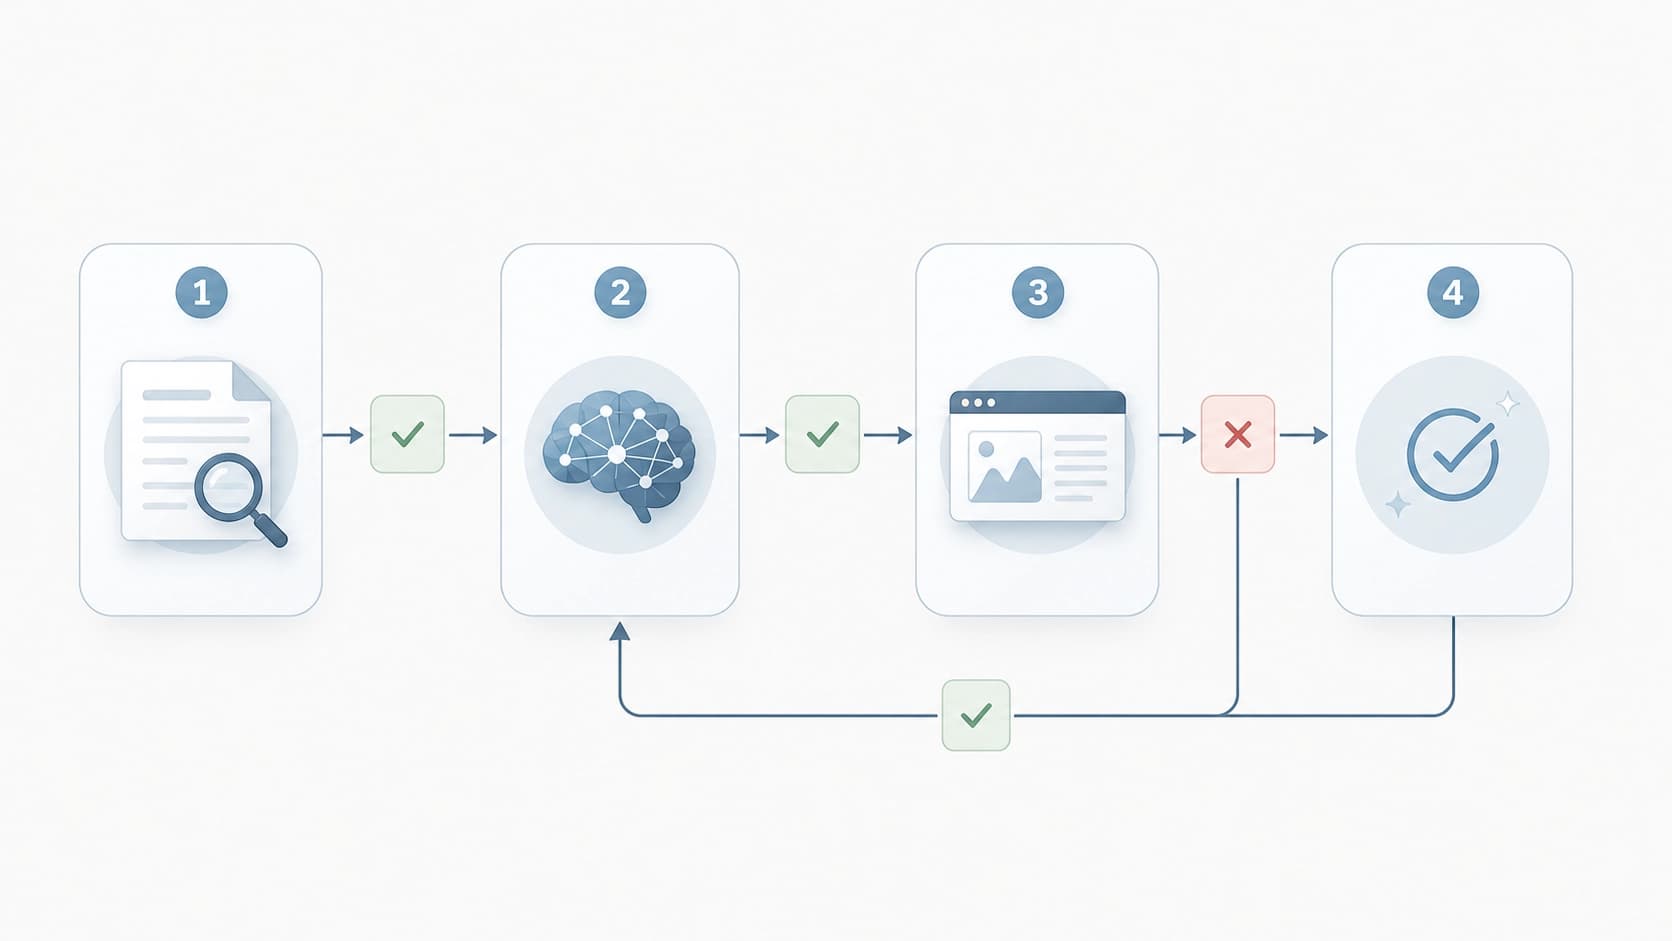
Три диагноза, которые видны только на шагах
Эксперименты с закрытыми и открытыми моделями дали три наблюдения, которые финальная метрика просто не способна показать.
Узкое место на поздних шагах
Первый вывод авторы называют later-hop bottleneck. Речь о том, что основные потери накапливаются не в начале, а ближе к концу цепочки. Первый-второй переход модели проходят относительно уверенно, а вот на третьем и четвёртом начинают сыпаться.
Объяснение напрашивается само: чем длиннее цепочка, тем больше промежуточных сущностей нужно одновременно держать в рабочем состоянии. На поздних шагах модели приходится оперировать уже не исходным вопросом, а результатами собственных предыдущих выводов — и любая неточность там множится. Практический вывод неприятен для тех, кто любит строить длинные многоступенчатые пайплайны: добавление пятого и шестого шага может обойтись дороже, чем кажется.
«Пол» фактических знаний
Второй феномен — factual knowledge floor, «пол» фактических знаний. Часть ошибок вообще не связана с логикой: модель просто не располагает нужным фактом и вместо того, чтобы честно остановиться, продолжает строить рассуждение на пустом месте.
Это важное разграничение. Когда модель ошибается в выводе — вопрос к рассуждению. Когда она не знает исходного факта — вопрос к данным и к тому, умеет ли она признавать незнание. Второе лечится плохо: ни рассуждение по шагам, ни более умный промпт не помогут, если опоры под первым звеном просто нет.
Ошибка, которая едет по цепочке
Третий диагноз — распространение ошибок вдоль цепочки. Ранняя неточность не остаётся локальной: она подхватывается следующими шагами и превращается в уверенный, гладко сформулированный, но неверный финальный ответ.
Здесь кроется ловушка для оценки. Модель, которая ошиблась один раз и дальше рассуждала последовательно, и модель, которая посыпалась на всех шагах, в финальной метрике выглядят одинаково — обе не угадали. Пошаговый разбор их различает, и это ровно тот случай, когда диагностика ценнее итогового балла.
Перенос обучения: 7,41 пункта на шести бенчмарках
Отдельный вопрос — можно ли эту разметку использовать не только для измерений, но и для тренировки. Авторы проверили: дообучение на OmanicSynth дало улучшение на шести сторонних бенчмарках, посвящённых рассуждениям и математике, со средним приростом 7,41 пункта.
Цифра, которую стоит читать правильно. Это не «модель стала умнее во всём» — это «навык, отработанный на декомпозированных цепочках, переносится на другие задачи похожего типа». Что уже само по себе говорит о природе бенчмарка: он не про заучивание конкретных вопросов, а про тренировку процедуры — как разбить задачу на шаги и удержать связь между ними.
Что это значит для практики
Несколько выводов, которые напрашиваются из описанного.
Оценивать по шагам, а не по итогу. Если ваша система строит многошаговые ответы, одной финальной метрики недостаточно — она усреднит разные по природе сбои в одно невнятное число.
Разделять «не знаю» и «неверно вывел». Это два разных дефекта с разными способами лечения, но в обычной отчётности они сливаются.
Осторожнее с длинными цепочками. Поздние шаги — самое уязвимое место. Иногда разумнее разбить задачу на несколько независимых подзадач, чем гнать одну длинную цепочку до конца.
Декомпозиция — это ещё и обучающий сигнал. Результат с переносом на шесть сторонних наборов показывает, что разметка по шагам работает не только как линейка, но и как материал для тренировки.
Чем Omanic не является
Полезно обозначить границы. Omanic — не универсальная оценка интеллекта модели и не тест на всё сразу. Это инструмент под конкретную задачу: показать, на каком звене рассуждения происходит сбой в многошаговых вопросах открытого домена.
Объём оценочной части — 967 примеров — тоже стоит держать в голове: набор выверенный, но не гигантский. Обучающая часть на порядок больше и создана машинно, что даёт масштаб, но не заменяет ручную проверку.
И главное: сам по себе диагноз ничего не лечит. Знание о том, что модель спотыкается на поздних шагах, — это отправная точка, а не решение. Дальше начинается обычная работа: где добавить данные, где упростить цепочку, где научить модель останавливаться и говорить «я этого не знаю».
Данные и код авторы выложили в открытый доступ; работа доступна по DOI 10.48550/arXiv.2603.16654.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
9 ноября 2026