
Neptuna: сравнение ML-архитектур на сжимаемых многофазных течениях с разрывами
Представлен Neptuna — крупный бенчмарк на 3 ТБ расчётов для задач о схлопывании пузырьков и распаде капель под действием ударных волн, где проверяются свёрточные, спектральные, трансформерные и предобученные PDE-модели. Вывод: универсального лидера нет, а составные функции потерь и SoftAdapt помогают лучше удерживать межфазные границы и точнее воспроизводить спектр.
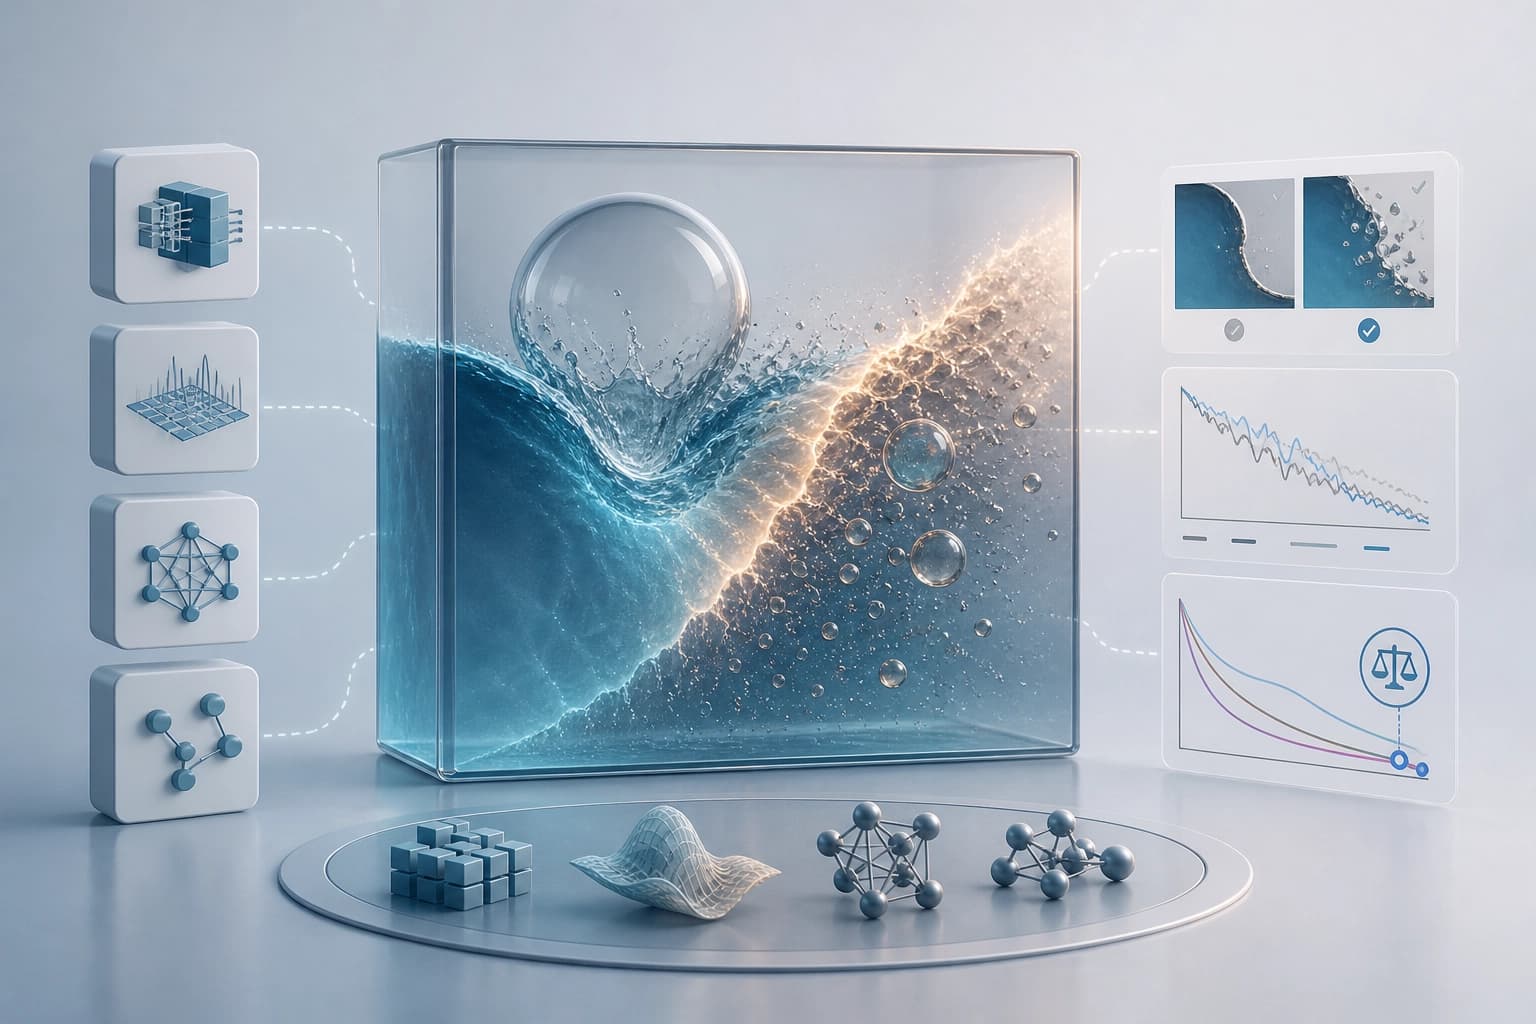
Задача бенчмарка
Neptuna — первый крупномасштабный бенчмарк для ударно-возбуждённых сжимаемых многофазных течений. Он создан для сравнения ML-моделей на данных с ударными волнами и границами раздела материалов. Бенчмарк оценивает не одну архитектуру, а комбинацию архитектуры, функции потерь и метрик.
| Компонент оценки | Варианты |
|---|---|
| Архитектуры | свёрточные, спектральные, трансформеры, PDE foundation models |
| Функции потерь | MSE, составные функции, SoftAdapt, GradNorm |
| Метрики | поточечные, спектральные, ориентированные на признаки, структурные, учитывающие физику |
Вывод: бенчмарк задаёт единую площадку для воспроизводимого сравнения. Практический критерий: использовать его для сопоставления моделей на одинаковых данных и метриках.
Данные и физика
Бенчмарк включает 3 TB высокоточных 2D- и 3D-данных. Данные описывают вызванное ударной волной схлопывание пузырьков и распад капель. В таких течениях есть ударные волны и границы раздела материалов.
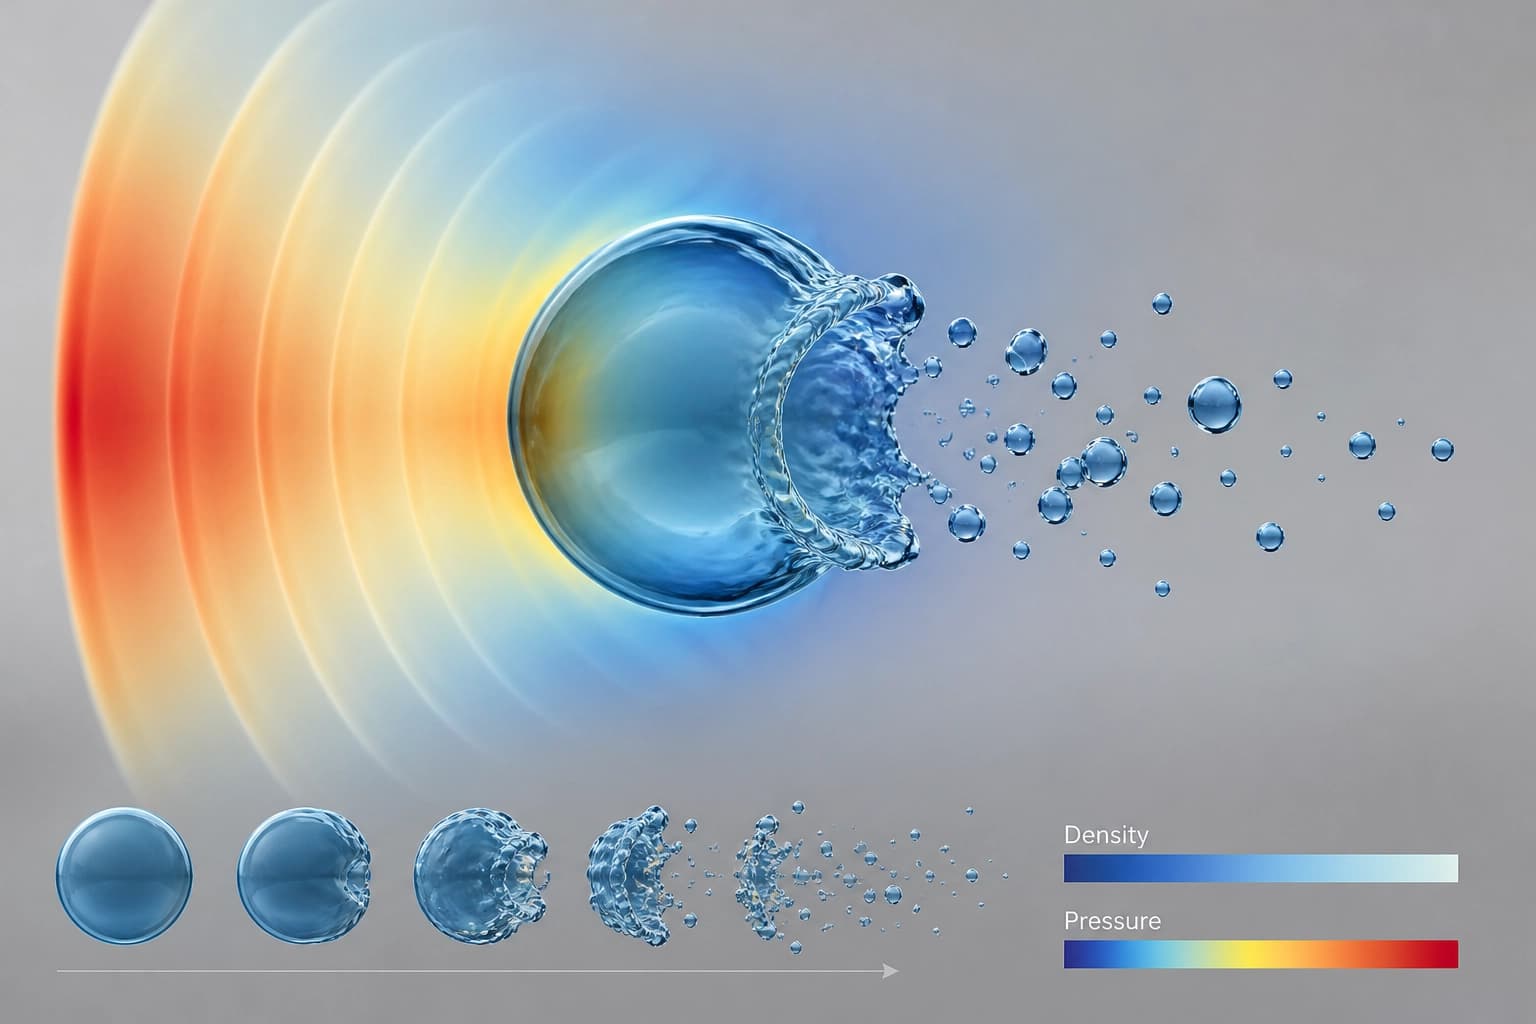
Сильные нелинейные взаимодействия приводят к сложной деформации границ, смешению и многомасштабной динамике. Построение надёжных суррогатных моделей затрудняют три фактора:
- сжимаемость;
- резкие разрывы;
- многофазные эффекты.
Эти факторы присутствуют одновременно.
Вывод: данные проверяют модели на разрывах и границах раздела. Практический критерий: включать в проверку сценарии с разрывами и границами раздела.
Сравниваемые архитектуры
В бенчмарке оценивались свёрточные, спектральные и основанные на трансформерах модели. В оценку также вошли предварительно обученные PDE foundation models. Бенчмарк проверяет эти семейства на сжимаемых многофазных течениях с разрывами.
Сравнение охватывает разные способы построения суррогатной модели. Оно не сводится к одному семейству. Архитектуры оцениваются на одних и тех же данных и метриках.
Вывод: архитектуру выбирают под задачу, а не по названию семейства. Практический критерий: проверять архитектуру на том наборе, где она будет работать.
Функции потерь
Стандартное обучение в бенчмарке использует MSE. Дополнительно проверялись составные функции потерь. Они объединяют MSE с Sobolev-, interface-aware- и structure-aware-компонентами.
Для адаптивной балансировки потерь применялись SoftAdapt и GradNorm. Бенчмарк включает оба варианта.
| Вариант | Состав |
|---|---|
| MSE | Базовая функция потерь |
| Составные функции | MSE + Sobolev + interface-aware + structure-aware |
| SoftAdapt | Адаптивная балансировка потерь |
| GradNorm | Адаптивная балансировка потерь |
Вывод: выбор функции потерь зависит от целевой метрики. Практический критерий: для проверки адаптивной балансировки включать SoftAdapt и GradNorm.
Метрики оценки
Оценка включает пять групп метрик:
- поточечные;
- спектральные;
- ориентированные на признаки;
- структурные;
- учитывающие физику.
Набор метрик многомерен. Вывод: нельзя судить о модели по одной метрике. Практический критерий: заранее определить, какая группа метрик критична для задачи.
Результаты сравнения
Ни одна модель не оказалась лучшей на всех наборах данных и по всем метрикам. Этот результат относится к разным архитектурам и конфигурациям. Составные функции потерь значительно улучшают сохранение границ раздела и спектральную точность.
SoftAdapt обеспечивает наиболее последовательные улучшения почти без дополнительных вычислительных затрат по сравнению с обучением только на MSE. GradNorm также входил в оценку. Единого победителя по всем показателям нет.
| Что сравнивалось | Вывод |
|---|---|
| Архитектуры | Ни одна не лучшая на всех наборах и метриках |
| Составные функции потерь | Улучшают сохранение границ и спектральную точность |
| SoftAdapt | Наиболее последовательные улучшения почти без дополнительных затрат |
Вывод: выбор зависит от набора данных и метрики. Практический критерий: определить критичную метрику, затем проверить функцию потерь и архитектуру на целевом наборе.
Статус и доступ
Работа Neptuna принята на NeurIPS-2026 (Evaluations and Datasets Track). Статья подана 24 Jul 2026 (v1); последняя редакция — 18 Oct 2026 (v3). arXiv:2607.22280.
Репозиторий бенчмарка и набор данных доступны по ссылке this https URL. Это позволяет воспроизвести оценку и сравнить модели с результатами бенчмарка.
Вывод: бенчмарк доступен для практической проверки. Практический критерий: использовать репозиторий как основу для воспроизводимого сравнения.
Часто задаваемые вопросы
Похожие материалы
Все материалы
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
9 ноября 2026
Правка презентаций как управляемые операции: фреймворк EditPPT и бенчмарк DeckEdit-Bench
Авторы разбирают редактирование слайдов на конкретные объекты, допустимые действия и проверку того, что постороннее содержимое осталось нетронутым, вместо свободной генерации кода. Для замера качества создан DeckEdit-Bench (183 задачи на 28 человеческих презентациях), а мультиагентная схема EditPPT на пяти базовых моделях показывает успех в 66,7–74,9% задач при сохранности выше 97%.
8 ноября 2026