
Новый подход LSem2Vec: как получить вектор кода за два шага и без дорогостоящего обучения
Исследователи предложили несложный способ встраивания исходного кода, который сочетает большие языковые модели и модели текстовых эмбеддингов. Метод LSem2Vec не требует тонкой настройки под задачу и, по результатам экспериментов, обходит пять современных неконтролируемых подходов.
Что такое эмбеддинги кода
Векторное представление исходного кода нужно для множества практических задач: от поиска похожих фрагментов до автоматической группировки функций по смыслу. Программа превращается в набор чисел, с которым могут работать алгоритмы машинного обучения. Качество вектора при этом зависит от того, насколько хорошо модель понимает семантику кода, а не только его синтаксис.
В чём сложность
Классические методы обычно требуют отдельного обучения под каждую задачу или хотя бы дообучения на доменных данных. Это дорого и не всегда оправдано. Подходы на основе больших языковых моделей (LLM) выглядят универсальнее, но у них есть свой минус: в ответах модели нередко встречается лишняя или ошибочная информация, и эта «грязь» попадает в векторы.
Идея LSem2Vec
Авторы работы предложили двухэтапный подход с говорящим названием LSem2Vec — LLM-extracted code Semantics to Vector embedding. Вместо попыток обучить ещё одну тяжёлую модель они соединяют уже готовые компоненты: LLM извлекает из кода его смысл, а модель эмбеддингов предложений преобразует описание в вектор. Дообучение под конкретную задачу не требуется.
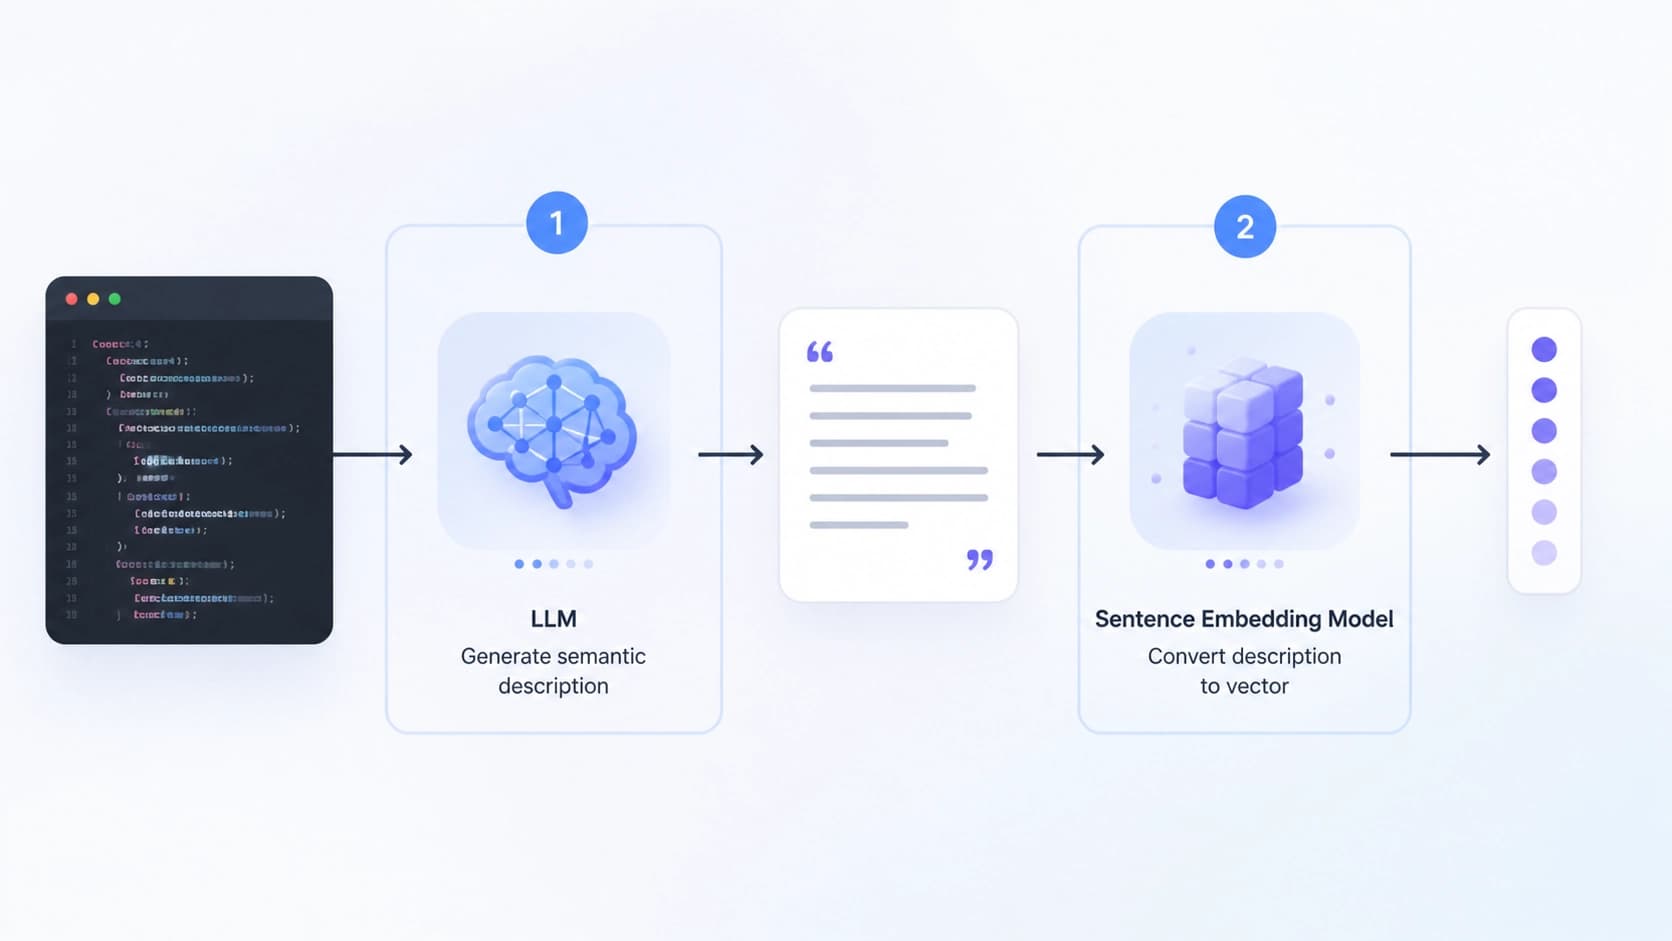
Разберём процесс по шагам. На первом этапе LLM получает код и должна сформулировать, что именно он делает. Это не механический пересказ исходника, а выделение сути: модель отбрасывает второстепенные детали, чтобы в описание попадало только важное для смысла. Попутно такой подход отсекает и возможные «фантазии» больших моделей — ошибочную информацию, которая чаще всего появляется при попытке закодировать код напрямую.
Второй этап тривиален по меркам машинного обучения: описание, полученное от LLM, подаётся в модель эмбеддингов предложений. Такая модель уже обучена превращать естественный язык в осмысленные векторы, поэтому адаптировать её к синтаксису языков программирования не нужно.
Почему это работает
Сильная сторона LSem2Vec — в чётком разделении обязанностей. Одна модель отвечает за понимание логики, другая — за перевод текста в вектор. Каждая из них решает свою задачу наилучшим образом, а вместе они дают вектор, основанный на семантике, а не на формальных признаках кода. Отсутствие этапа обучения делает подход дёшевым и простым в воспроизведении.
Как проверяли и что получилось
Эксперименты проводились на трёх наборах данных, составленных на разных языках программирования. Авторы целенаправленно меняли и LLM, и модели эмбеддингов, чтобы убедиться: результат не зависит от конкретной пары инструментов.
Во всех конфигурациях LSem2Vec показал результаты лучше, чем пять современных неконтролируемых методов, которые обычно заточены под специфические условия и требуют настройки.
Статус работы
Статья была выложена на arXiv в сентябре 2024 года, последняя доступная версия — v5 от августа 2026-го. По информации авторов, работа принята журналом Frontiers of Computer Science. Значит, у подхода появилась не только страница препринта, но и рецензированная публикация. Оригинал можно найти по DOI: 10.1007/s11704-026-61288-0.
Итог
Главный вывод LSem2Vec в том, что сложные задачи не всегда требуют сложных решений. Достаточно последовательно применить LLM для извлечения смысла и модель эмбеддингов предложений для создания вектора. Это быстро, без специального дообучения и даёт конкурентные результаты.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Подтверждение кандидатов дороже их генерации: приманки против LLM-поиска уязвимостей
В работе разобрана ценовая асимметрия агентного поиска дефектов: генерация версий дешева, а их подтверждение через анализ достижимости, исполнение и PoC требует основного бюджета, поэтому верификацию можно сделать самостоятельным объектом обороны. Предложенный RedHerring — подстраиваемые под репозиторий приманки с закрытым сертификатом — при равных затратах снижал число найденных настоящих уязвимостей на 38,7–60,4% в 33 проектах OSS-Fuzz; даже после предупреждения агента падение сохранялось на уровне 37,2%.
9 ноября 2026
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026