
Метод GoldiMask для дообучения диффузионных языковых моделей: выбор контекста и взвешивание целей
В работе представлен GoldiMask — подход к supervised fine-tuning для языковых моделей с дискретной диффузией, который выбирает видимые токены через приближённую максимизацию субмодулярной функции и назначает веса оставшимся целям по их обучающей полезности. Эксперименты на нескольких моделях и датасетах демонстрируют рост средней точности, прирост на задачах логического вывода и программирования, а также меньше итераций параллельного декодирования на GSM8K и MATH-500 при близком качестве.
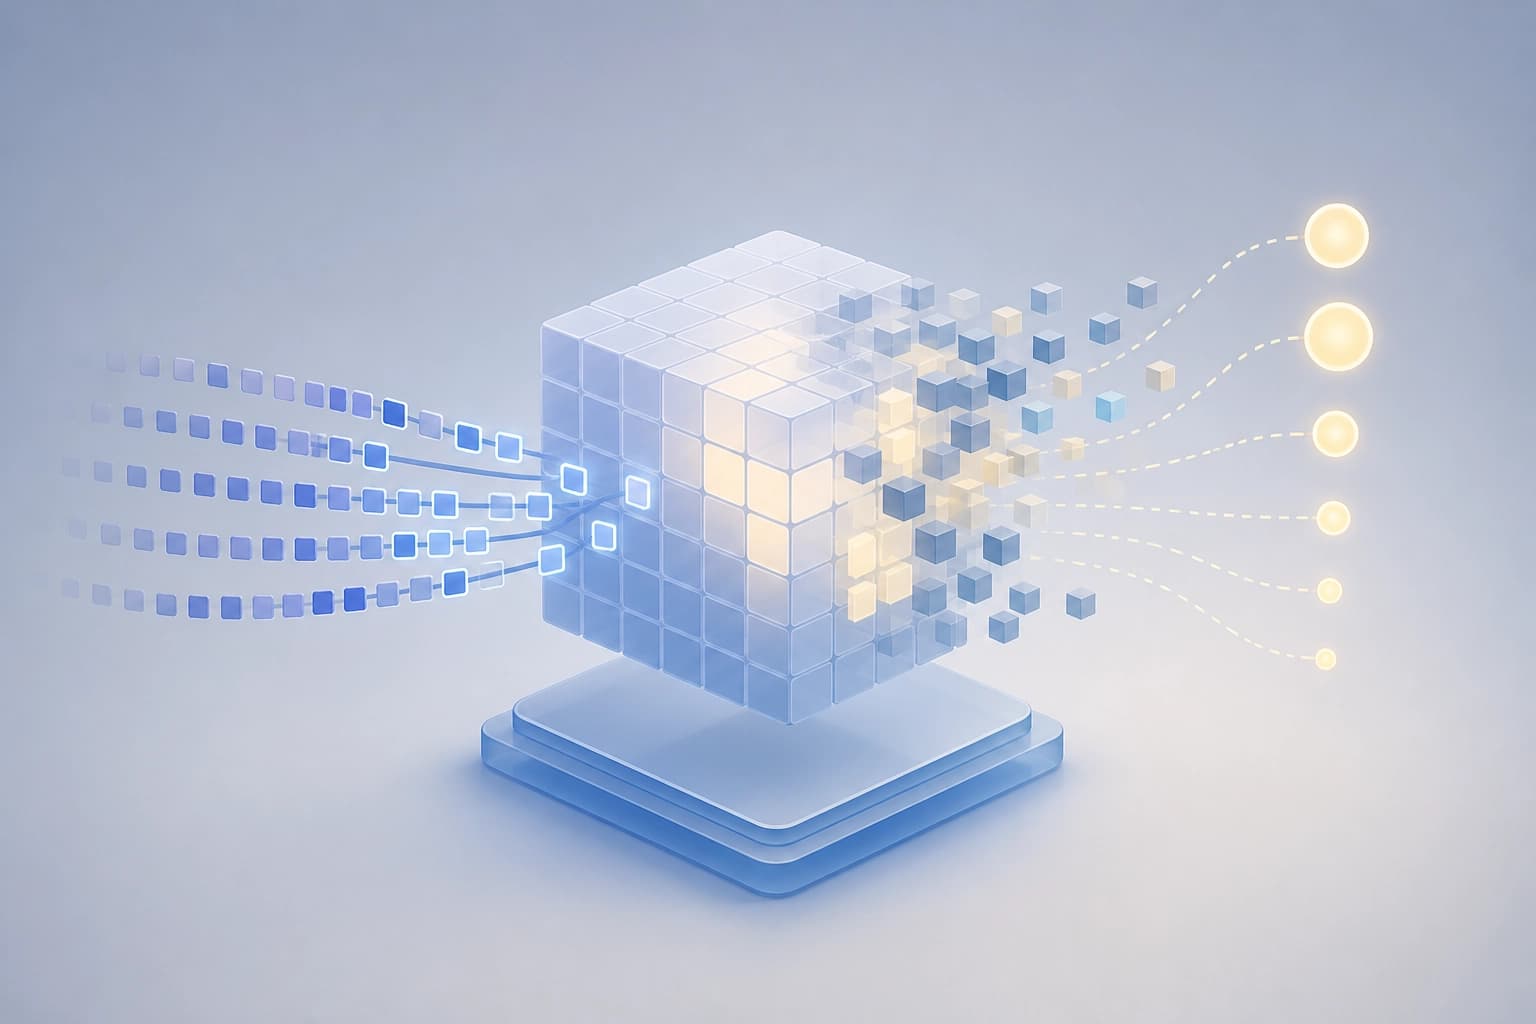
Маскирование задаёт два решения сразу
Дообучение дискретных диффузионных языковых моделей опирается на восстановление замаскированных токенов. Часть токенов ответа закрывается маской, и модель предсказывает их исходные значения по видимому контексту.
Схема маскирования задаёт сразу две вещи. Она определяет, какой контекст доступен модели. Она же определяет, какие токены становятся целями предсказания.
Эти решения связаны между собой: раскрытый токен перестаёт быть целью. Равномерное случайное маскирование такую связь не учитывает. Поэтому часть токенов раскрывается там, где это мало помогает предсказанию.
Методика GoldiMask описана в статье Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting (arXiv:2609.38385, 29 сентября 2026). Она предназначена для supervised fine-tuning дискретных диффузионных языковых моделей.
| Решение | Равномерное случайное маскирование | GoldiMask |
|---|---|---|
| Какие токены раскрыть как контекст | случайный выбор | выбор по субмодулярной целевой функции |
| Вес оставшихся целевых токенов | не зависит от выбранного контекста | зависит от помощи контекста и потенциала обучения |
| Связь двух решений | не учитывается | учитывается через сигналы модели |
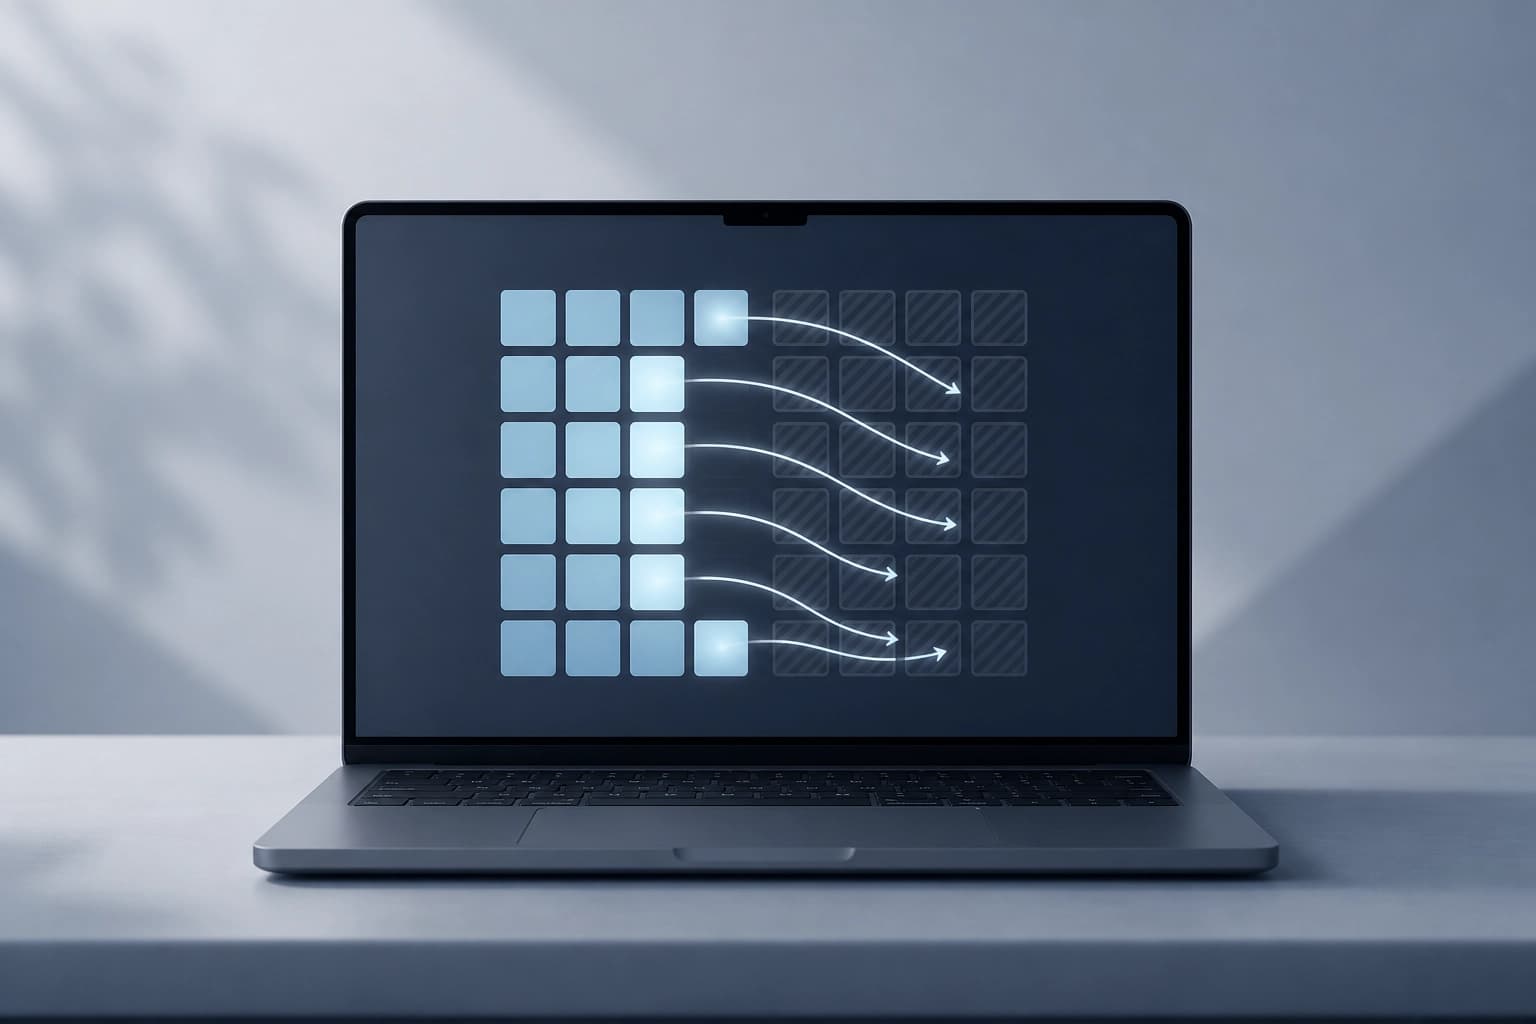
Критерий: схему маскирования нужно оценивать как единое решение о контексте и целях. Тогда видно, где раскрытие токенов оправдано, а где — нет.
Отбор контекста по сигналам модели
GoldiMask выбирает токены для раскрытия в качестве контекста. Выбор приближённо максимизирует субмодулярную целевую функцию.
Метод использует сигналы модели и балансирует две величины:
- пользу от раскрытия конкретного токена;
- ценность этого токена как цели предсказания.
Токен, который помогает предсказывать окружение, выгодно раскрыть. Токен, который модель предсказывает плохо, выгоднее оставить целью.
Практический критерий: случайный отбор контекста сигналы модели не использует. Если применяется именно такая схема, потенциал отбора контекста остаётся незадействованным.
Взвешивание целевых токенов
После отбора контекста часть токенов остаётся целями предсказания. GoldiMask взвешивает их с учётом двух факторов:
- насколько выбранный контекст помогает предсказывать конкретный токен;
- какой потенциал обучения у этого токена остался.
Так вес связывает цели с уже принятым решением о контексте. Взвешивание не выбирает, что раскрыть. Оно определяет вклад в обучение тех токенов, которые остались закрытыми.
Критерий: при разборе схемы маскирования полезно разделять два вопроса — что раскрыть и с каким весом учить оставшееся.
Результаты на моделях и наборах данных
GoldiMask проверили на трёх базовых моделях и трёх обучающих наборах данных. Средняя точность метода оказалась наивысшей в большинстве оценённых настроек.
Улучшения затронули задачи рассуждения и генерации кода. Абляции компонентов показали, что вклад в улучшения вносят оба механизма: и отбор контекста, и взвешивание целевых токенов.
Практический критерий: наивысшая точность в большинстве настроек не означает выигрыш в каждой конфигурации. Метод имеет смысл проверять на конкретной паре «базовая модель + обучающий набор».
Эффект на параллельное декодирование
Отдельный результат касается параллельного декодирования с порогом уверенности. На GSM8K и MATH-500 GoldiMask сокращает число итераций декодирования.
Точность при этом остаётся сопоставимой при более высоких порогах уверенности.
Практический критерий: если в пайплайне применяется параллельное декодирование с порогом уверенности, метод влияет и на число шагов декодирования, и на точность. Оценка только по точности здесь неполна.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Британский инспектор по иммиграции решает, проверять ли GPT-4 в Home Office
Независимый надзорный орган по границам и иммиграции запросил у правозащитной организации сведения о двух системах на базе OpenAI, которые Home Office применяет при работе с материалами просителей убежища. Статья объясняет, почему сомнения в точности сводок, отсутствие публичного реестра и скрытость применения могут привести к официальной проверке и юридическим претензиям.
3 ноября 2026
Переход к вероятностному симплексу сокращает модальный разрыв в контрастивных мультимодальных моделях
В работе arXiv:2610.32890 предлагается заменить сферические эмбеддинги вероятностным симплексом, добавив лёгкие softmax-адаптеры и сходство Total Variation. На пяти бенчмарках поиска центроидное ℓ2-расстояние между модальностями снижается на 97–99% при сохранении или росте качества поиска.
3 ноября 2026
Как ActionRAG пересматривает свидетельства при диффузии по графу памяти LLM-агентов
Предложена архитектура графовой памяти, которая на этапе индексации аккуратно согласует сущности, а при запросе заново оценивает связи с опорой на локальную структуру. На MemoryAgentBench метод показал среднюю точность 55,1 и прирост 5,4 п.п. к сильнейшему извлекающему baseline при стоимости синтеза ниже $0,001 за запрос.
3 ноября 2026