
Клинические правила вместо разметки: новый метод обучает агента офтальмологического триажа на 3 000 диалогах
Авторы представили подход GAO: рекомендации Американской академии офтальмологии компилируются в таблицу из 70 правил, которая служит единственным источником контроля для обучения. Дообученная 9B-модель повысила согласованность с эталоном с 61,7% до 74,1%, а распознавание непредусмотренных случаев — с 9,5% до 69,0%, при этом ручная разметка использовалась только для оценки.
Почему обычная разметка мешает обучать медицинских агентов
Диалогового агента для офтальмологического триажа нельзя просто обучить на словах: нужно показывать ему тысячи примеров бесед с правильными ответами. В обычных продуктах такую разметку делают люди-аннотаторы. В клинике всё сложнее: разметка требует участия врачей, стоит дорого, а стенограммы разговоров с пациентами защищены врачебной тайной. Передавать их внешним подрядчикам нельзя, поэтому масштабировать супервизию практически невозможно.
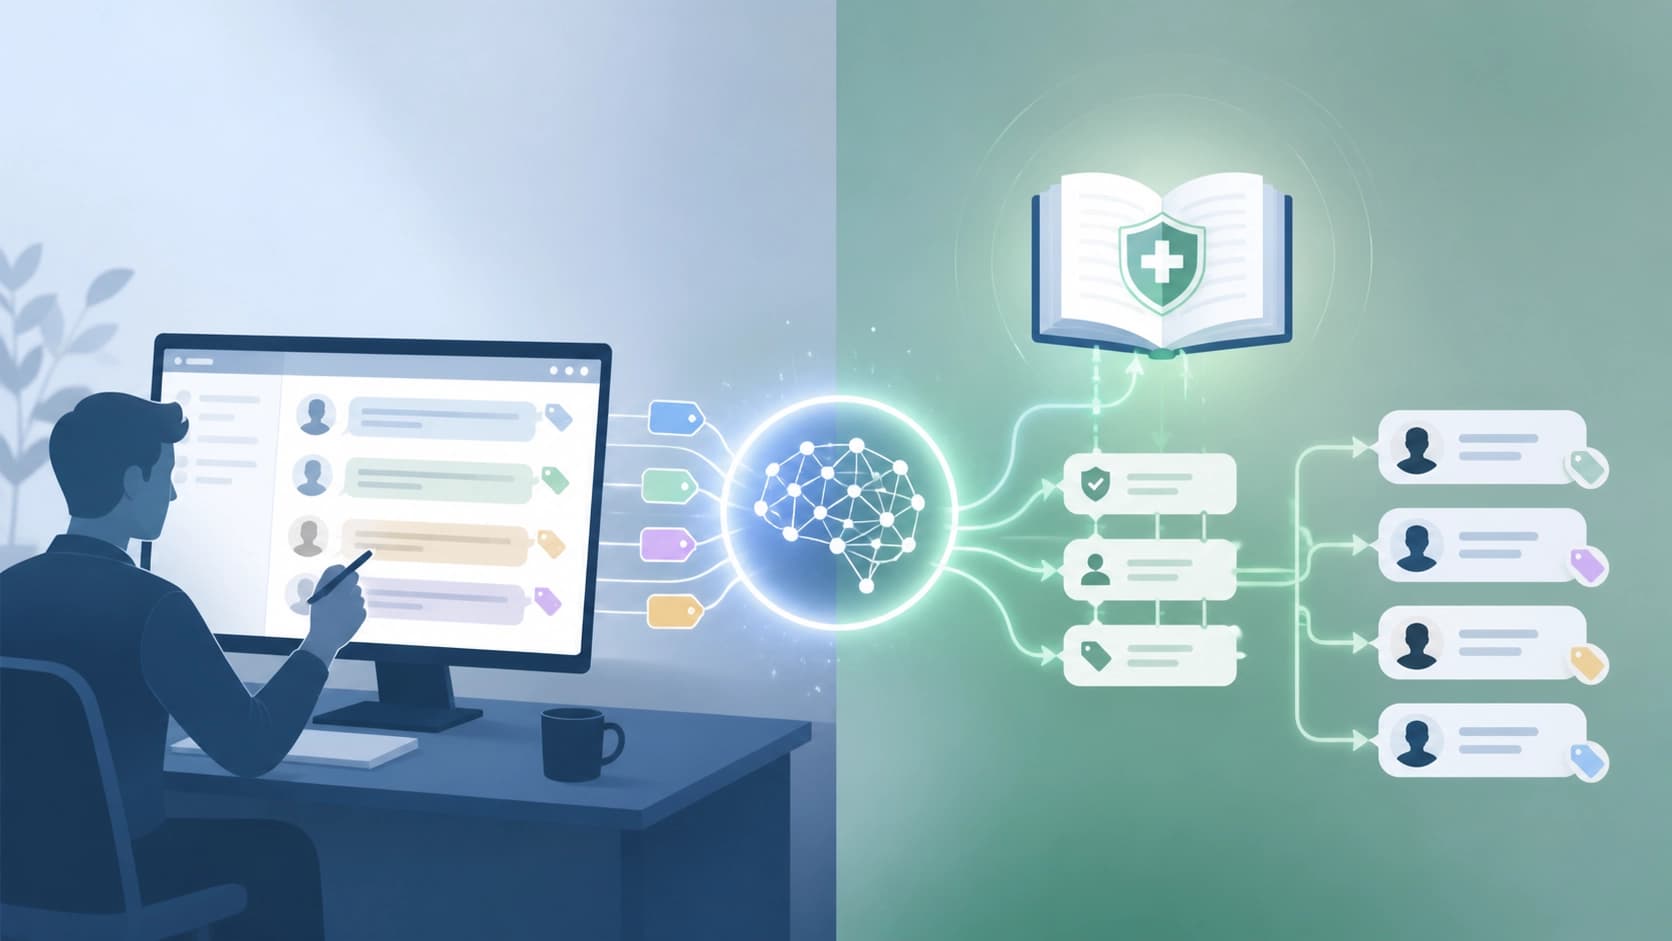
Авторы недавней работы предложили уйти от этой модели. Вместо того чтобы нанимать экспертов и вручную размечать каждую реплику, они использовали сами клинические рекомендации как источник обучающего сигнала. В офтальмологии правила триажа достаточно строгие, чтобы свести их к формальным операциям, которые могут размечать диалоги автоматически. Такой подход не только удешевляет процесс, но и позволяет не выносить чувствительные данные за пределы исследовательской среды.
Метод Guideline-as-Oracle: руководство становится «оракулом»
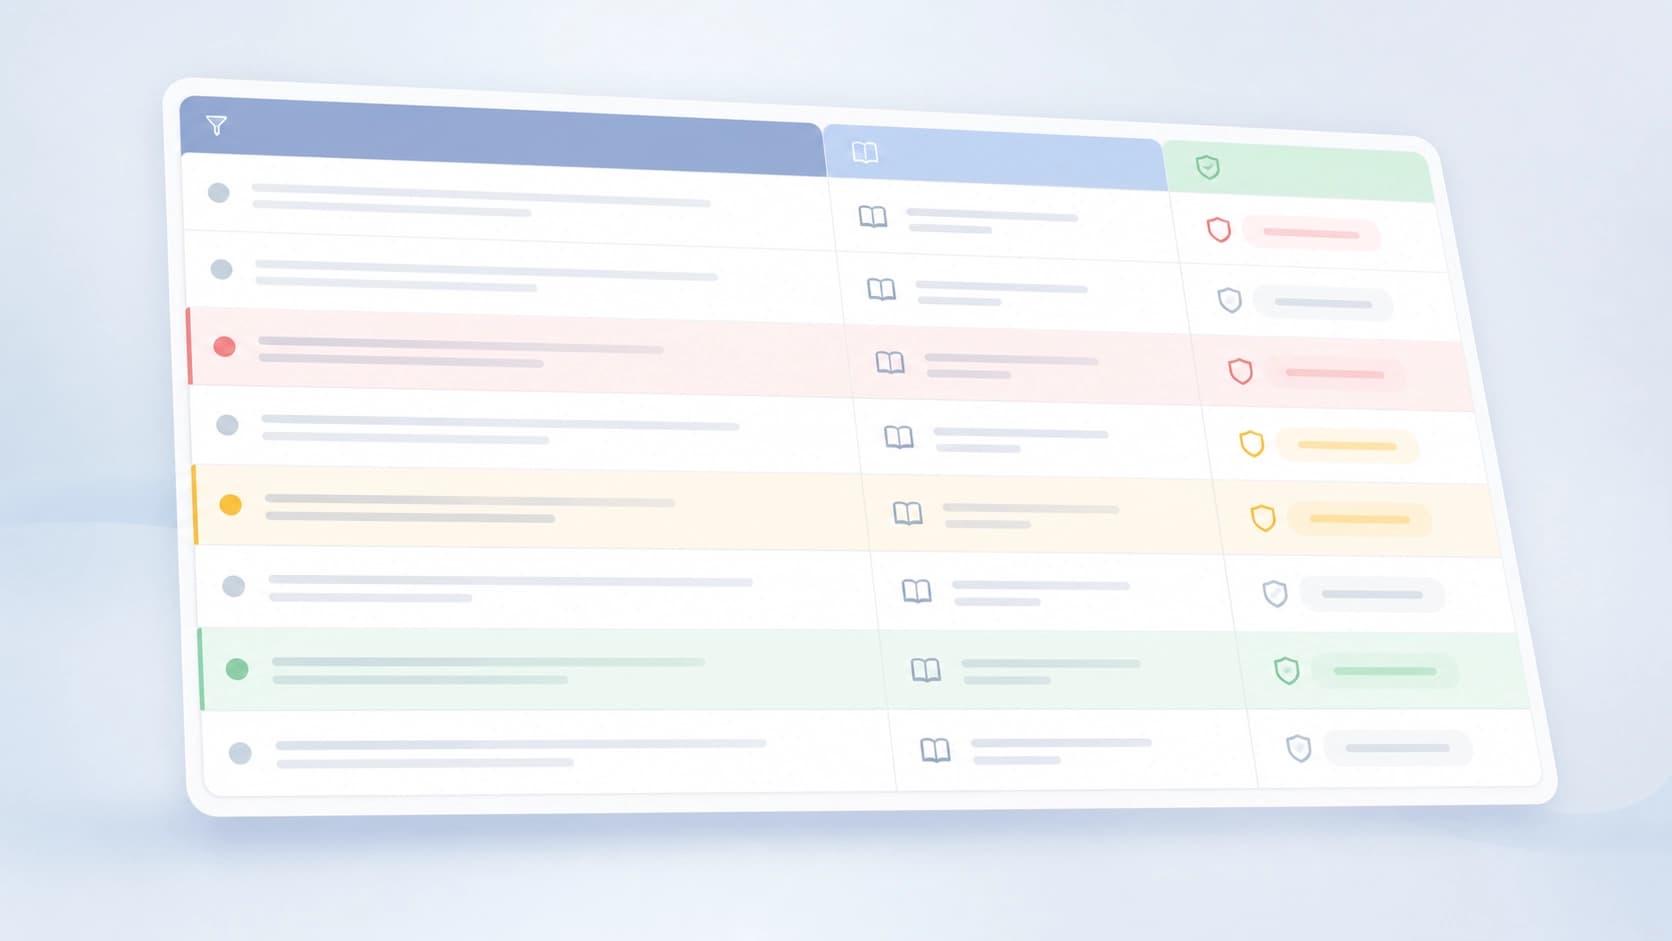
Исследователи взяли рекомендации Американской академии офтальмологии и скомпилировали их в операционную таблицу из 70 строк. Каждая строка описывает условие, по которому диалог можно отнести к нужному классу триажа. Эта таблица сыграла роль «оракула»: она автоматически расставила метки для 3 000 обучающих диалогов. Человеческая разметка понадобилась только для финальной проверки — её использовали как эталон на отдельном наборе из 201 клинического случая, но не в процессе обучения.
Сам перевод клинических текстов в диалоги — нетривиальная инженерная задача. Чтобы сделать его надёжным, авторы описали восемь стратегий конструирования корпуса. Среди них — присвоение уровня по релевантной строке руководства, граничные пары «один факт отличается», исправление ошибок только в метаданных и отдельная починка меток. Каждую стратегию они охарактеризовали с точки зрения доказательности: одна работает как самостоятельный механизм разметки, другая не даёт эффекта, третья смешана с влиянием других факторов, четвёртую можно проверить лишь в составе всего пайплайна.
Такой подход решает проблему не только стоимости, но и обновления: когда меняются клинические рекомендации, достаточно поправить таблицу правил, а не переразмечать тысячи диалогов заново.
Эксперименты: согласованность выросла, recall совершил скачок
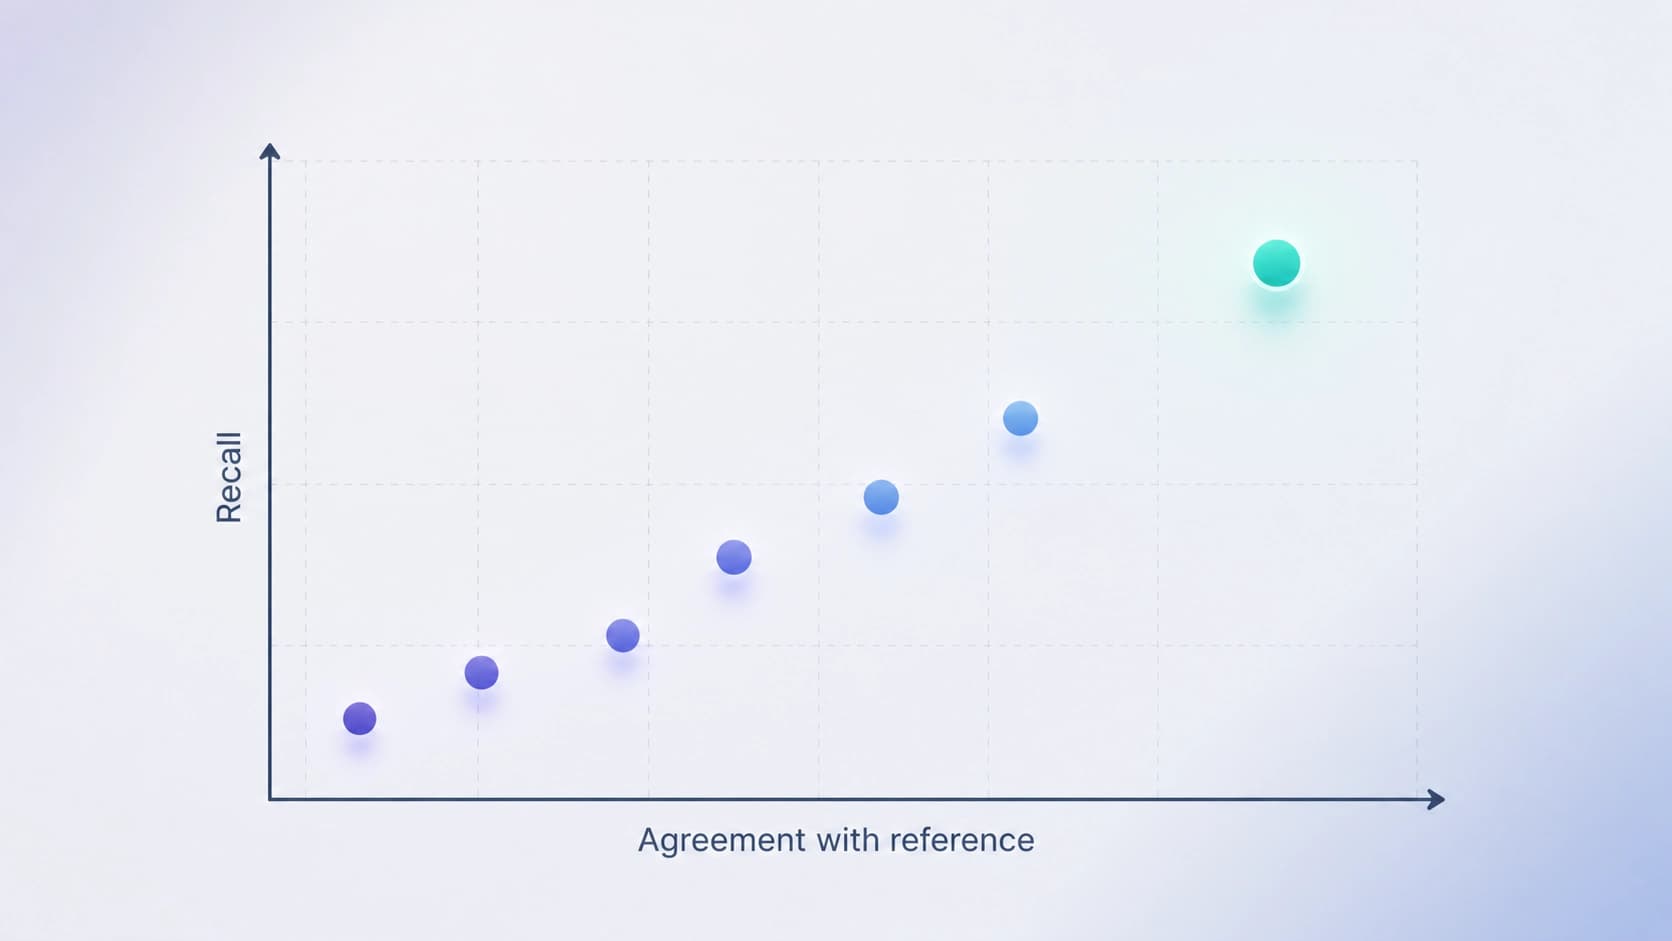
Базой для экспериментов послужила модель с 9 миллиардами параметров. После точной настройки на корпусе из 3 000 автоматически размеченных диалогов получился агент, которого назвали GAO-Triage. На эталоне из 201 случая согласованность ответов с ожидаемым решением выросла с 61,7% до 74,1%. Изменение статистически значимо: точный тест Макнемара дал p = 0,0046.
Особенно заметен рост recall на непредусмотренных случаях. Так называют ситуации, которые не вписываются в стандартный протокол — например, когда пациент описывает симптомы, требующие нешаблонной реакции. Именно здесь агенты обычно чаще всего ошибаются. У GAO-Triage этот показатель вырос с 9,5% до 69,0%, то есть модель стала гораздо реже пропускать потенциально опасные сценарии.
Улучшения не оказались случайными: они сохранились при повторном обучении с другим сидом и на симуляторе пациентов. GAO-Triage сравнили с семью универсальными диалоговыми системами. Ни одна из них не доминировала одновременно по обоим показателям: у кого-то была выше согласованность, у кого-то — recall, но только у GAO-Triage они сочетались. При этом на этапе инференса агент не требует самой мощной frontier-модели и может работать локально на базе с 9B параметров.
Секрет успеха — в назначении меток, а не в тексте
Авторы провели контрольный эксперимент, который объясняет, почему метод работает. Они взяли те же 3 000 диалогов, но перемешали соответствия между диалогами и метками, назначенными правилами. После такого перемешивания модель полностью деградировала и превратилась в постоянный рутинный предиктор: она стала выдавать один и тот же стандартный ответ, игнорируя содержание беседы. Это важный результат. Он показывает, что пользу приносит не поверхностная форма реплик, а именно связь конкретного диалога с классом, выведенным из клинических правил.
Отдельно исследователи проследили за стратегией label repair — исправлением меток на поздних этапах обучения. Её применение совпало с исчезновением деградации безопасности. По-видимому, когда разметку начинают аккуратно вычищать ближе к концу обучения, модель перестаёт сбиваться на небезопасные ответы, которые могут возникать из-за ранних ошибок в данных.
Что это значит для практики
Главный вывод работы: в областях со зрелыми клиническими руководствами диалогового агента можно обучить практически без ручной разметки. Достаточно один раз перевести рекомендации в исполняемые правила, а затем использовать их как супервизора. Небольшая экспертная выборка всё равно нужна — для итоговой оценки качества, — но её объём несопоставим с полной разметкой обучающего корпуса.
Подход не привязан к офтальмологии. Если аналогичные протоколы существуют в кардиологии, неотложной помощи или телемедицине, схему можно адаптировать и там. Главный технический вызов остаётся прежним: клинические рекомендации должны быть переведены в однозначные правила аккуратно и с пониманием предметной области. Но как только это сделано, обучение безопасного медицинского агента становится значительно быстрее и дешевле, а чувствительные данные пациентов остаются под контролем разработчика.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Поэтапная диагностика GUI-агентов при анализе дашбордов: бенчмарк DashAct
Представлен DashAct — бенчмарк из 348 проверенных человеком траекторий, который разбирает работу GUI-агентов с интерактивными панелями на три этапа и четыре визуальных условия. Результаты показывают устойчивые проблемы с предсказанием действий и привязкой к визуальным целям, а также зависимость реакции агентов от контекстной и пространственной поддержки.
11 ноября 2026
WILSON: объединение увеличений и стёкол пациента для патоморфологического анализа и формирования заключений
Препринт представляет WILSON — vision-language модель, которая кодирует изображения целых стёкол и серии препаратов одного пациента при разных увеличениях, а не только отдельный «лучший» слайд. Без дообучения под задачу она обходит специализированные и более крупные слайды-модели по ряду метрик при существенно меньшей вычислительной нагрузке, а её диагностические описания получили более высокие оценки патологов.
11 ноября 2026
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026