
DiSCO: защита text-to-image от вредного контента без доступа к внутренностям модели
Новый метод DiSCO работает как внешний модуль: он подбирает безопасные промпты и снижает долю успешных red-team атак на 37,7% для незащищённых моделей и на 25,13% для уже защищённых систем. При этом точность семантики сохраняется, а когерентность изображений даже улучшается.
Скрытая угроза в безобидных промптах
Современные нейросети, генерирующие изображения по текстовому описанию, умеют создавать впечатляющие картинки, но иногда «выдают» нежелательный контент. Обычно защита таких систем строится на вмешательстве в их внутреннее устройство: переобучении текстового энкодера, корректировке весов или специальной обработке на этапе инференса. Такой подход эффективен, пока у вас есть доступ к самой модели, однако он совершенно не подходит для закрытых проприетарных сервисов, работающих по принципу «чёрного ящика».
В качестве альтернативы пытаются использовать большие языковые модели для автоматического переписывания запросов в безопасный вид. Но и здесь есть слабое место: промпт получается лингвистически абсолютно безобидным, однако из-за того, как модель распределила данные во время обучения, генерация всё равно уходит во вредную область. Авторы называют такой режим «benign adversarial» — когда текст формально безопасен, а результат нет.
Что предлагает DiSCO
Метод DiSCO (Distribution-guided contrastive prompt optimization), разработанный группой исследователей, предлагает совершенно иной путь: защищать генерацию на уровне промптов, не заглядывая внутрь модели. Это строго black-box решение, которое работает как внешний plug-and-play модуль. Ему не нужно дообучение, переобучение или какая-либо информация о параметрах и архитектуре целевой системы.
Идея в том, чтобы автоматически модифицировать суффикс — то есть хвостовую часть промпта — таким образом, чтобы направить генерацию в безопасное русло. Поиск подходящего суффикса выполняется с помощью beam search, а качество кандидатов оценивается контрастивным скорингом. Для этого модуль заранее генерирует при помощи самой целевой модели два пула изображений: безопасные и небезопасные. Сравнивая результаты генерации с эталонными пулами, DiSCO понимает, в какую сторону «дожимать» суффикс.
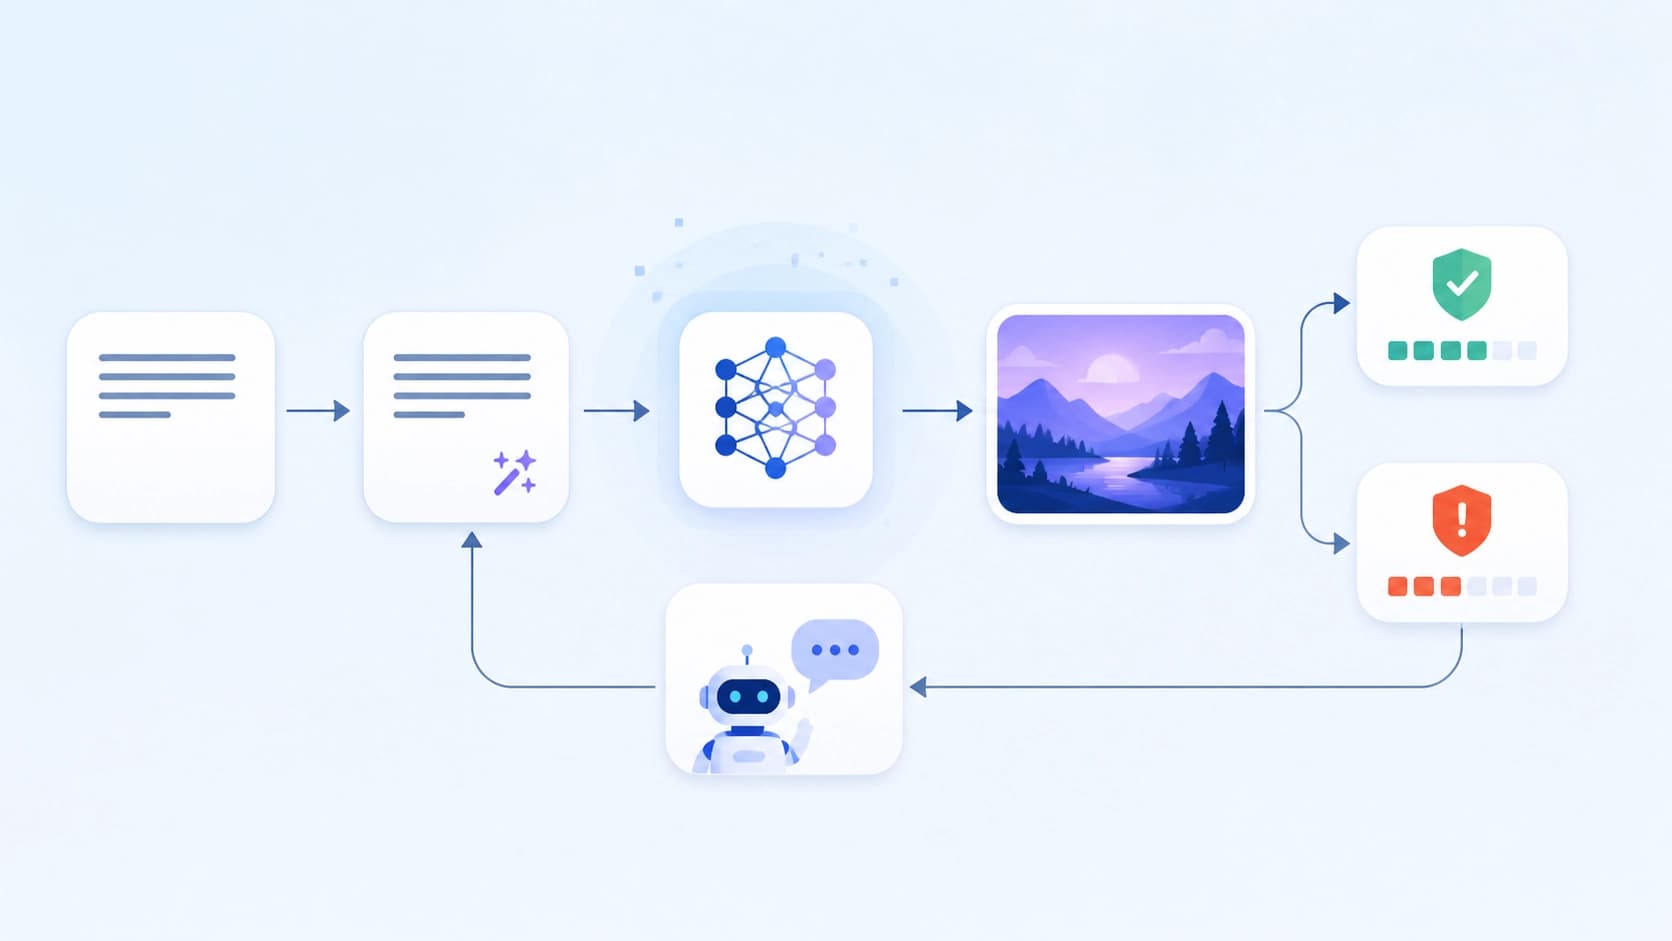
Процесс итеративный: после каждого шага модуль оценивает полученное изображение и, если оно всё ещё содержит нежелательные элементы, подстраивает суффикс заново. Это продолжается до тех пор, пока генерация не станет соответствовать безопасному пулу. При этом ни один этап не требует раскрытия внутренностей модели — всё взаимодействие идёт только через отправку промптов и получение картинок.
Насколько это эффективно
Исследователи протестировали DiSCO на бенчмарке I2P (Inappropriate Image Prompts) в сценариях множественных red-teaming атак. Результат показывает, что уровень успешных атак снижается на 37,7% для моделей без какой-либо защиты и на 25,13% для моделей, которые уже были защищены другими методами. Это значит, что DiSCO не просто закрывает дыры там, где защиты нет, но и усиливает уже существующие барьеры.
Показательно, что при этом семантическая точность не страдает: сгенерированные изображения остаются релевантными исходному промпту, а когерентность даже улучшается. Иными словами, модуль не портит качество генерации, а лишь уводит её от потенциально опасных интерпретаций.
Поскольку DiSCO архитектурно-агностичен, его можно подключить к любой text-to-image системе, не меняя саму модель. Это особенно ценно для закрытых коммерческих API, где доступ ограничен, и для пользователей, которые хотят повысить безопасность чужих сервисов — например, перед использованием в публичных приложениях.
Несмотря на впечатляющие результаты, стоит помнить, что метод — это не «серебряная пуля», а один из слоёв защиты. Полностью исключить риски вряд ли удастся, но смещение подхода с «внутренней» безопасности на «внешнюю» и адаптивную — важный шаг в сторону устойчивости генеративных систем к вредоносным запросам.
Часто задаваемые вопросы
Похожие материалы
Все материалы
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026
STAR: адаптивная нормализация временного контекста и графа сервисов для сквозного инцидент-менеджмента
Фреймворк STAR учит представления по метрикам, журналам и трассировкам, применяя обучаемую нормализацию с учётом многомасштабной временной динамики и структуры зависимостей между сервисами. На двух реальных наборах данных такой контур обеспечивает устойчивый рост качества выявления аномалий, сортировки отказов и поиска корневых причин относительно современных базовых методов.
10 ноября 2026