Что проверяет симуляция
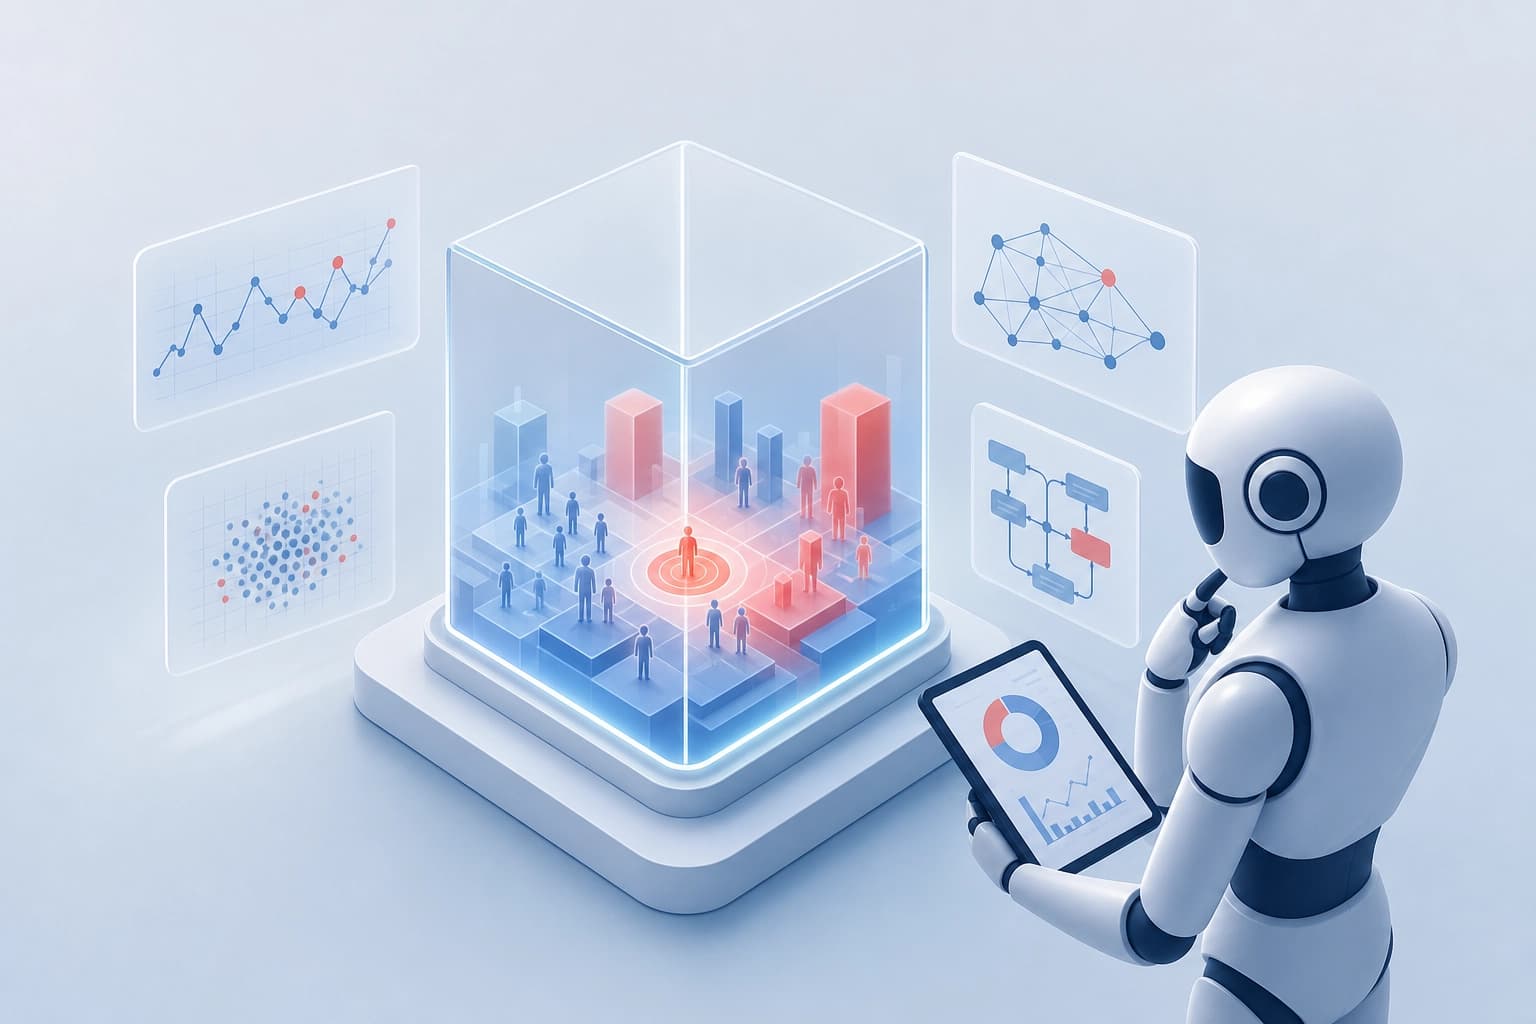
TRACE — диагностическая среда для цифровой рекламы. Она охватывает 12 корневых причин и детальную атрибуцию сегментов. В каждом эпизоде агент исследует данные с помощью Python и SQL. Затем он определяет корневую причину и, если применимо, затронутый сегмент.
TRACE описана в работе Rui Sun, Zhan Shi и Bing He, поданной на arXiv 9 сентября 2026 года. Идентификатор работы — arXiv:2609.10315.
Как формируется проверка
Проверка строится вокруг вмешательства и наблюдений, которые оно вызывает:
- Выбирают вмешательство и вводят его в контролируемый симулятор.
- Симулятор генерирует соответствующие наблюдения.
- Агент исследует данные и ищет причину сбоя.
- Скрытое вмешательство служит эталонной меткой и позволяет вычислить объективную награду.
Агент не получает готовое объяснение. Он должен сопоставить шумные, смешанные и распределённые по данным свидетельства. Так симуляция проверяет причинный вывод, а не только распознавание заранее заданного ответа.
Как читать результаты
Авторы оценивали модели на отложенном тестовом наборе из 235 эпизодов. Сильнейший prompting baseline — Claude Opus 5 с результатом 0.686 FullAttr@1.
| Модель или этап | Результат |
|---|---|
| Qwen3.5-35B-A3B после supervised fine-tuning | 0.159 → 0.637 |
| Та же модель после RL с синтезированными наградами | 0.757 |
| Qwen3.5-122B-A10B в prompting baseline | Ниже результата 0.757 |
Результат 0.757 превысил все оценённые prompting baselines, включая frontier-модели с закрытым исходным кодом. Авторы также сообщают, что полученная policy использовала существенно меньше вызовов инструментов, чем prompting-версия базовой модели на 35B.
Что показывают результаты для обучения агентов
Авторы считают доступ к масштабируемому объективному сигналу обучения потенциально более важным ограничением, чем один лишь размер модели. Это вывод по результатам описанной задачи, а не универсальное правило для любых AI-систем.
Симуляционная проверка может сделать неоднозначные задачи диагностического рассуждения пригодными для масштабируемого обучения с подкреплением. Ключевое условие — возможность сопоставить вывод агента со скрытым вмешательством и вычислить объективную награду.
Когда такой подход уместен
Симуляция подходит для проверки причинных выводов, если постановка позволяет:
- задавать вмешательство и вводить его в контролируемую среду;
- генерировать связанные с ним наблюдения;
- сохранять вмешательство как скрытую эталонную метку;
- оценивать и корневую причину, и затронутый сегмент, когда это применимо.
Если задача не допускает такого сопоставления с эталонной меткой, описанный механизм объективной награды не обеспечен. Практический критерий выбора — можно ли проверить вывод агента по скрытой причине, не раскрывая её во время анализа.