
CARAT: проверяют, выводят ли материаловедческие LLM структуру или пересказывают подсказку
В работе предлагается протокол, который фиксирует вопрос и эталон при восьми способах подачи структуры и отдельно помечает связи в GraphSpace. Эксперименты с парным дообучением, маскированием целевых полей и добавлением свидетельств показывают, что модель способна освоить и применение отношения, и следование ссылке, однако удаление ссылки снижает точность ниже уровня эвристических обходов.
Почему точность не доказывает рассуждение
Языковая модель для материаловедения может дать верный ответ по двум разным причинам. Она либо выводит его из структурных данных, либо воспроизводит значение, уже присутствующее во входе. Обычная метрика точности эти случаи не различает. Структурное описание может содержать поле, по которому оценивают ответ, и тогда балл отражает чтение подсказки.
Бенчмарк CARAT построен вокруг этого различения. Он проверяет, рассуждают ли материаловедческие LLM на основе структурных данных или пересказывают подсказку. Авторы статьи — Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li и Bin Chong; работа подана 29 сентября 2026 года.
Практический критерий: высокая точность на структурных данных сама по себе ничего не доказывает. Смотреть нужно на условия, в которых ответ получен.
Как устроено сопоставленное сравнение
Вопрос и эталонный ответ сохраняются неизменными для восьми сопоставленных представлений. Структурные отношения обозначаются отдельно, в GraphSpace.
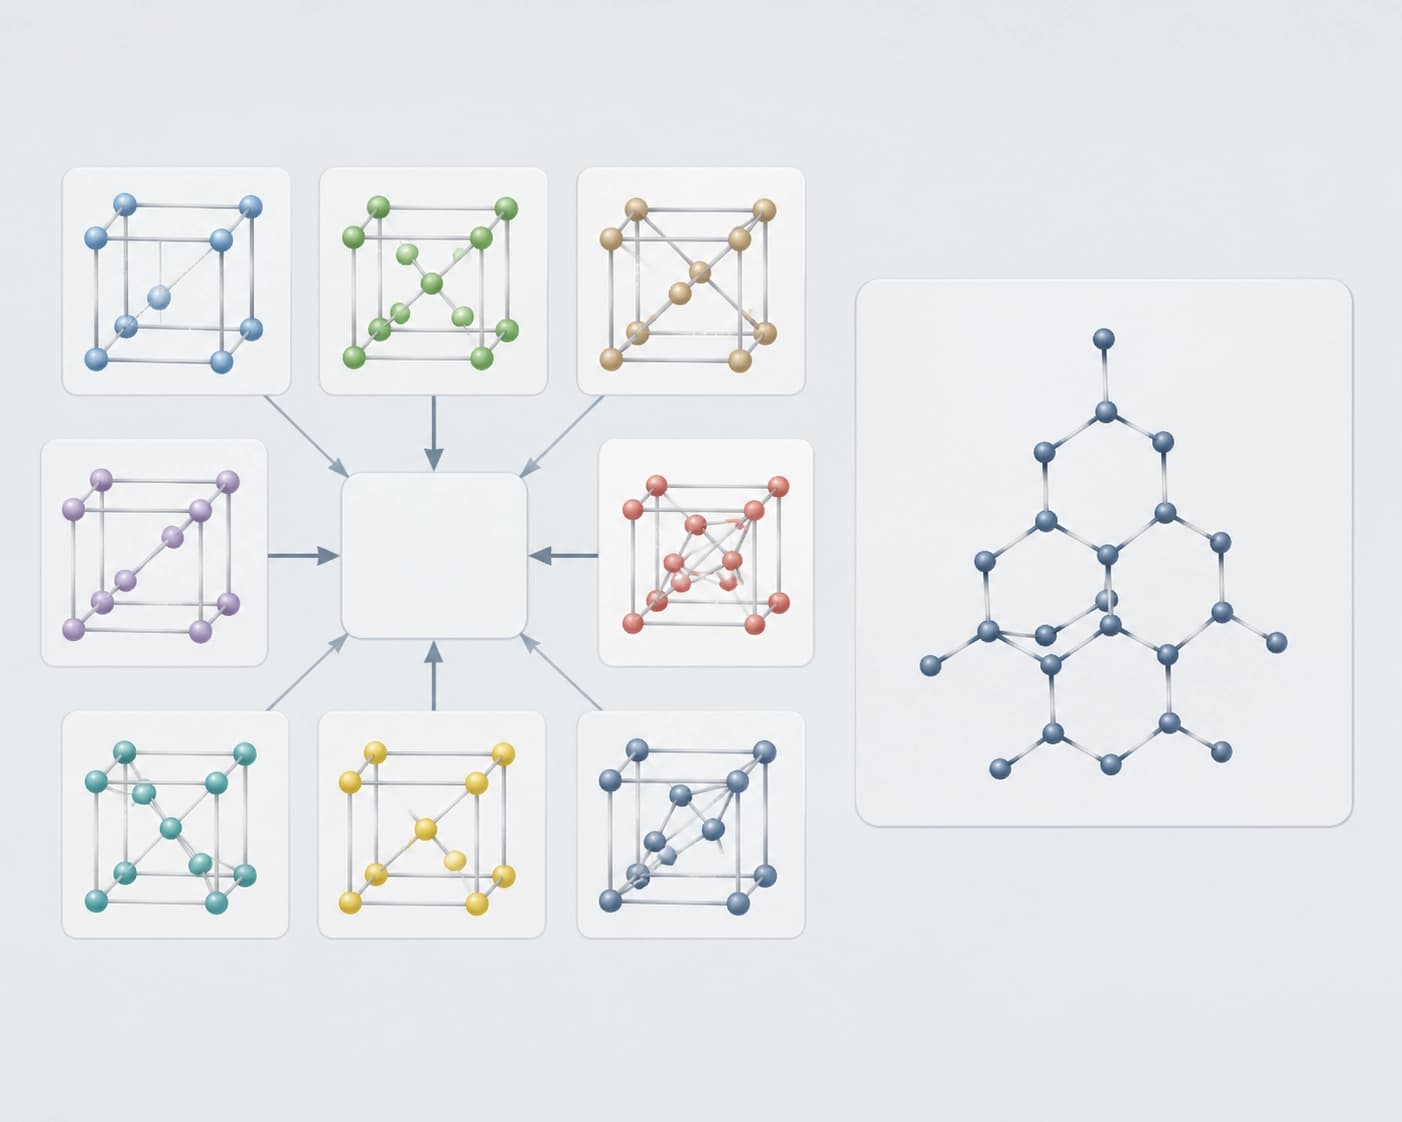
К этому добавляются сопоставленное дообучение, маскирование ответов, добавление свидетельств, парный инференс и правило, позволяющее воздержаться от утверждения.
| Что сравнивают | Разница |
|---|---|
| Представление с опорой на структуру против ввода только формулы на самых сложных семействах задач | 17.3 points |
Фиксированный вопрос убирает объяснение через формулировку задания. Маскирование ответов мешает модели подставить готовое значение.
Вывод: сравнивать представления имеет смысл только при неизменных вопросе и эталоне. Иначе разница покажет качество текста задания, а не работу со структурой.
Чему равен разрыв между GraphSpace и простым графом
GraphSpace превосходит простой периодический граф на 19.3 points. Этот разрыв складывается из двух разных эффектов.
| Условие | Разница |
|---|---|
| Простое представление содержит всё необходимое для ответа | 1.96 points |
| В простом представлении этих полей полностью нет | 46.7 points |
Когда базового представления достаточно для ответа, преимущество почти исчезает. Когда нужных полей в нём нет, разрыв становится большим. Авторы отмечают: основной результат сравнения отражает нехватку данных в базовом представлении, а не способ представления свидетельств.
Практический критерий: перед выводом о превосходстве одного представления проверяйте, какие поля в нём есть. Иначе измеряется полнота данных, а не метод.
Обходные стратегии и переработка бенчмарка
Проверка вскрыла слабое место набора задач. Правило, которое пропускает ссылку и читает список напрямую, отвечает на четыре из семи усложнённых семейств задач. Модель может не разбираться в отношении, а просто обходить его.
Бенчмарк переработали. Одиннадцать таких обходных стратегий стали давать результаты, близкие к случайным.
Вывод: набор задач годится для оценки рассуждения только после проверки на обходные пути. Если простое правило решает часть семейств, замеряет оно не рассуждение.
Ссылка в ответе и опора на отношение
Замороженная модель цитирует ссылку, но при её перенаправлении даёт тот же ответ в 95.6% парных случаев. Модель повторяет отношение, не используя его.
| Условие | Доля парных случаев с тем же ответом |
|---|---|
| Замороженная модель, ссылку перенаправляют | 95.6% |
| После сопоставленного обучения, ссылку перенаправляют | 99.8% |
| Ссылку удаляют | 23.4% |
| Лучшая обходная стратегия | 27.0% |
После сопоставленного обучения показатель достигает 99.8%. Удаление ссылки снижает его до 23.4%, что ниже 27.0%, которые даёт лучшая обходная стратегия. Авторы заключают, что оба шага обучения — использованию отношения и опоре на ссылку — поддаются освоению.
Критерий: цитирование ссылки не равно её использованию. Проверять нужно поведение модели при перенаправлении и при удалении ссылки.
Что из этого следует для оценки инструментов
- Проверяйте, не содержит ли вход готовый ответ на поставленный вопрос.
- Смотрите на результаты при перенаправлении и удалении ссылки, а не только на цитирование.
- Требуйте описания контроля: неизменные вопрос, эталон и несколько представлений.
- Уточняйте, обновлён ли набор задач после проверки на обходные стратегии.
- Оценивайте заявленный разрыв вместе с составом данных, а не отдельной цифрой.
Критерий выбора: результат заслуживает доверия, если его нельзя объяснить наличием нужного поля в подсказке или действием простого обходного правила.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Британский инспектор по иммиграции решает, проверять ли GPT-4 в Home Office
Независимый надзорный орган по границам и иммиграции запросил у правозащитной организации сведения о двух системах на базе OpenAI, которые Home Office применяет при работе с материалами просителей убежища. Статья объясняет, почему сомнения в точности сводок, отсутствие публичного реестра и скрытость применения могут привести к официальной проверке и юридическим претензиям.
3 ноября 2026
Переход к вероятностному симплексу сокращает модальный разрыв в контрастивных мультимодальных моделях
В работе arXiv:2610.32890 предлагается заменить сферические эмбеддинги вероятностным симплексом, добавив лёгкие softmax-адаптеры и сходство Total Variation. На пяти бенчмарках поиска центроидное ℓ2-расстояние между модальностями снижается на 97–99% при сохранении или росте качества поиска.
3 ноября 2026
Как ActionRAG пересматривает свидетельства при диффузии по графу памяти LLM-агентов
Предложена архитектура графовой памяти, которая на этапе индексации аккуратно согласует сущности, а при запросе заново оценивает связи с опорой на локальную структуру. На MemoryAgentBench метод показал среднюю точность 55,1 и прирост 5,4 п.п. к сильнейшему извлекающему baseline при стоимости синтеза ниже $0,001 за запрос.
3 ноября 2026