
CaLR: латентная оптимизация с причинными ограничениями для устойчивого вывода диффузионных моделей
Работа предлагает CaLR — подход, при котором рассуждение сводится к оптимизации с ограничениями в латентном пространстве; источником структуры служит матрица причинной топологии из экспертной модели, а обучение опирается на неявное дифференцирование. Метод повышает согласованность и позволяет корректировать промежуточные результаты по ходу параллельной генерации, что даёт лучшие показатели на сложных наборах данных и в задачах с жёсткими ограничениями, включая судоку.
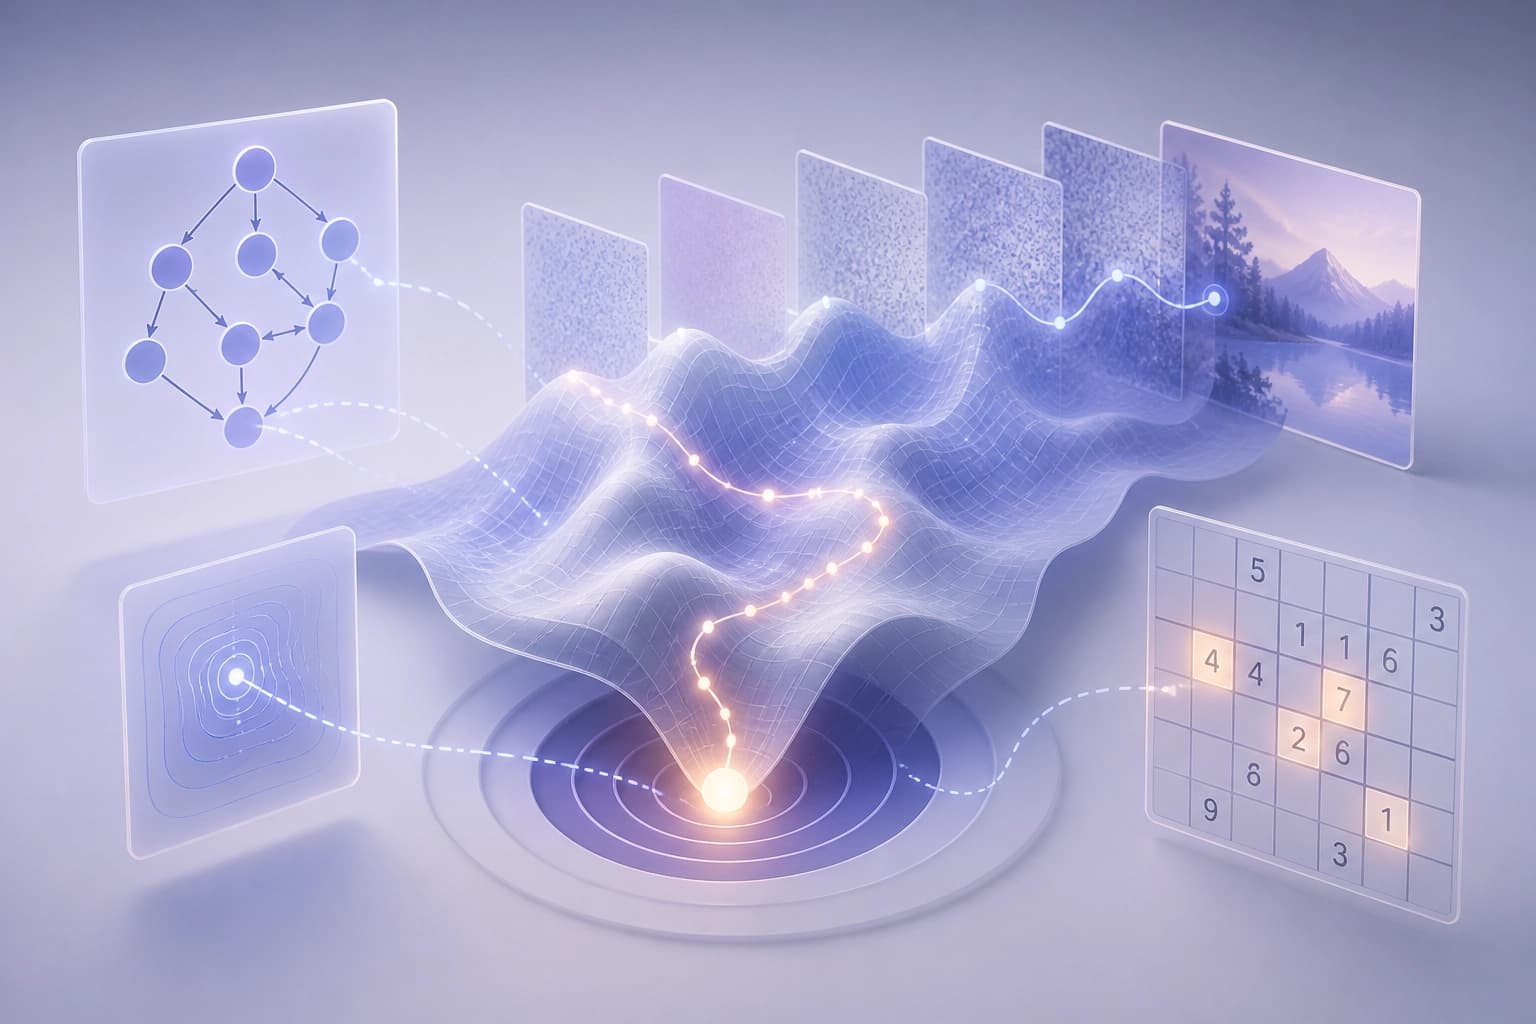
Проблема: локальная жадность AR и слабая причинность DLM
Авторегрессионные модели страдают от локальной жадности. Диффузионным языковым моделям часто не хватает строгой причинной структуры для рассуждений.
| Тип модели | Ограничение |
|---|---|
| AR | Локальная жадность |
| DLM | Недостаток строгой причинной структуры для рассуждений |
Вывод: для рассуждений нужен механизм, который соединяет генерацию с причинными ограничениями. Практический критерий: проверять, как модель удерживает логическую структуру на промежуточных шагах.
Фреймворк и его задача
CaLR — фреймворк для устойчивого вывода диффузионных моделей. Он формулирует рассуждение как constrained latent optimization. Полное название: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning». Авторы: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. Дата подачи: 17 Sep 2026.
Вывод: CaLR связывает устойчивый вывод с оптимизацией латентного представления. Практический критерий: выбирать метод, если задача требует причинной структуры в рассуждении.
Компоненты подхода
CaLR использует три элемента. Первый — causal topology matrix (CTM). Матрицу получают от expert model. Второй — implicit differentiation. Третий — градиентно-направленная «thought revision».
Causal topology matrix (CTM)
CTM — причинная топологическая матрица. Ее источник — expert model.
Implicit differentiation
CaLR использует implicit differentiation.
Градиентно-направленная «thought revision»
Эта операция предназначена для обеспечения логической согласованности. Она также предназначена для динамической самокоррекции промежуточных шагов во время параллельной генерации.
Вывод: CTM дает причинную структуру, implicit differentiation входит в оптимизацию, thought revision правит шаги. Практический критерий: проверять наличие источника причинной структуры и механизма коррекции.
Заявленные результаты
CaLR достигает SOTA производительности DLM на сложных бенчмарках. Фреймворк превосходит сильные AR-базлайны. Он демонстрирует повышенную устойчивость в задачах с ограничениями, таких как Sudoku.
| Свойство | Результат |
|---|---|
| Производительность DLM | SOTA на сложных бенчмарках |
| Сравнение с AR | Превосходит сильные AR-базлайны |
| Устойчивость | Повышенная устойчивость в задачах с ограничениями, например Sudoku |
Вывод: заявленные преимущества касаются сложных бенчмарков и задач с ограничениями. Практический критерий: сопоставлять требования задачи с устойчивостью в задачах с ограничениями. Для других сценариев в аннотации данных нет.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026