
ИИ объясняет свою оценку мастерства хирурга по видео операций на катаракту
Исследователи создали платформу, которая автоматически оценивает навыки хирургов по видеозаписям операций. Система, протестированная на 83 видео, показывает до 87% совпадения с экспертами и делает выводы прозрачными.
Проблема субъективной оценки хирургических навыков
Обучение хирургов-офтальмологов невозможно представить без обратной связи от опытных наставников. Однако традиционная оценка мастерства по видео операций остаётся во многом субъективной: два эксперта могут по-разному интерпретировать одни и те же движения инструмента. Это замедляет подготовку специалистов и создаёт риск ошибок в аттестации.
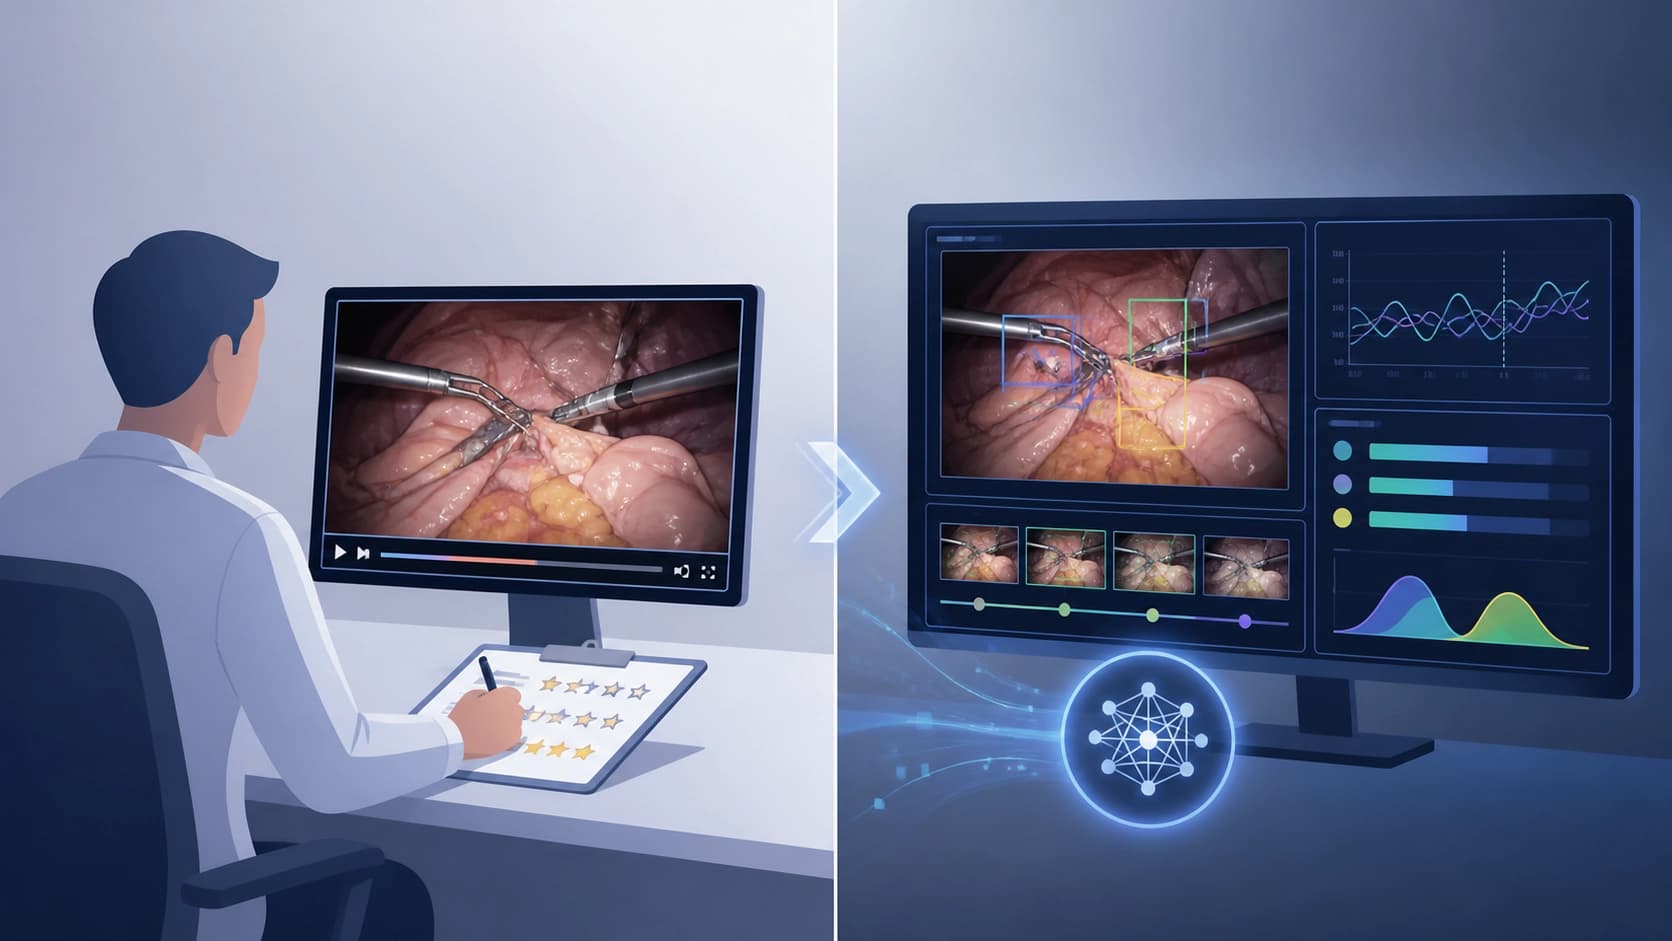
Автоматизированные системы, которые пытались решить эту задачу раньше, часто работали как «чёрный ящик»: они выдавали итоговый балл, но не объясняли, на основании каких именно движений он поставлен. Для обучения такой ответ бесполезен — молодой хирург не понимает, что именно ему нужно исправить.
Объяснимая ИИ-платформа для анализа видео операций
Группа исследователей представила новую платформу, которая сочетает компьютерное зрение и обработку сигналов. Её задача — не просто определить уровень мастерства, а показать, какие именно движения рук, скорость и траектория инструмента повлияли на оценку. В отличие от прежних «непрозрачных» решений, здесь каждый вывод можно проследить до конкретной метрики.
Система опирается на крупнейший на сегодняшний день набор данных: 2000 записей операций по удалению катаракты. Это позволяет алгоритмам обучаться на разнообразных техниках и стилях работы, а не только на ограниченной выборке.
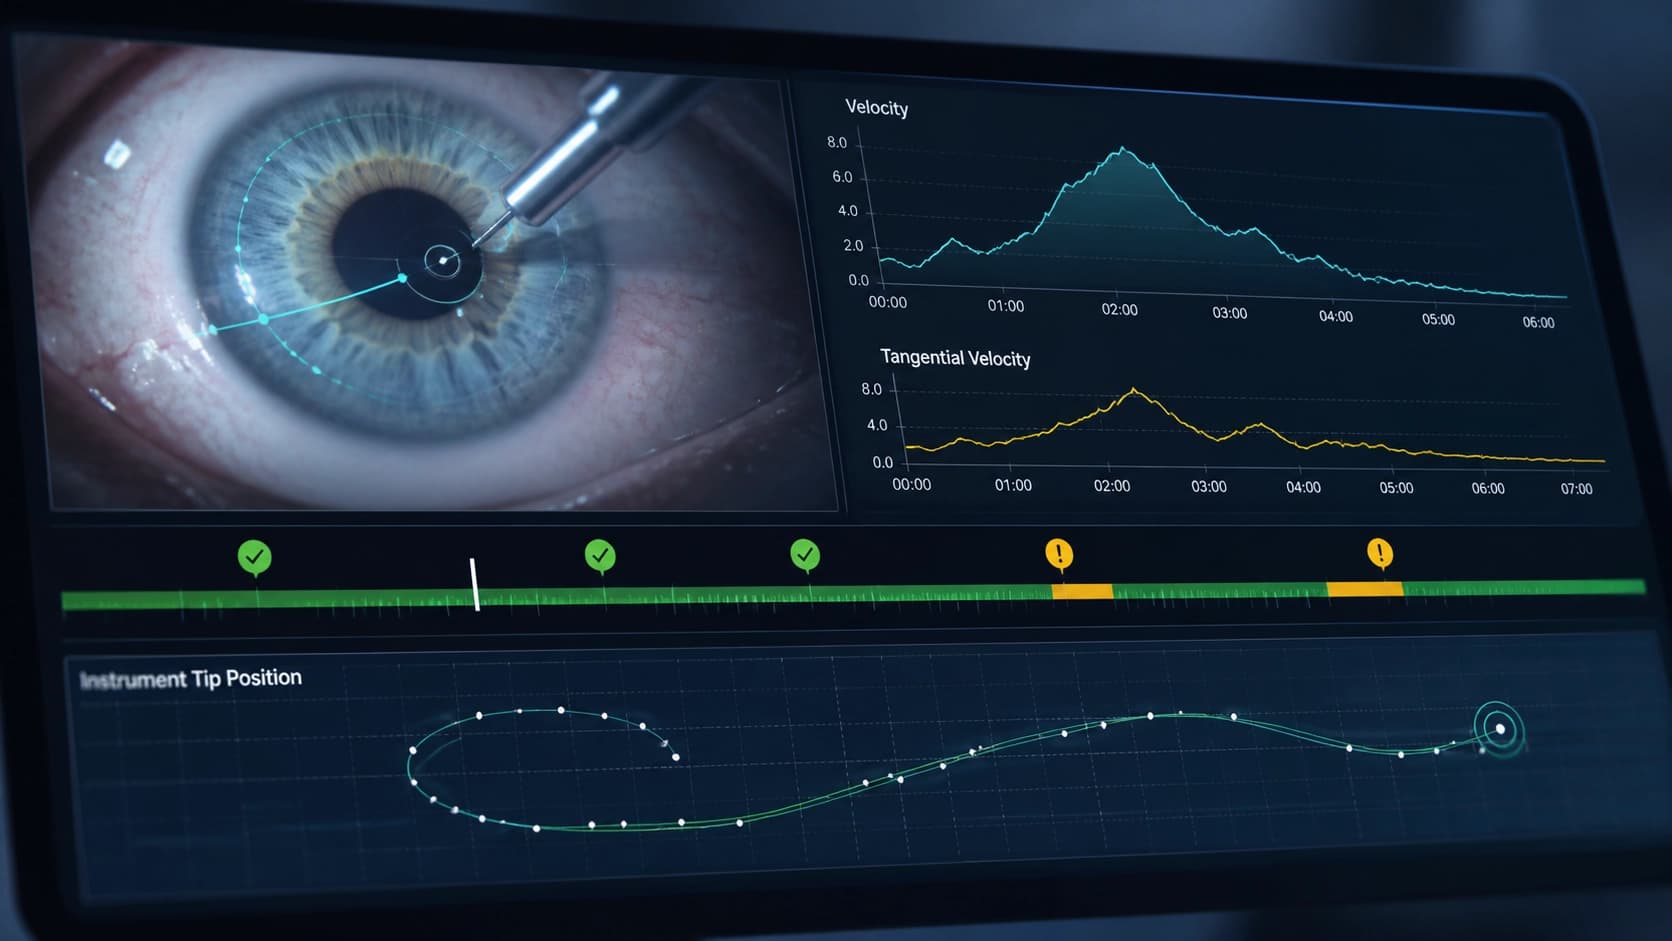
Ключевая особенность — объяснимость. Платформа извлекает из видео десять объективных метрик движения, например плавность перемещения инструмента, скорость, точность траектории. Эти метрики сопоставляются с оценками экспертов, но в отличие от человека машина может указать на конкретные фрагменты операции, где движения были неуверенными или неоптимальными.
Как проверяли точность системы
В экспериментальном исследовании использовали 83 видеозаписи операций. Эксперты-хирурги оценивали каждую по новой шкале CSAS (Capsulorhexis Skill Assessment System), ориентированной на ключевой этап — капсулорексис. Затем эти субъективные оценки сравнили с десятью автоматически вычисленными метриками.
Результат показал высокую согласованность между мнением людей и расчётами алгоритма. Точность предсказания уровня мастерства достигла 87%. Причём важно, что корреляция прослеживалась по каждой метрике в отдельности, а не только по итоговому баллу. Это подтверждает: система не просто «угадывает», а действительно распознаёт значимые паттерны движений.
Что это значит для практики
Объяснимый ИИ может стать полезным инструментом в резидентуре и непрерывном медицинском образовании. Молодой хирург получает не просто оценку «выше среднего», а разбор конкретных движений, которые стоит улучшить. Аттестационная комиссия — объективные количественные данные в дополнение к субъективным впечатлениям.
Разработчики подчёркивают, что их платформа не заменяет экспертов, а даёт им мощную поддержку. Потенциально она способна унифицировать стандарты оценки по всему миру, сделав подготовку хирургов более прозрачной и воспроизводимой. Следующий шаг — расширение валидации на более крупных выборках и других этапах операции катаракты.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026