
Способны ли ИИ-агенты придумать что-то по-настоящему новое: обзор исследования алгоритмических решений
Авторы работы проверили, как методы, созданные LLM-агентами, соотносятся с разработками людей: в редких случаях агенты выходят на уровень человека или обходят его, однако почти все их решения остаются в рамках уже известных алгоритмических подходов и часто повторяют существующие.
О чём исследование
Может ли ИИ-агент самостоятельно придумать новый метод для решения сложной задачи — или он лишь переставляет фрагменты уже известных решений? Этому вопросу посвящена свежая работа «When AI Designs AI: Innovation or Imitation?» (arXiv:2608.17471), авторы — Yikang Yang, Zhengxin Yang, Luzhou Peng и коллеги. Научная группа подала статью 18 августа 2026 года; она затрагивает сразу два раздела: cs.AI и cs.LG.
Авторы исходят из простой, но важной идеи: мало показать, что агент справился с задачей. Нужно ещё понять, насколько оригинальным был его подход. Поэтому в работе сформулировано два вопроса:
- действительно ли методы, предложенные агентами, работают не хуже человеческих;
- отличаются ли эти методы по своей алгоритмической структуре от того, что обычно создают люди.
Как устроен анализ
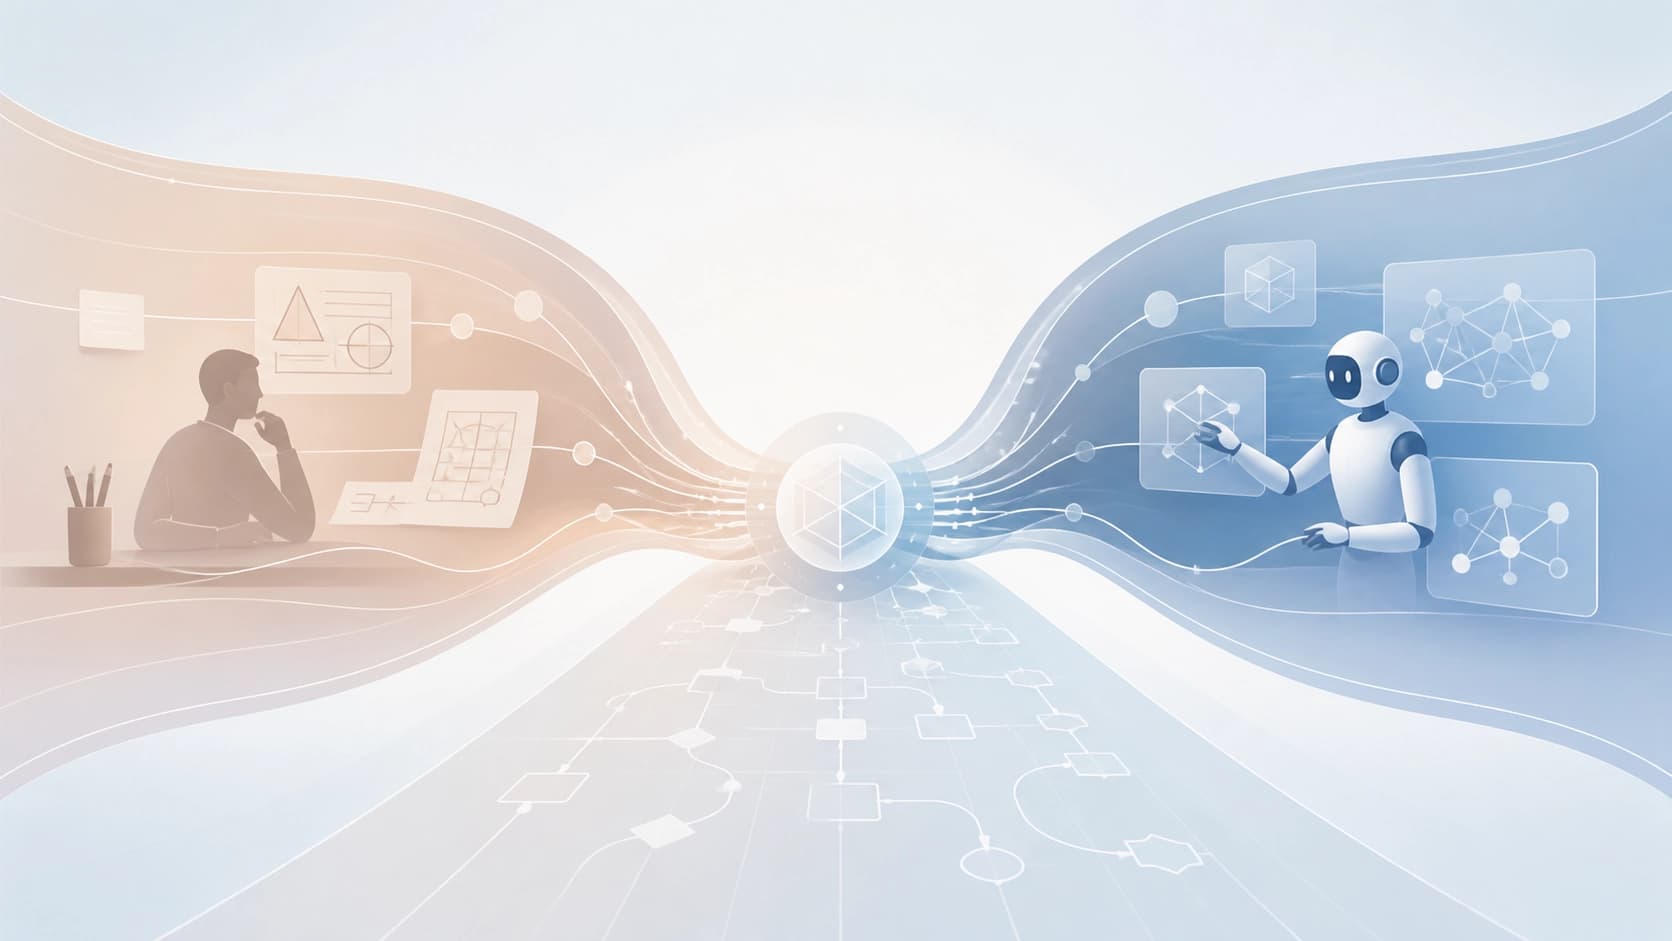
Чтобы ответить на вопросы, исследователи построили специальный каркас. Сначала из набора человеческих методов для конкретной задачи выводятся так называемые пространства алгоритмических дизайнов — то есть множество типовых модулей и связей между ними, характерных для решений, придуманных людьми. В эти пространства затем отображаются и человеческие, и агентские методы. Разница между ними измеряется на уровне отдельных модулей — это позволяет увидеть, какие части решения совпадают, а какие возникают заново.
Эксперимент провели на нескольких широко используемых LLM-агентах и подборке открытых ИИ-задач, покрывающих разные модальности: текст, изображения и прочее. Для каждого сгенерированного агентами метода оценивались два параметра: качество решения задачи и степень алгоритмического отличия от человеческих аналогов.
Что это даёт на практике
Такой подход позволяет не просто сказать «агент победил» или «агент проиграл», а отделить успешность от новизны. Система может выдать отличный результат, но при этом полностью скопировать известную схему. И наоборот — предложить необычный дизайн, который работает хуже. Именно эту двойственность и пытались зафиксировать авторы.
Что показали результаты
Первая часть результатов звучит обнадёживающе: в некоторых случаях современные агенты выходят на уровень человеческого state-of-the-art и даже превосходят его. Таких успешных конфигураций нашлось 10 из 72. Однако стабильности нет: успех не переносится надёжно ни на другие задачи, ни на других агентов. Иными словами, агент, который блестяще справился с одной задачей, может полностью провалить соседнюю — закономерности, по которой можно предсказать успех, пока не видно.
Куда более показательной оказалась вторая часть. Почти все созданные агентами методы — 96,8% — попадают в те самые пространства алгоритмических дизайнов, которые выведены из человеческих решений. Агенты не выходят за пределы того, что уже придумали люди; они в основном комбинируют и переставляют знакомые алгоритмические блоки. Причём примерно половина сгенерированных методов вообще в точности совпадает с уже существующими человеческими дизайнами.
Выводы
Авторы исследования приходят к двойственному заключению. С одной стороны, современные LLM-агенты уже способны создавать решения, сопоставимые с лучшими человеческими разработками, а иногда и превосходящие их. С другой — об их «настоящей» новизне говорить пока рано. Почти всё, что они делают, — это аккуратное повторное использование и перекомбинация уже открытых алгоритмических идей. Настоящий прорыв за пределы человеческого пространства дизайна — редкое исключение, а не правило.
Это не значит, что агенты бесполезны: умение быстро находить рабочую комбинацию из известных методов само по себе ценно. Но если цель — получить принципиально новый алгоритм, полагаться только на текущее поколение агентов, судя по результатам, не стоит. Возможно, следующим шагом станет не просто «более умный» агент, а агент, обученный сознательно выходить за пределы известных паттернов.
Часто задаваемые вопросы
Похожие материалы
Все материалы
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026
STAR: адаптивная нормализация временного контекста и графа сервисов для сквозного инцидент-менеджмента
Фреймворк STAR учит представления по метрикам, журналам и трассировкам, применяя обучаемую нормализацию с учётом многомасштабной временной динамики и структуры зависимостей между сервисами. На двух реальных наборах данных такой контур обеспечивает устойчивый рост качества выявления аномалий, сортировки отказов и поиска корневых причин относительно современных базовых методов.
10 ноября 2026