
SpecEvo: alinhamento de LLM leves e avançados para reduzir o custo da busca evolutiva
O framework SpecEvo redistribui a pesquisa evolutiva: os candidatos comuns refinam modelos económicos, enquanto os mais poderosos só são acionados em pontos de controlo estratégicos, com base no histórico de sucessos e impasses. Em experiências com 176 tarefas, esta abordagem permitiu igualar ou superar alternativas mais dispendiosas, reduzindo os custos de API em 80%.
Objetivo e finalidade
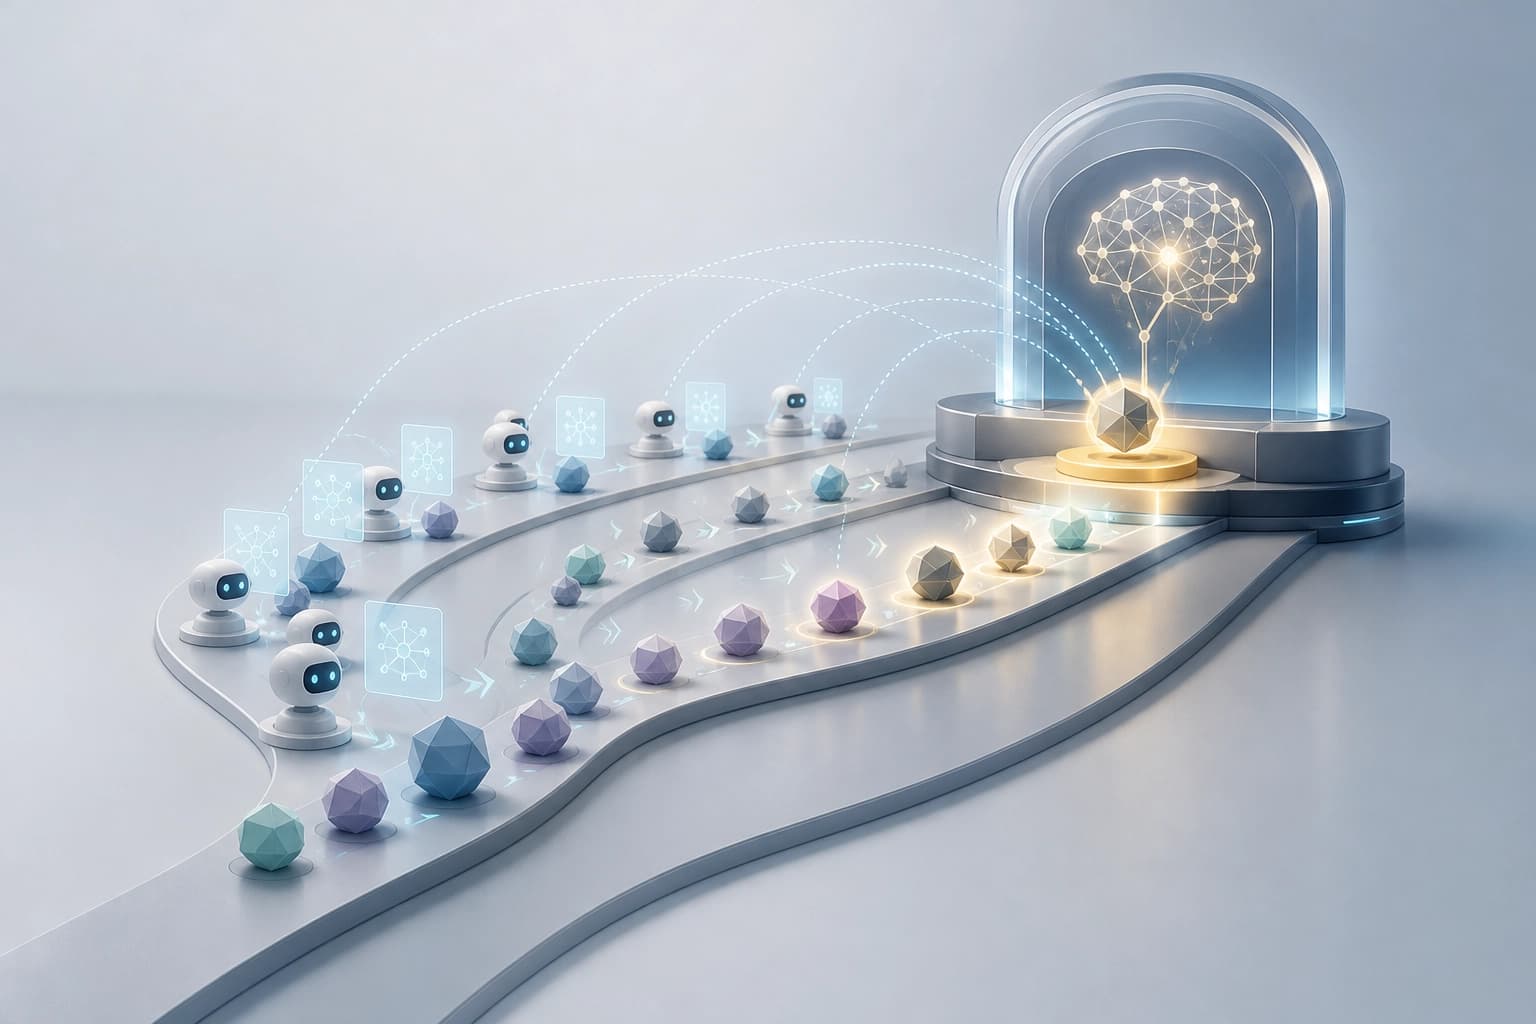
SpecEvo (Speculative Evolution) é uma estrutura multi-LLM para descobertas científicas. Coordena modelos leves e de ponta para reduzir o custo da pesquisa de programas candidatos. O artigo arXiv:2610.28706 foi submetido em 20 de outubro de 2026. Os autores são Ha Minh Hieu, Tongyao Zhu, Do Xuan Long e Min-Yen Kan.
Principais características:
- tipo: estrutura multi-LLM;
- finalidade: descobertas científicas e pesquisa algorítmica;
- princípio: coordenação de modelos leves e de ponta;
- artigo: arXiv:2610.28706, submetido em 20 de outubro de 2026;
- autores: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan.
Critério prático: considerar a estrutura para tarefas em que o custo da API é importante e é necessária a pesquisa de programas candidatos com etapas de controlo pouco frequentes.
Arquitetura: funções dos modelos leves e de ponta
SpecEvo distribui o trabalho entre modelos leves e de ponta. Os modelos leves executam em paralelo as funções de Speculators e Advisor. O modelo de ponta atua como Navigator em etapas de controlo pouco frequentes.
| Componente | Tipo de modelo | Função | Modo de funcionamento | | Speculators | leves | geram e aperfeiçoam programas candidatos | em paralelo | | Advisor | leve | sintetiza sucessos, falhas e direções saturadas; transforma-os em recomendações permanentes | síntese de informações acumuladas | | Navigator | de ponta | estuda a população em evolução; intervém através de síntese, aperfeiçoamento direcionado ou mudança do enquadramento da pesquisa | raramente, em etapas de controlo |
Critério prático: atribuir a pesquisa habitual e a síntese de evidências aos modelos leves e recorrer a modelos de ponta para intervenções estratégicas.
Fluxo de trabalho «primeiro formular hipóteses, depois consolidar»
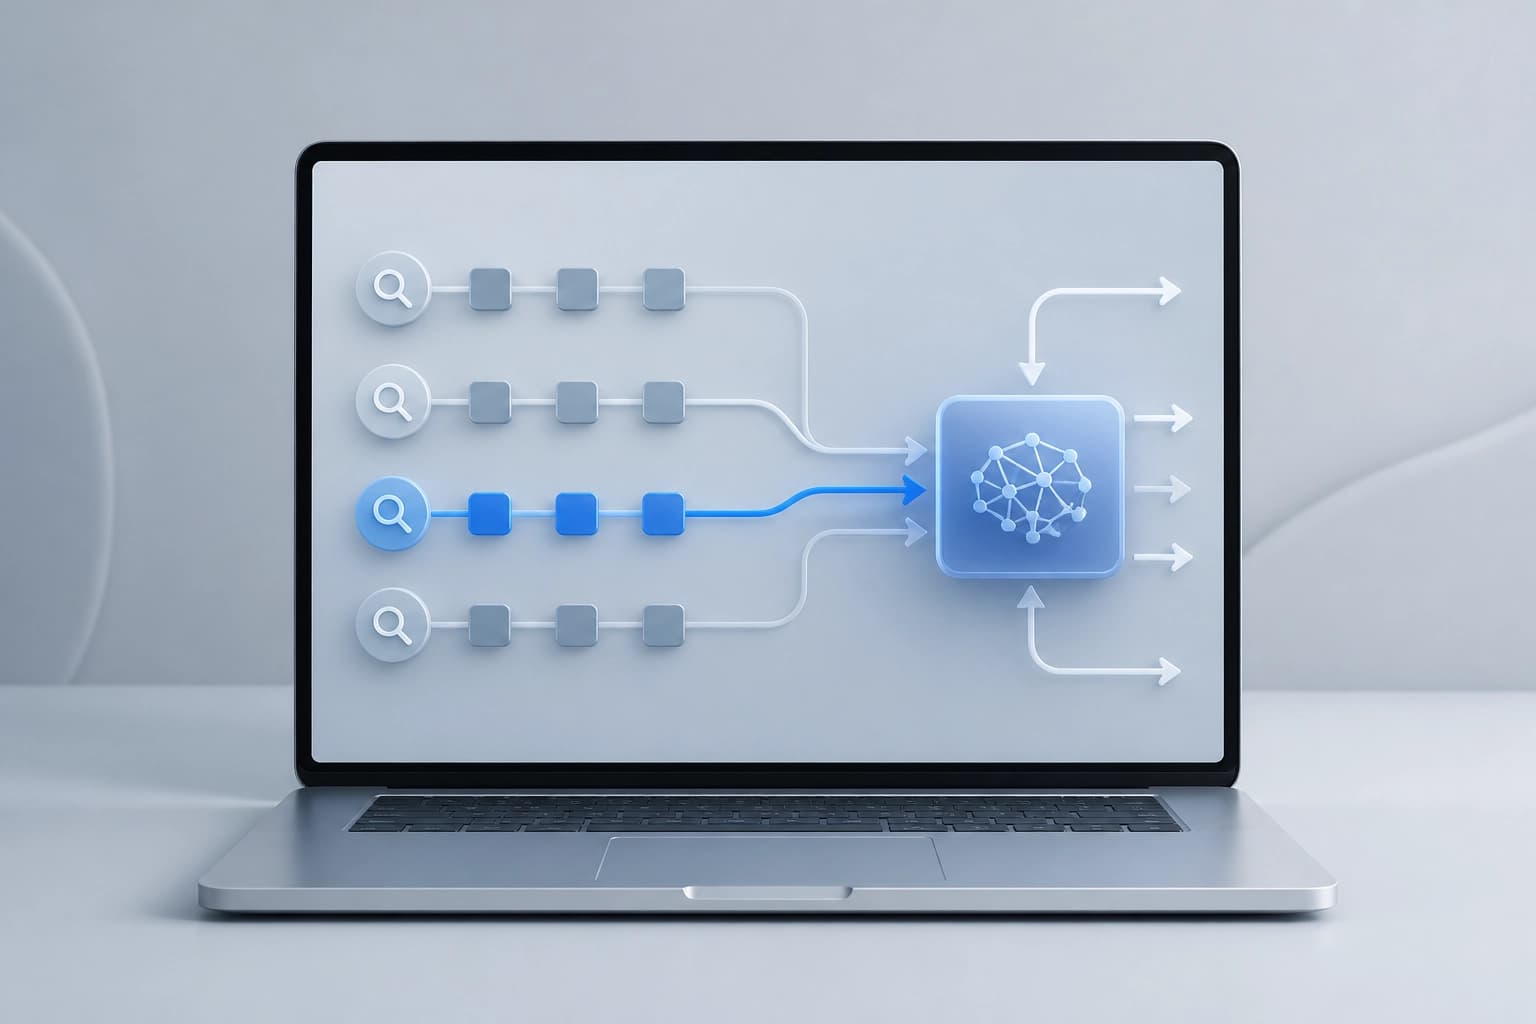
No SpecEvo, o processo baseia-se em atribuir a pesquisa habitual e a síntese de evidências a modelos de baixo custo. Os modelos de ponta são ativados para intervenções estratégicas. Os seus benefícios estendem-se a muitas avaliações subsequentes de baixo custo.
Etapas:
- Os modelos leves conduzem a pesquisa habitual de programas candidatos.
- Advisor sintetiza as informações acumuladas sobre sucessos, falhas e direções saturadas.
- Navigator estuda a população numa etapa de controlo pouco frequente e escolhe uma intervenção.
- A intervenção depende da estagnação da pesquisa e pode consistir em síntese, aperfeiçoamento direcionado ou mudança do enquadramento.
- Os modelos de baixo custo continuam as avaliações tendo em conta as recomendações permanentes.
Critério prático: o esquema é adequado se a pesquisa permitir pontos de controlo pouco frequentes e a acumulação de recomendações entre eles.
Resultados e comparação com métodos de base
Os autores testaram o SpecEvo em 176 tarefas de quatro áreas de descoberta científica e algorítmica. A estrutura apresentou resultados ao nível dos métodos de base assentes em modelos de ponta ou superiores. Ao mesmo tempo, reduziu os custos da API até 80%. Na pesquisa de equações, a estrutura apresentou uma eficiência de avaliação até 1,5× superior à dos métodos de base económicos. A estrutura superou o método de base mais forte, CO-Bench, em 3,8%.
| Indicador | Resultado | | Comparação com métodos de base assentes em modelos de ponta | igualou ou superou | | Redução dos custos da API | até 80% | | Eficiência de avaliação na pesquisa de equações | até 1,5× superior à dos métodos de base económicos | | Vantagem sobre o CO-Bench | 3,8% |
Critério prático de seleção: comparar a qualidade da pesquisa e os custos da API com os métodos de base nas próprias tarefas. Os autores concluem que a coordenação de modelos tendo em conta a trajetória da pesquisa é uma abordagem eficaz para descobertas científicas económicas.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais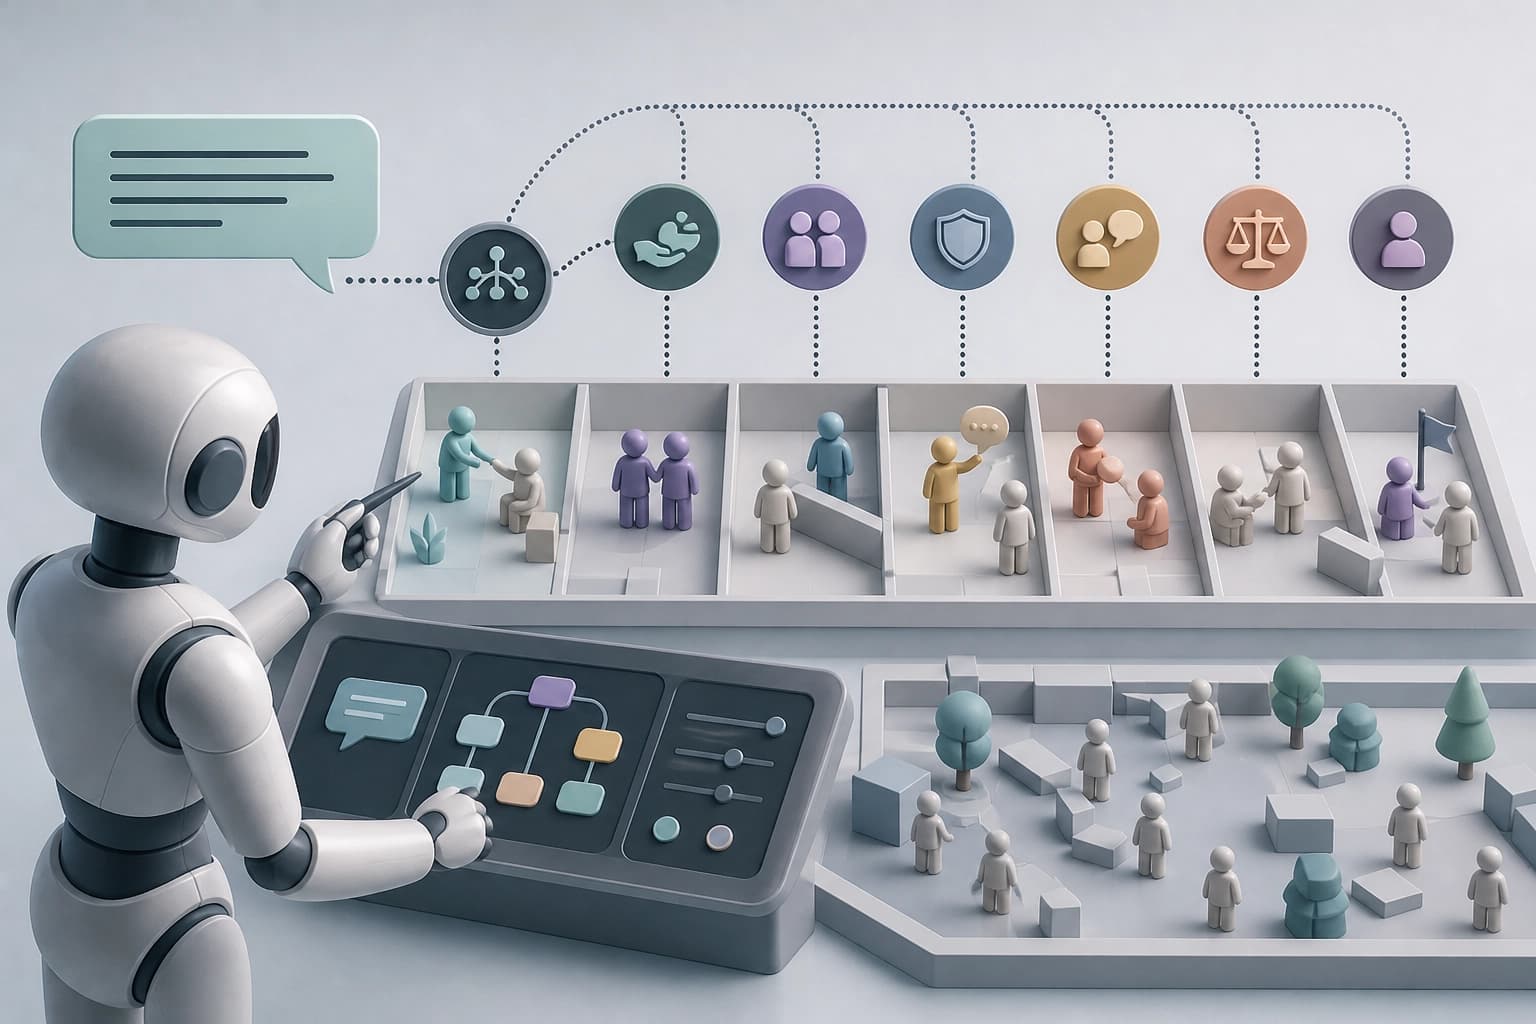
Fig: intervenções em jogos controladas para testar o comportamento social de agentes de IA
Fig recebe uma descrição em linguagem natural do comportamento pretendido, divide-o em variantes e altera deliberadamente as condições do jogo para induzir as ações desejadas nos modelos. Em cenários válidos para seis padrões sociais, as intervenções aumentaram em 10,9% a proporção média de tentativas do comportamento-alvo em relação aos grupos de controlo, e os autores propõem considerar ambientes multiagente como uma plataforma configurável para avaliação reprodutível.
21 novembro 2026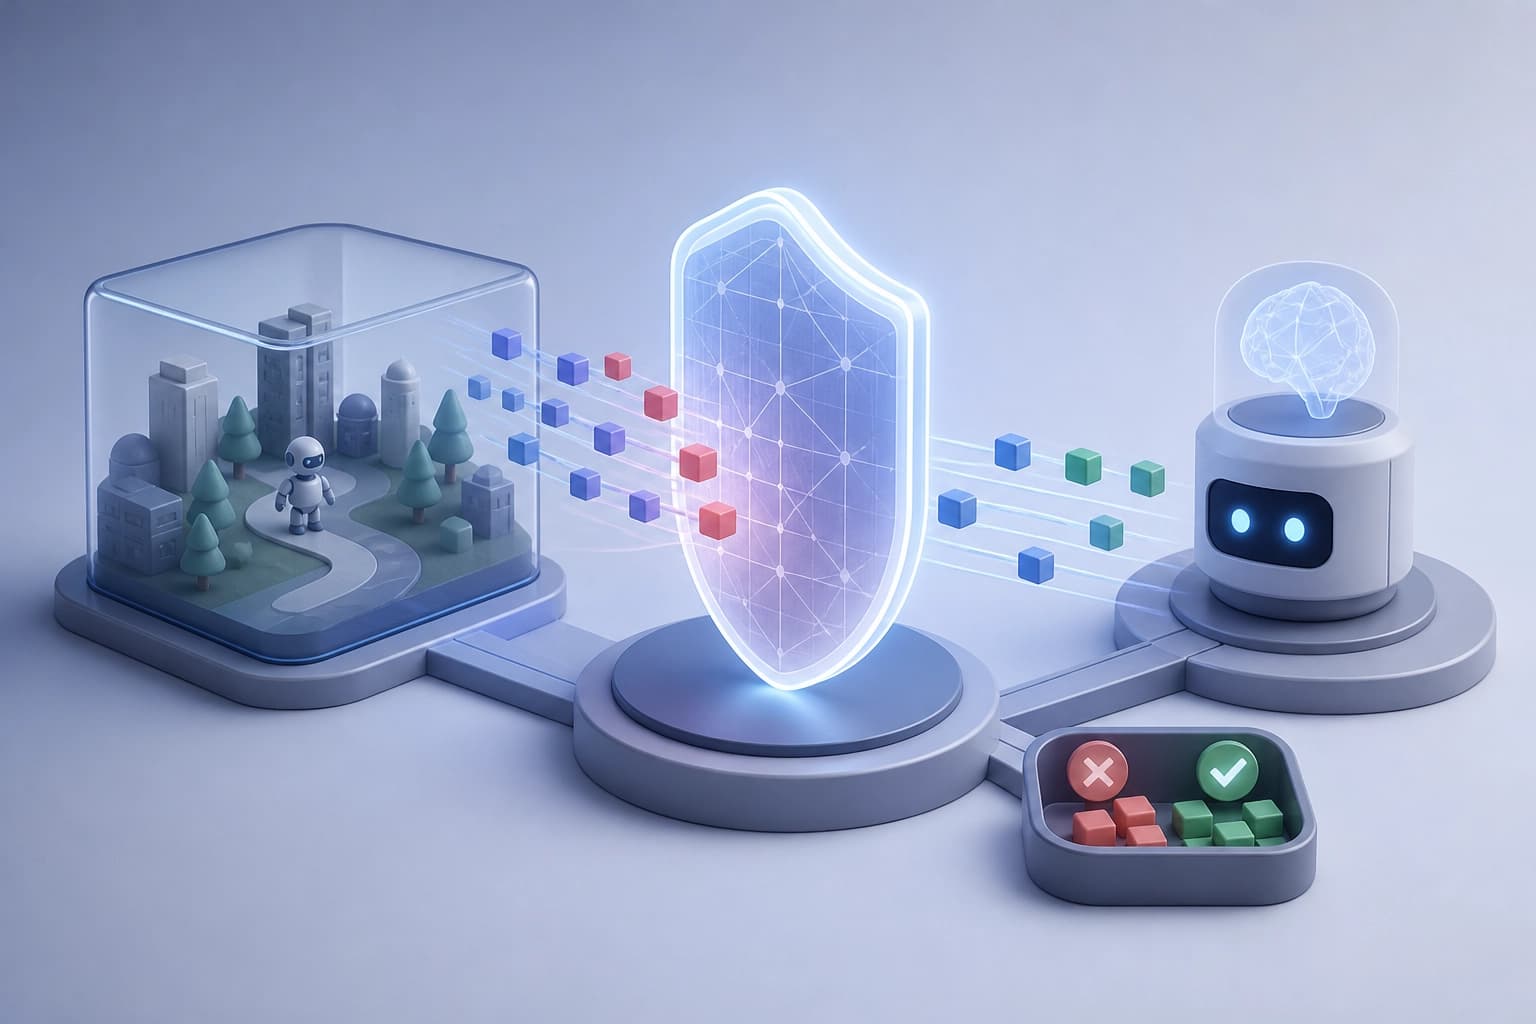
Verificação de políticas de agentes sem depender de prompts: ambientes executáveis, conjuntos de testes e um filtro treinável
O trabalho propõe um framework que transforma ambientes de execução em conjuntos de cenários para testar políticas de agentes e permite melhorar iterativamente o componente de proteção. O filtro treinado reduz a taxa de violações bem-sucedidas em 40–44% em relação à abordagem baseada apenas em instruções no prompt e rejeita incorretamente pedidos seguros com menos frequência.
20 novembro 2026
PerMIT: integridade da memória de longo prazo de agentes de LLM e confiança coletiva com verificação por máquina
Os autores propõem a arquitetura PerMIT, que limita a entrada de dados não confiáveis do ambiente em ações sensíveis do agente por meio de uma interface de memória finita; dois teoremas, verificados em Lean 4, e o acúmulo de veredictos da comunidade reduzem o risco de envenenamento sem aumentar a carga para cada usuário. Nos experimentos com Trojan Hippo e τ²-bench, o sistema não registrou injeções bem-sucedidas com verificadores leves e melhorou os resultados de novos agentes em tarefas não vistas durante o treinamento.
20 novembro 2026