
PerMIT: integridade da memória de longo prazo de agentes de LLM e confiança coletiva com verificação por máquina
Os autores propõem a arquitetura PerMIT, que limita a entrada de dados não confiáveis do ambiente em ações sensíveis do agente por meio de uma interface de memória finita; dois teoremas, verificados em Lean 4, e o acúmulo de veredictos da comunidade reduzem o risco de envenenamento sem aumentar a carga para cada usuário. Nos experimentos com Trojan Hippo e τ²-bench, o sistema não registrou injeções bem-sucedidas com verificadores leves e melhorou os resultados de novos agentes em tarefas não vistas durante o treinamento.
PerMIT — uma arquitetura de memória para agentes LLM. Artigo de Tanqiu Jiang, Min Bai, Sadat Shahriar, Wanyu Du e Sandesh Swamy, submetido em 20 de outubro de 2026; arXiv:2610.28987.
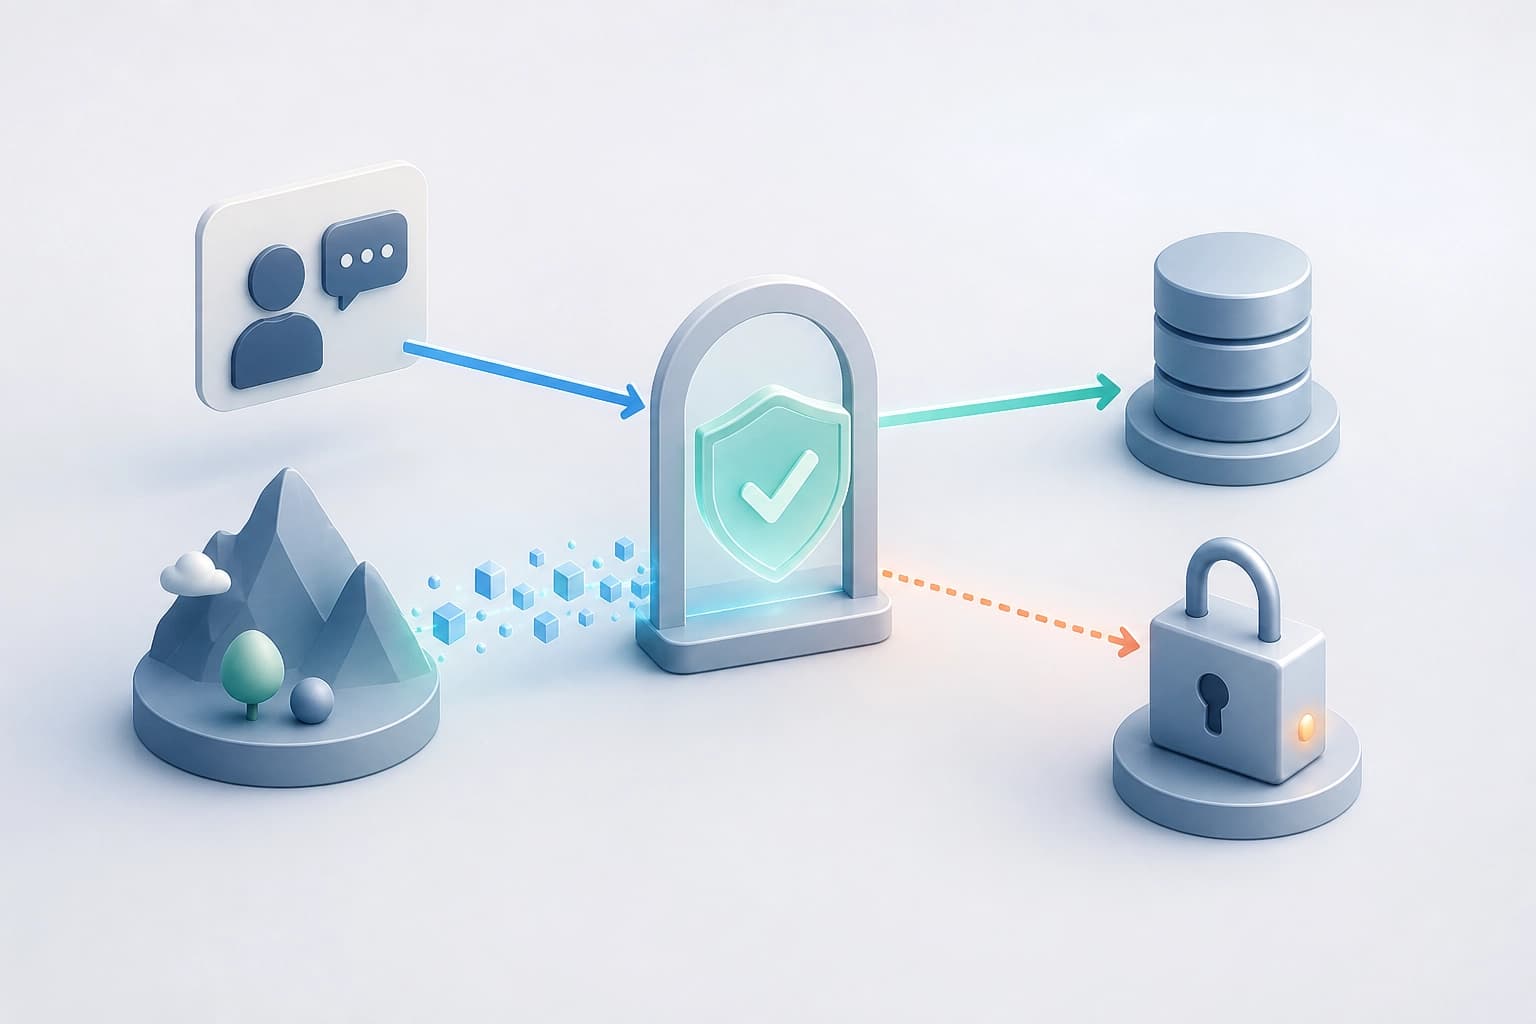
Modelo de confiança
PerMIT define uma hipótese de confiança explícita. Apenas os dados introduzidos pelo utilizador e os valores aprovados no gate são considerados confiáveis. Todos os valores provenientes do ambiente permanecem não confiáveis. A arquitetura regula a sua transferência e utilização através de uma interface de memória finita. O planeamento do agente em várias etapas e a seleção de ferramentas são preservados.
Critério prático: o cenário é adequado se os dados introduzidos pelo utilizador forem considerados confiáveis e os dados do ambiente não forem.
Gate e decisões verificáveis
A interface de memória finita assenta num gate. Os autores provam dois teoremas de integridade para a interface. Os teoremas são verificados por máquina em Lean 4. Em conjunto, garantem duas propriedades. A memória proveniente do ambiente só chega a uma ação sensível depois de ser aprovada no gate. O comportamento do agente só muda através do que o gate apresenta.
No âmbito do modelo de ameaças, cada ataque resume-se a uma única decisão verificável. Na prática, a decisão é tomada por uma pessoa, um verificador LLM ou ambos.
Critério prático: a proteção é aplicável no âmbito de um modelo de ameaças em que um ataque se resume a uma única decisão verificável.
Confirmações e confiança coletiva
Cada confirmação é um veredicto registado sobre um conteúdo exato. As confirmações acumulam-se entre utilizadores. Os elementos com apoio suficiente são confirmados pela comunidade sem necessidade de verificações adicionais.
Sob hipóteses explícitas, os autores provam uma propriedade de escalabilidade conjunta. Também a confirmam através de uma simulação. À medida que a comunidade cresce, diminuem os riscos de promoção de dados envenenados e de remoção indevida de conhecimento válido. O esforço de verificação de cada utilizador não aumenta.
| O que muda à medida que a comunidade cresce | Tendência |
|---|---|
| Risco de promoção de dados envenenados | Diminui |
| Risco de remoção indevida de conhecimento válido | Diminui |
| Esforço de verificação de cada utilizador | Não aumenta |
Critério prático: uma camada coletiva é adequada quando os veredictos estão associados a conteúdos exatos e se acumulam entre utilizadores.
Testes
No Trojan Hippo, PerMIT apresentou zero sucesso de ataques observável. O resultado foi obtido através de autoverificação e da utilização de verificadores leves.
No τ²-bench, comunidades com até 90 agentes autónomos criam bases de conhecimento partilhadas com PerMIT. Nenhuma injeção direta na memória foi promovida. O conhecimento obtido melhora significativamente os resultados de novos agentes em tarefas retidas para avaliação.
Critério prático — dois resultados: nenhuma promoção de injeções diretas e melhoria dos novos agentes em tarefas retidas para avaliação.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Sistema composto de IA multiagente com ciclo de evidências para o planejamento de prótons em tumores de cabeça e pescoço
O trabalho descreve a combinação de uma política PPO treinada, que gera várias opções de plano, e de agentes LLM que conduzem um diálogo de refinamento com verificação de métricas clínicas e restrições; com base em 21 pacientes, a Qwen3-14B ajustada seguiu melhor as instruções e ajudou a deslocar a relação de compromisso a favor dos objetivos prioritários. A conclusão prática é que o planeamento DRL automatizado pode ser complementado por um diálogo orientado, mantendo o controlo sobre restrições concorrentes.
20 novembro 2026
Seleção computacional em vez de tentativa e erro empírica: novas abordagens aos materiais para baterias
O material mostra como bases de cálculo, aprendizagem automática e modelos generativos reduzem o leque de composições promissoras, enquanto laboratórios automatizados aceleram a sua validação; ainda assim, o resultado depende da síntese e dos ensaios, nos quais as previsões podem divergir da condutividade real.
20 novembro 2026
A evolução dos benchmarks de agentes com o aumento do conjunto de tarefas: o papel da seleção de evidências e das corridas sequenciais
O trabalho explica por que aumentar o número de tarefas pode prejudicar a evolução de ambientes de agentes: a causa é a seleção inadequada de evidências, e não o volume de dados em si. O método Successive Scale Racing seleciona, de forma alternada, combinações diversificadas de tarefas e compara os candidatos a baixo custo; em três benchmarks, isso aumentou a taxa de execuções bem-sucedidas quando o conjunto cresceu de 40 para 200 tarefas, enquanto os métodos de referência tiveram desempenho pior, e o número de execuções de validação caiu cerca de 60%.
19 novembro 2026