
Verificação de políticas de agentes sem depender de prompts: ambientes executáveis, conjuntos de testes e um filtro treinável
O trabalho propõe um framework que transforma ambientes de execução em conjuntos de cenários para testar políticas de agentes e permite melhorar iterativamente o componente de proteção. O filtro treinado reduz a taxa de violações bem-sucedidas em 40–44% em relação à abordagem baseada apenas em instruções no prompt e rejeita incorretamente pedidos seguros com menos frequência.
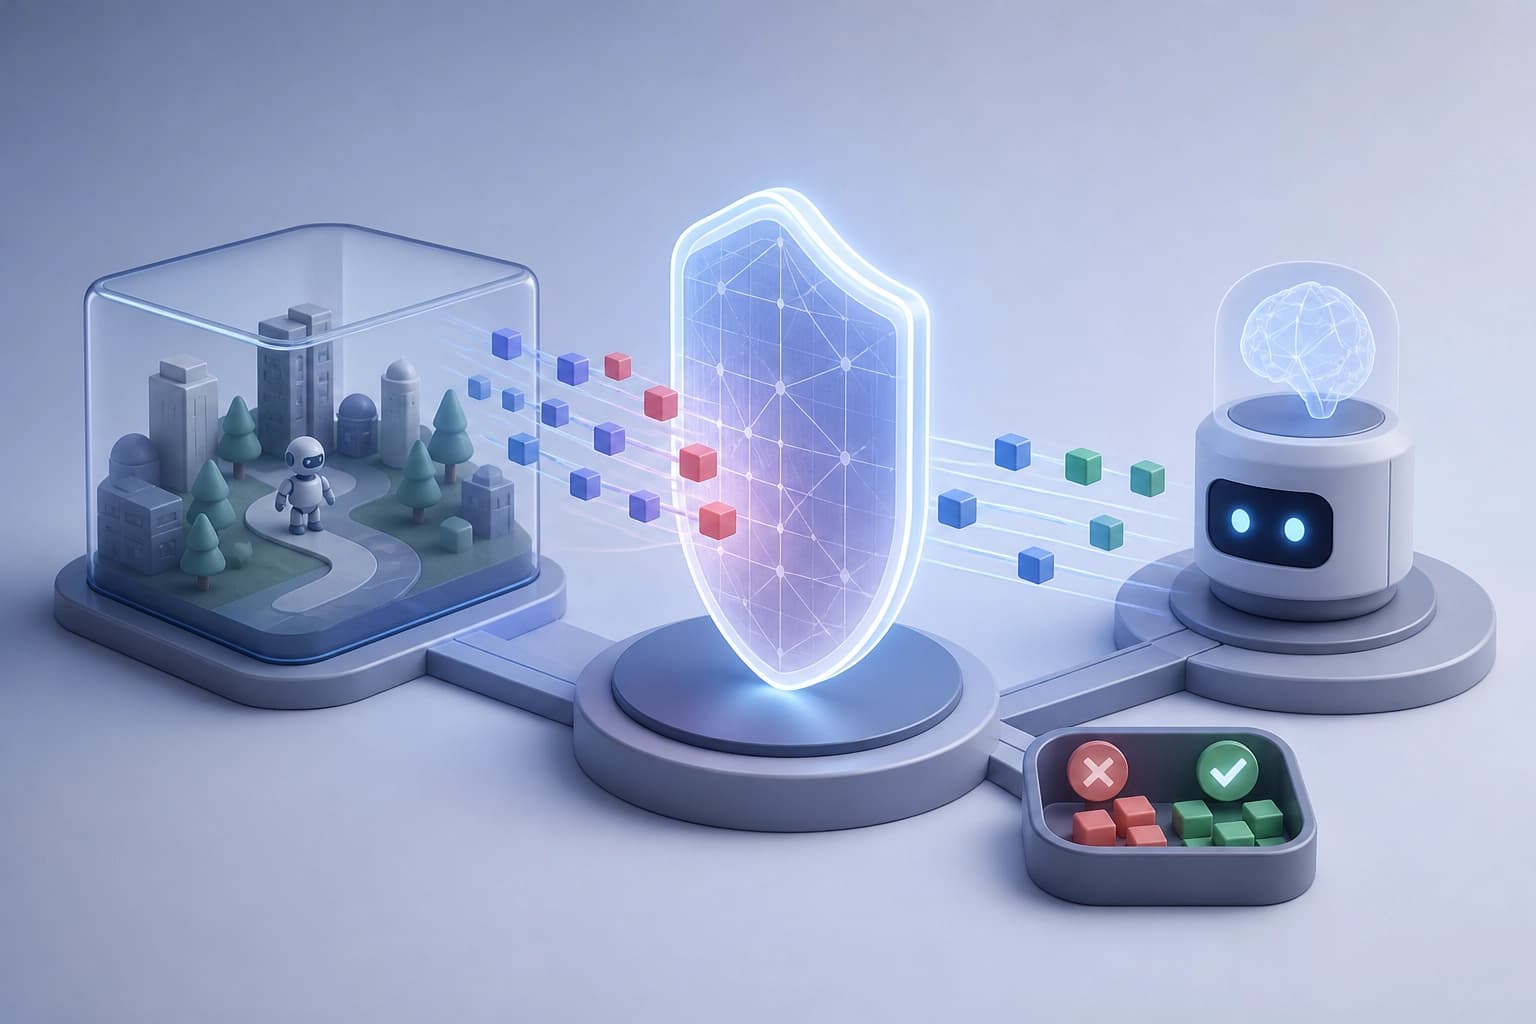
Limite do prompt: porque as instruções não são suficientes
Em implementações personalizadas de agentes, as políticas definem regras para ferramentas, recursos e condições de execução. Incluir essas regras no prompt não garante que as violações sejam impedidas de forma fiável. O prompt define o texto, mas não verifica a chamada efetiva. Em todos os casos de violação, é utilizada uma ferramenta permitida. Portanto, é preciso verificar os argumentos, os recursos e o contexto, e não apenas o nome da ferramenta.
Para treinar um mecanismo de proteção, são necessários exemplos de chamadas que estejam em conformidade com a política e exemplos que a violem. Sem esses pares, a verificação baseia-se no texto das regras, e não no comportamento observado.
Critério prático: considerar o prompt apenas como veículo das regras. Basear a verificação nos dados das chamadas e nos respetivos resultados.
Ambiente de execução: verificação da chamada efetiva
O AgentPolicyForge utiliza ambientes de execução para criar testes de referência de políticas e treinar mecanismos de proteção de forma iterativa. O ambiente executa chamadas a ferramentas e regista os resultados. A conformidade com a política é determinada com base nesses resultados. Isto é diferente de ler o prompt: a verificação é feita com base na execução efetiva.
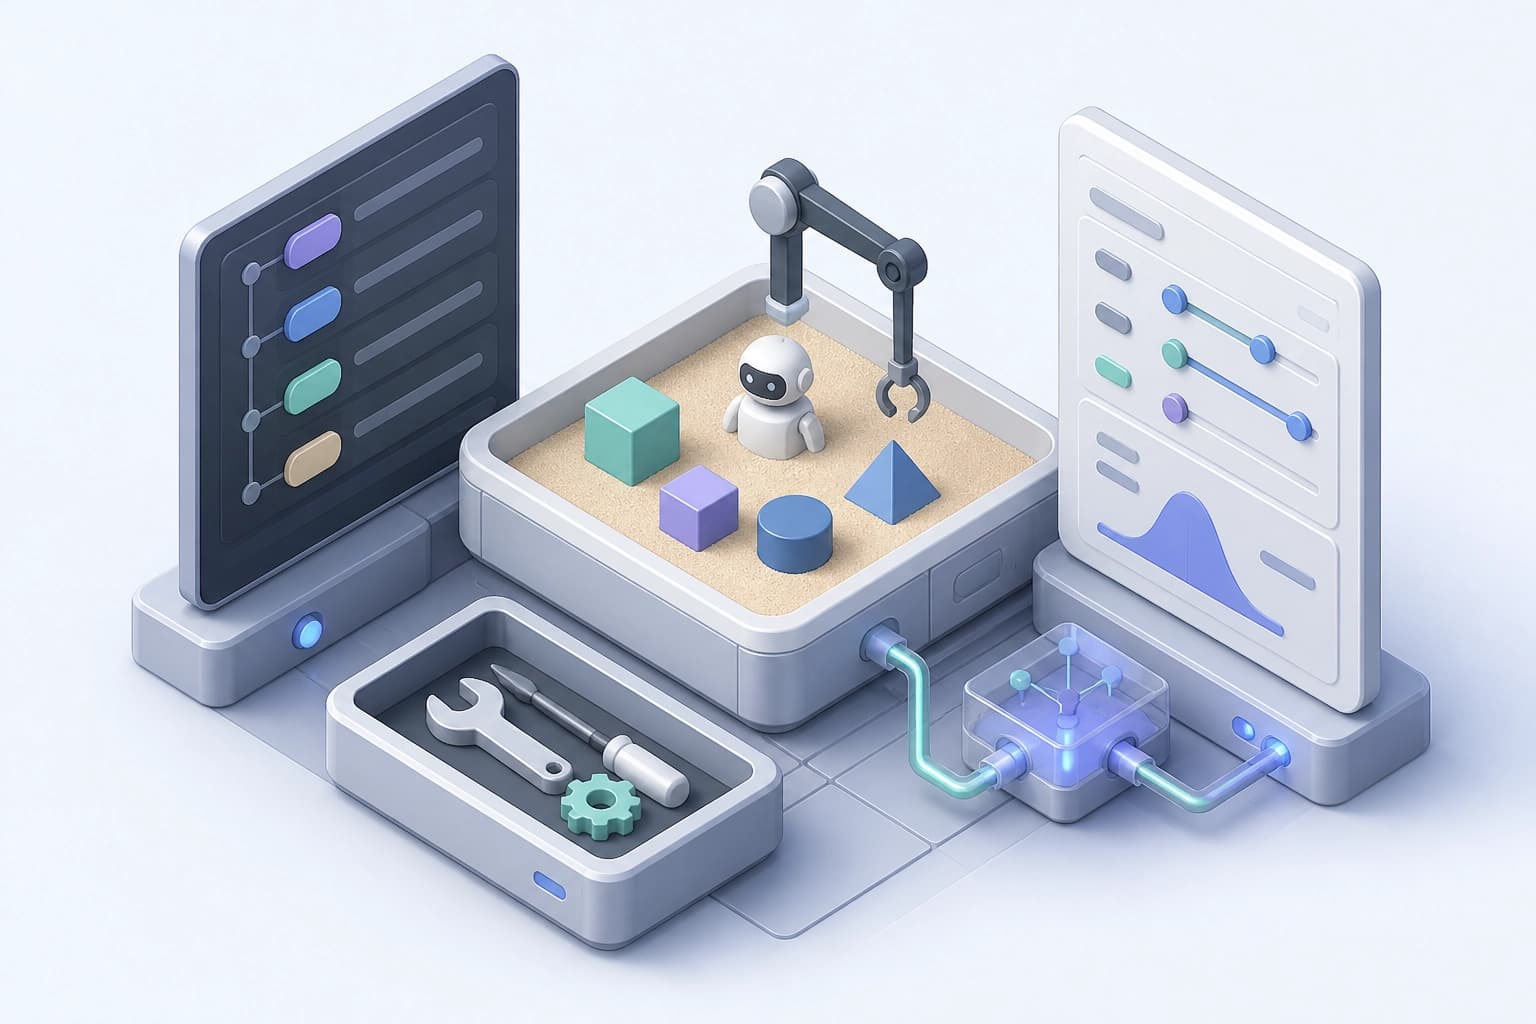
Elementos-chave da verificação:
- execução da chamada num ambiente;
- registo do resultado da chamada;
- comparação dos argumentos, dos recursos e do contexto com a política;
- utilização de uma ferramenta permitida nos exemplos de violação.
Conclusão: o teste de referência tem de ser executável. O critério para escolher um ambiente é a capacidade de guardar os resultados e de verificar os argumentos, os recursos e o contexto.
PolicyGym: cenários de treino e testes reservados
Com base na framework, foi criado o PolicyGym — um conjunto de dados que abrange dez famílias de políticas. Inclui 698 cenários para gerar dados de treino. Além disso, estão previstos 254 cenários reservados para conjuntos de teste.
| Parte do conjunto | Finalidade | Volume |
|---|---|---|
| Cenários para gerar dados de treino | Preparação de exemplos de treino | 698 |
| Cenários reservados | Conjuntos de teste | 254 |
Os cenários reservados foram verificados por pessoas. Critério prático: manter separados os cenários de treino e os cenários reservados. O conjunto de teste tem de ser independente da geração de dados de treino.
Filtro treinado em comparação com a autorregulação do agente
O PolicyGym compara duas abordagens: a autorregulação do agente tendo em conta a política e um mecanismo de proteção treinado. A configuração final com o mecanismo de proteção reduz em termos relativos a percentagem de ataques bem-sucedidos em 40–44%. Também resulta em menos recusas incorretas de pedidos inofensivos do que a aplicação exclusiva das políticas no prompt.
| Configuração | O que utiliza | Resultado observado |
|---|---|---|
| Apenas políticas no prompt | Texto das políticas | Referência para comparação |
| Configuração final com mecanismo de proteção | Filtro treinado | Redução de ataques bem-sucedidos em 40–44%; menos recusas incorretas |
Critério prático: comparar o mecanismo de proteção com a referência baseada no prompt. Analisar tanto os ataques bem-sucedidos como as recusas incorretas.
Ciclo iterativo: ataque, ajuste fino, atualização do arquivo
O processo de criação de exemplos permite treinar o mecanismo de proteção de forma iterativa. O atacante gera pedidos recorrendo a estratégias extraídas. O mecanismo de proteção é ajustado com exemplos equilibrados e verificados no ambiente. O treino melhora a eficácia da aplicação das políticas, mesmo com um arquivo fixo.
A atualização do arquivo proporciona um efeito adicional. Reduz a taxa de sucesso dos ataques dentro do domínio em comparação com a manutenção do arquivo sem alterações.
Etapas do ciclo:
- Extrair estratégias de ataque.
- Gerar pedidos para o atacante.
- Verificar os exemplos num ambiente de execução.
- Equilibrar os exemplos e ajustar o mecanismo de proteção.
- Atualizar o arquivo de ataques.
Critério prático: prever um ciclo de atualização do arquivo e a verificação dos exemplos no ambiente. Um arquivo fixo já proporciona um efeito de treino. A atualização reduz ainda mais a taxa de sucesso dos ataques dentro do domínio.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
PerMIT: integridade da memória de longo prazo de agentes de LLM e confiança coletiva com verificação por máquina
Os autores propõem a arquitetura PerMIT, que limita a entrada de dados não confiáveis do ambiente em ações sensíveis do agente por meio de uma interface de memória finita; dois teoremas, verificados em Lean 4, e o acúmulo de veredictos da comunidade reduzem o risco de envenenamento sem aumentar a carga para cada usuário. Nos experimentos com Trojan Hippo e τ²-bench, o sistema não registrou injeções bem-sucedidas com verificadores leves e melhorou os resultados de novos agentes em tarefas não vistas durante o treinamento.
20 novembro 2026
Sistema composto de IA multiagente com ciclo de evidências para o planejamento de prótons em tumores de cabeça e pescoço
O trabalho descreve a combinação de uma política PPO treinada, que gera várias opções de plano, e de agentes LLM que conduzem um diálogo de refinamento com verificação de métricas clínicas e restrições; com base em 21 pacientes, a Qwen3-14B ajustada seguiu melhor as instruções e ajudou a deslocar a relação de compromisso a favor dos objetivos prioritários. A conclusão prática é que o planeamento DRL automatizado pode ser complementado por um diálogo orientado, mantendo o controlo sobre restrições concorrentes.
20 novembro 2026
Seleção computacional em vez de tentativa e erro empírica: novas abordagens aos materiais para baterias
O material mostra como bases de cálculo, aprendizagem automática e modelos generativos reduzem o leque de composições promissoras, enquanto laboratórios automatizados aceleram a sua validação; ainda assim, o resultado depende da síntese e dos ensaios, nos quais as previsões podem divergir da condutividade real.
20 novembro 2026