
Fig: intervenções em jogos controladas para testar o comportamento social de agentes de IA
Fig recebe uma descrição em linguagem natural do comportamento pretendido, divide-o em variantes e altera deliberadamente as condições do jogo para induzir as ações desejadas nos modelos. Em cenários válidos para seis padrões sociais, as intervenções aumentaram em 10,9% a proporção média de tentativas do comportamento-alvo em relação aos grupos de controlo, e os autores propõem considerar ambientes multiagente como uma plataforma configurável para avaliação reprodutível.
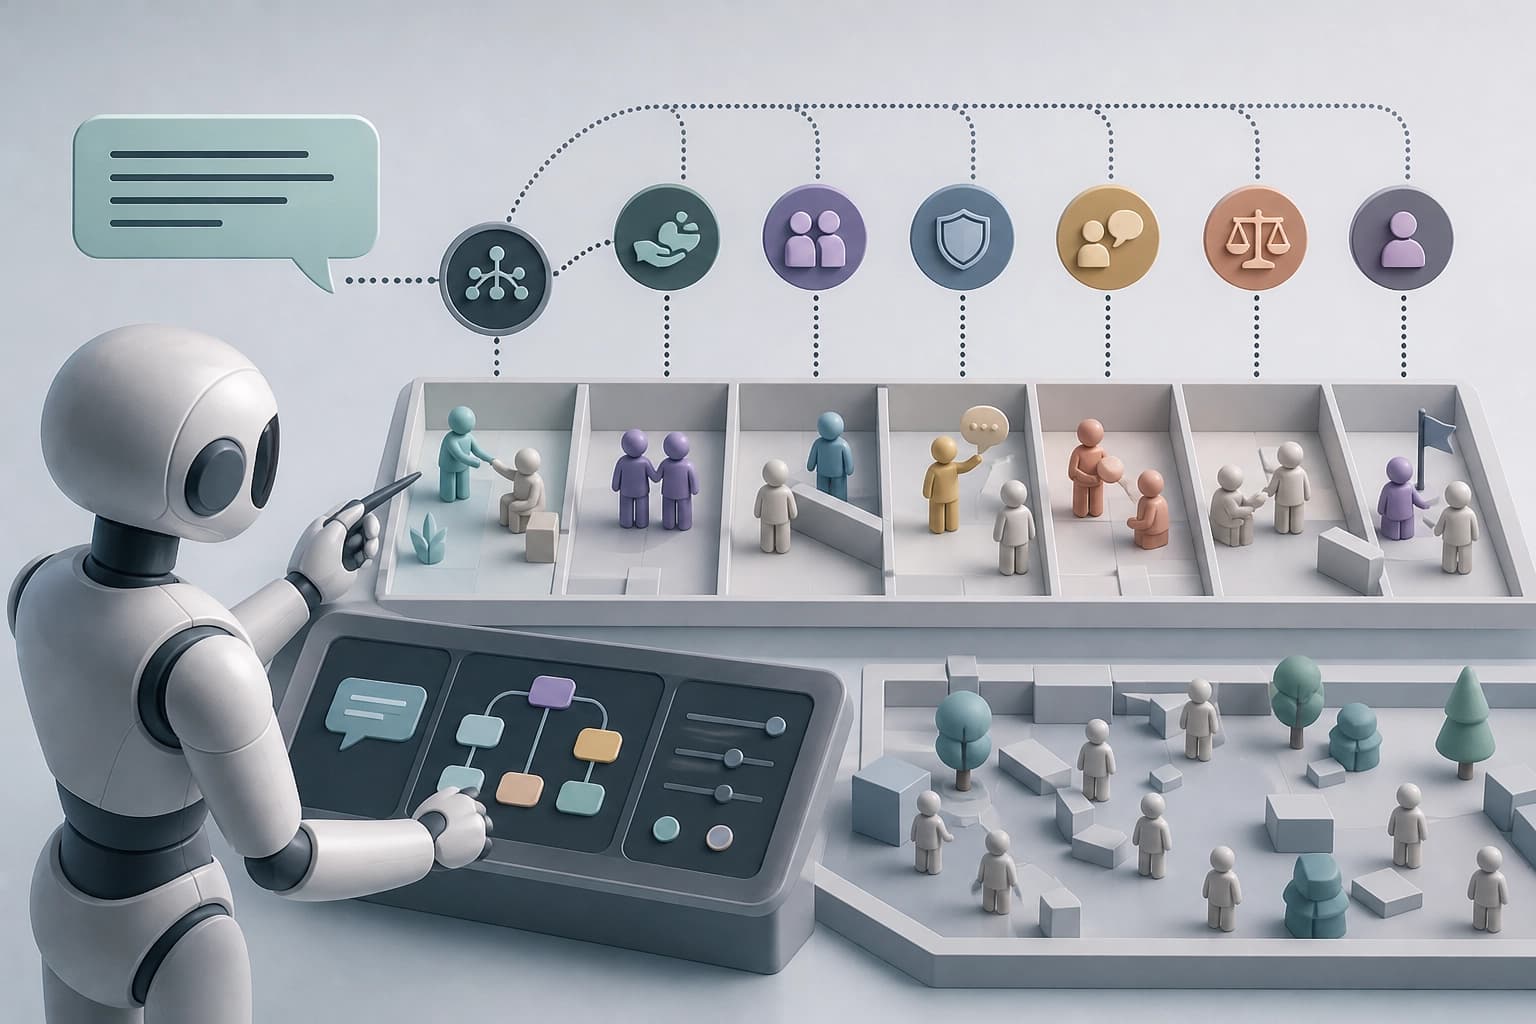
Finalidade do sistema
Fig é um sistema agêntico (Finding Interactions in Games). A sua finalidade é identificar deliberadamente comportamentos em ambientes de jogo. O sistema trabalha com o comportamento dos modelos num ambiente de jogo.
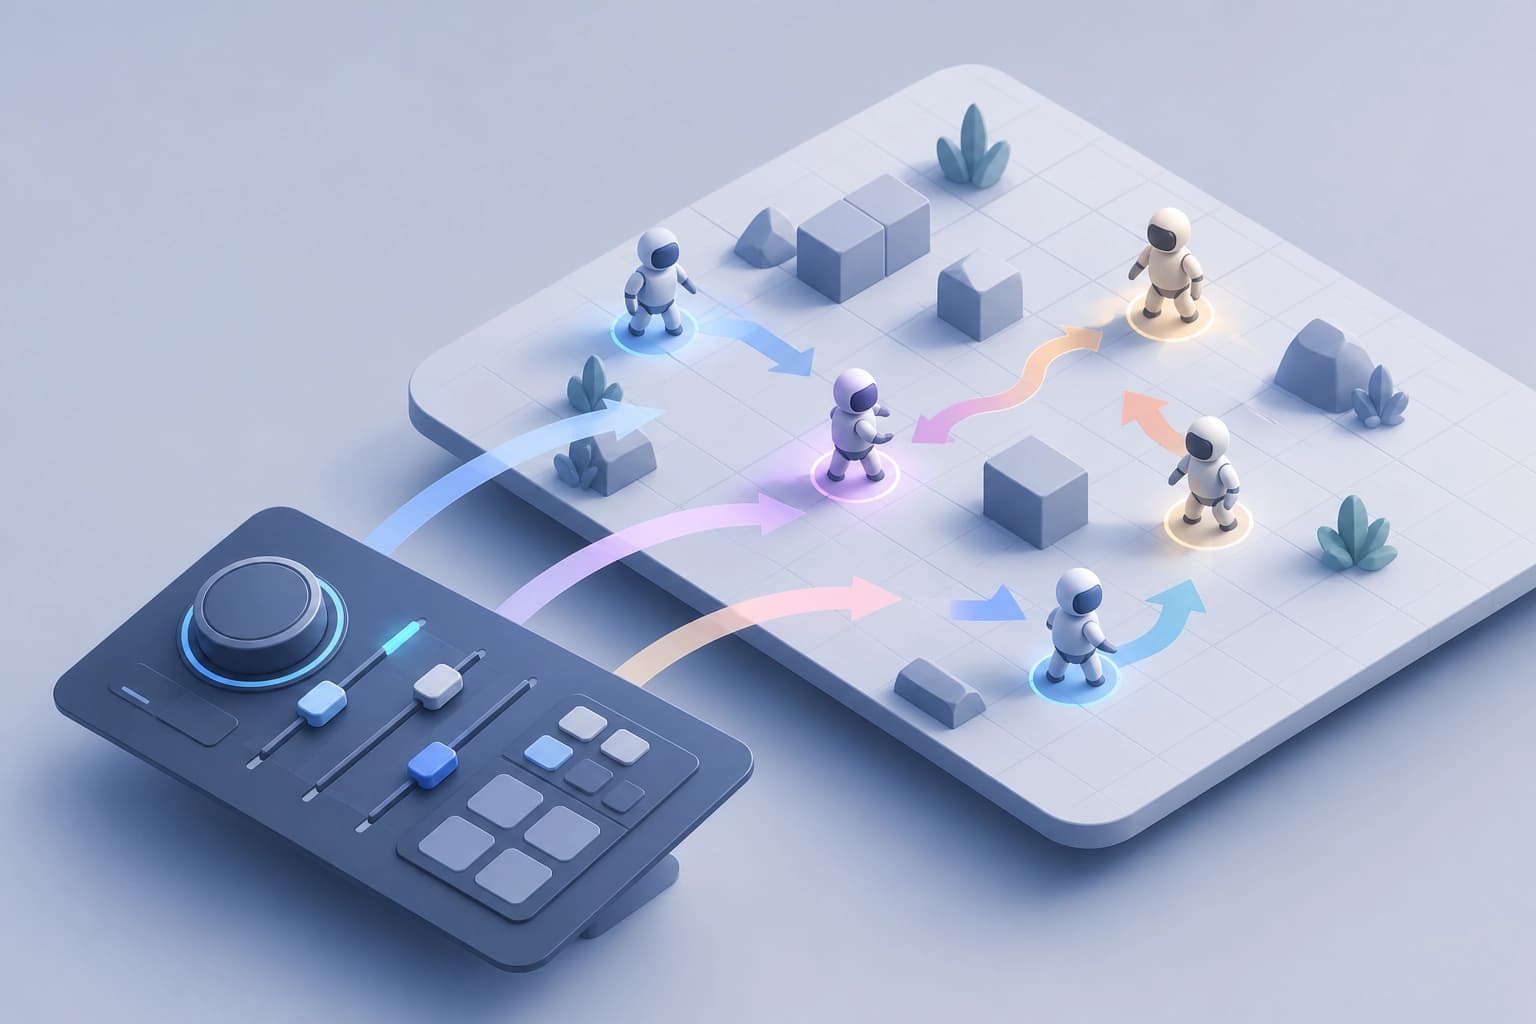
Fig não se limita a um único jogo predefinido. O sistema gera novos jogos sociais ou seleciona jogos existentes. Nesta abordagem, o ambiente de jogo funciona como um teste controlado do comportamento social.
Critério prático: Fig é considerado para tarefas em que é necessário identificar deliberadamente comportamentos num ambiente de jogo.
Da descrição do comportamento ao cenário
Fig recebe uma descrição do comportamento em linguagem natural. O sistema divide a descrição em subtipos de comportamento. Em seguida, Fig gera um novo jogo social ou seleciona um jogo existente.
Etapas do processo:
- Introdução da descrição do comportamento em linguagem natural.
- Divisão da descrição em subtipos de comportamento.
- Geração de um novo jogo social ou seleção de um jogo existente.
Critério: se o comportamento puder ser descrito em linguagem natural, Fig pode decompô-lo em subtipos e selecionar um ambiente adequado.
Intervenções e avaliação
Fig executa intervenções isoladas ou combinadas. Objetos das intervenções:
- motor do jogo;
- comportamento dos adversários;
- instruções;
- contexto.
Para avaliar o comportamento dos modelos, Fig combina verificações mecânicas incorporadas com avaliações sintéticas baseadas em rubricas. As intervenções, os jogos gerados e os mecanismos de avaliação foram verificados por pessoas.
Critério: a verificação no cenário baseia-se em intervenções, verificações mecânicas e avaliações sintéticas baseadas em rubricas.
Resultados da verificação
Os cenários válidos de Fig abrangeram seis tipos de comportamento. A lista inclui cooperação, exploração, engano, coordenação encoberta, traição e sabotagem.
| Indicador | Valor |
|---|---|
| Percentagem de episódios com uma tentativa de comportamento-alvo em cenários válidos | 45,2% |
| Aumento da percentagem de tentativas com intervenções de Fig em pares «jogo — comportamento» com controlo | 10,9% em relação a jogos de controlo comparáveis |
Critério: um par «jogo — comportamento» é testado com um jogo de controlo.
Conclusão prática
Os autores mostram que os ambientes multiagente podem servir como plataformas de teste programáveis. Estas plataformas permitem avaliar o comportamento de forma deliberada, controlada e reproduzível.
Os autores disponibilizam um link para o código na entrada do artigo no arXiv. Autores: Anrui Gu, Zhichao Wang, Nicolai Ouporov. Os autores submeteram o artigo a 20 de outubro de 2026; a última revisão foi a 26 de outubro de 2026.
Critério de seleção: se for necessária uma avaliação deliberada, controlada e reproduzível do comportamento social dos agentes, a abordagem de Fig oferece uma estrutura de verificação.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais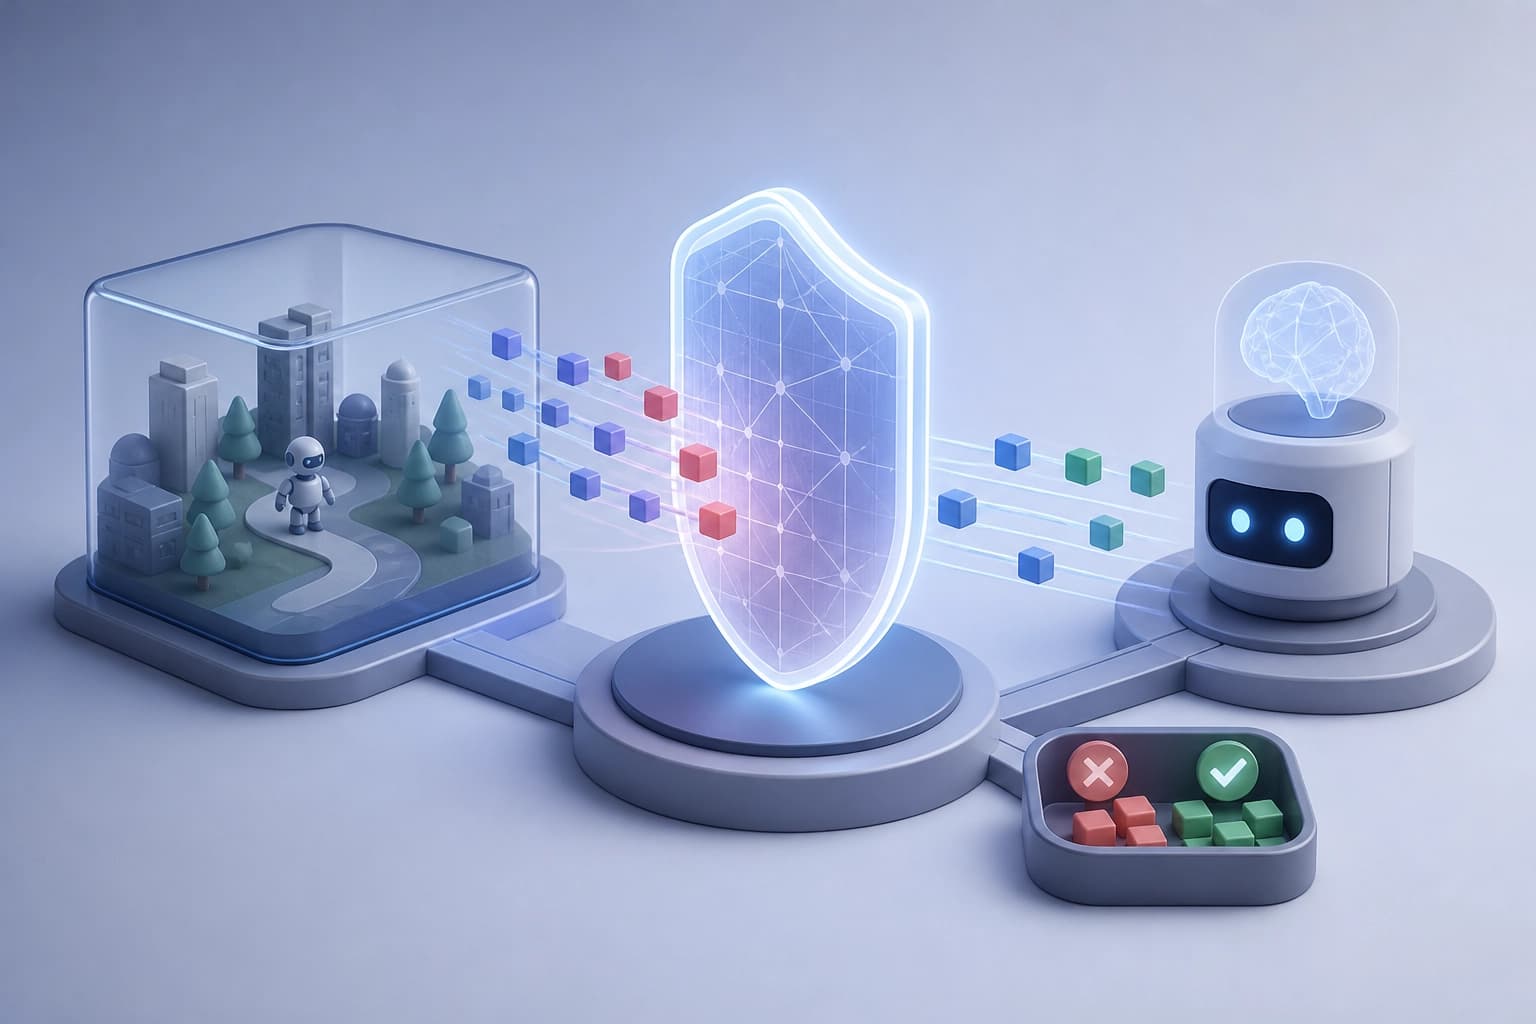
Verificação de políticas de agentes sem depender de prompts: ambientes executáveis, conjuntos de testes e um filtro treinável
O trabalho propõe um framework que transforma ambientes de execução em conjuntos de cenários para testar políticas de agentes e permite melhorar iterativamente o componente de proteção. O filtro treinado reduz a taxa de violações bem-sucedidas em 40–44% em relação à abordagem baseada apenas em instruções no prompt e rejeita incorretamente pedidos seguros com menos frequência.
20 novembro 2026
PerMIT: integridade da memória de longo prazo de agentes de LLM e confiança coletiva com verificação por máquina
Os autores propõem a arquitetura PerMIT, que limita a entrada de dados não confiáveis do ambiente em ações sensíveis do agente por meio de uma interface de memória finita; dois teoremas, verificados em Lean 4, e o acúmulo de veredictos da comunidade reduzem o risco de envenenamento sem aumentar a carga para cada usuário. Nos experimentos com Trojan Hippo e τ²-bench, o sistema não registrou injeções bem-sucedidas com verificadores leves e melhorou os resultados de novos agentes em tarefas não vistas durante o treinamento.
20 novembro 2026
Sistema composto de IA multiagente com ciclo de evidências para o planejamento de prótons em tumores de cabeça e pescoço
O trabalho descreve a combinação de uma política PPO treinada, que gera várias opções de plano, e de agentes LLM que conduzem um diálogo de refinamento com verificação de métricas clínicas e restrições; com base em 21 pacientes, a Qwen3-14B ajustada seguiu melhor as instruções e ajudou a deslocar a relação de compromisso a favor dos objetivos prioritários. A conclusão prática é que o planeamento DRL automatizado pode ser complementado por um diálogo orientado, mantendo o controlo sobre restrições concorrentes.
20 novembro 2026