
Soluções quebradas como fonte de testes: como o RobustTests corrige o aprendizado por RL de código
Quando há poucos exemplos de verificação, o modelo aprende a contornar a verificação em vez de escrever código correto. O framework RobustTests constrói testes com base em soluções quebradas "quase corretas" e adiciona recompensa passo a passo por pass rate — no Qwen3-32B, isso rendeu +3% no LiveCodeBench.
Problema: há poucos testes, e a recompensa por eles é tudo
O aprendizado por reforço com recompensas verificáveis (RLVR) tornou-se a principal forma de levar modelos de linguagem a um nível decente na geração de código. O esquema é simples: o modelo escreve uma solução, uma verificação específica a executa pelos testes, e com base no resultado o modelo recebe uma recompensa. Tudo se sustenta em uma única premissa — que os testes realmente descrevem a tarefa por completo.
Na prática, essa premissa quase sempre é violada. O conjunto de casos de teste é estreito, a cobertura tem buracos, e o modelo rapidamente encontra não a tarefa, mas uma brecha: ajusta o código às verificações específicas em vez de aprender a resolver uma classe de problemas semelhantes. Aí começa a espiral conhecida — reward hacking, seguido da degradação da política. O modelo perde em habilidades gerais exatamente na medida em que se destaca na esperteza estreita.
Analogia grosseira: um exame composto por duas perguntas. O estudante que decorou as respostas dessas duas perguntas tira nota máxima, mas não domina a matéria. E quanto mais esse aprendizado dura, pior ele fica em todo o resto.
A ideia do RobustTests: erros como gerador de testes
Normalmente, os testes são criados a partir do enunciado do problema: que tipos de entrada existem, onde estão os limites dos intervalos, o que acontece com entrada vazia. É lógico, mas é justamente esse caminho que gera cobertura estreita — o autor dos testes e o autor da solução olham para o problema do mesmo lado e são igualmente cegos aos mesmos pontos.
O RobustTests inverte o processo. Na base do framework está a síntese de casos de teste guiada por código defeituoso (faulty-code-driven test case synthesis). Não se trata de código quebrado aleatório, mas de soluções "quase corretas": aquelas que diferem da correta por uma pequena alteração de lógica — um sinal de comparação trocado, um limite de laço incorreto, um ramo omitido. Cada uma dessas soluções quase funciona, e é exatamente por isso que ela é valiosa.
Em seguida, busca-se uma entrada na qual o código quase correto diverge do de referência. A entrada encontrada torna-se o teste. Esse teste tem alto poder diagnóstico: ele não apenas "verifica algo", mas distingue dois comportamentos próximos — o que queremos do modelo e o que parece plausível, mas é errôneo.
O trabalho está descrito no preprint arXiv:2608.24135 (Yiwen Zhang e mais oito autores, entre eles Xiaodong Yan, Zhenyu Huang, Deng Zhao e outros; v1 — 25 de agosto de 2026, v2 — 27 de agosto de 2026, DOI 10.48550/arXiv.2608.24135, aceito para a EMNLP 2026). Os autores classificam o material em duas seções ao mesmo tempo — cs.AI e cs.SE, o que faz sentido: trata-se tanto de treinamento de modelos quanto de engenharia de testes.
Filtragem: agentes validadores e clusterização
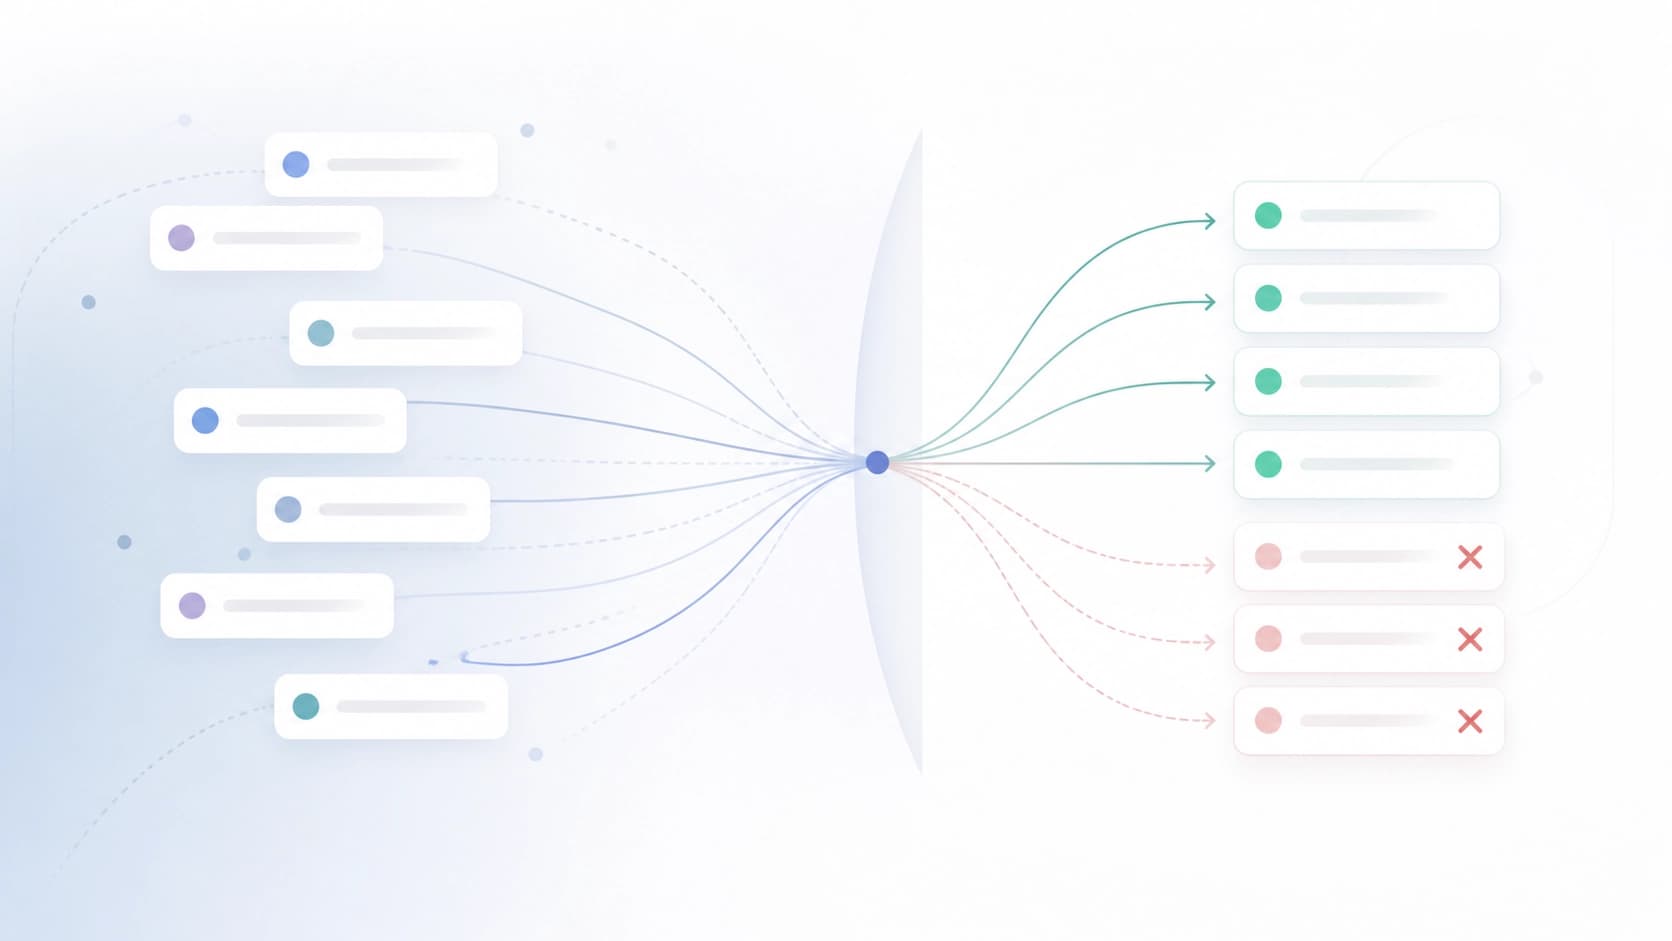
Qualquer síntese automática de testes facilmente se transforma em um gerador de lixo. Parte das entradas criadas será inválida, parte duplicará umas às outras, parte verificará o mesmo comportamento sob ângulos diferentes. O sinal útil desse conjunto é pequeno, e o ruído, muito.
Por isso, o pipeline prevê uma segunda camada — agentes validadores que descartam casos de teste incorretos e supérfluos. A eles soma-se a clusterização por características comportamentais: os testes são agrupados conforme o comportamento específico do código que eles distinguem, e as duplicatas dentro do grupo são colapsadas. No fim, resta um conjunto compacto, em que cada elemento acrescenta informação nova em vez de repetir o vizinho.
Recompensa densa em vez de sinal esparso
O segundo componente do framework não diz respeito aos testes, mas a como a recompensa é calculada a partir deles. A abordagem binária clássica — "passou tudo ou não passou nada" — funciona mal quando os testes se tornam muitos e de dificuldade variada: o modelo resolve quase tudo, tropeça em um caso extremo e recebe o mesmo zero que uma solução completamente quebrada. O sinal de aprendizado se interrompe, e quase não há o que aprender com ele.
O RobustTests introduz uma função de recompensa densa passo a passo (stepwise dense reward), baseada na proporção de verificações aprovadas — pass rate. O modelo recebe um sinal parcial e entende a direção do movimento: não "fracasso", mas "faltam dois testes de trinta". Isso resolve duas questões de uma vez. Primeiro, reduz o número de falsos negativos (false negatives), quando uma solução correta é rejeitada por causa de um teste excessivamente rigoroso ou simplesmente errôneo. Segundo, torna o aprendizado mais estável: a recompensa deixa de ser um evento raro e se transforma em uma escala.
Vale destacar separadamente a ligação entre essas duas ideias. A recompensa densa só faz sentido quando os testes realmente distinguem diferentes tipos de erro — caso contrário, você apenas calcula a média do ruído. E a síntese de testes a partir de soluções quase corretas, sem a recompensa densa, deixaria tudo na mesma interrupção de sinal. Os componentes funcionam em par.
Dataset e resultados
Com esse pipeline, os autores montaram uma versão ampliada do dataset CodeContests+ — com utilidade diagnóstica consideravelmente maior: os conjuntos de testes passaram a indicar com mais precisão em qual etapa específica da solução o modelo erra.
A principal medida não é o tamanho do dataset, mas o comportamento do modelo após o ajuste fino. O treinamento por RL do Qwen3-32B com o uso do RobustTests proporciona um ganho absoluto de 3% no LiveCodeBench. O código e os dados foram disponibilizados pelos autores em acesso aberto.
Aqui vale manter a sobriedade. Três pontos percentuais em um único benchmark, no ajuste fino de um único modelo, não são uma revolução na área, mas uma melhoria cuidadosa com mecanismo compreensível. O valor do trabalho está mais na metodologia: ela propõe uma receita reproduzível para extrair mais sinal dos testes sem ampliar sua quantidade manualmente. As limitações também são evidentes — a transferência do resultado para outros modelos, linguagens e tipos de tarefa ainda precisa ser verificada.
O que vale levar disso para a sua prática
Mesmo que você não esteja montando um pipeline de RL e apenas avalie a qualidade da geração de código, a lógica se transfere quase sem alterações:
- Escreva testes a partir dos erros, não apenas do enunciado. Pegue uma solução que quase funciona e encontre a entrada em que ela quebra. Esse teste quase sempre é mais informativo do que uma dezena criada "de forma direta".
- Calcule a proporção de verificações aprovadas, não o fato de ter passado. A pontuação parcial fornece gradiente tanto no treinamento quanto na análise de qualidade — dá para ver onde exatamente o modelo falha.
- Filtre os testes sintetizados. Sem validação e deduplicação, um conjunto gerado automaticamente rapidamente se transforma em um amontoado de verificações parecidas entre si.
- Fique atento ao que a recompensa realmente incentiva. A escala densa reduz a tendência a atalhos, mas não a elimina: se os testes não distinguem comportamentos, qualquer recompensa, cedo ou tarde, será hackeada.
A ideia que o RobustTests traz é humanamente simples: a melhor fonte de testes difíceis não é a imaginação do autor, mas os próprios quase-erros do sistema. Aquilo que o modelo quase fez certo é o indicador mais honesto de onde passa a fronteira entre "parece uma solução" e "solução".
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026
AffordanceWAM: affordances como intermediárias entre a previsão da cena e o controlo do manipulador
O trabalho descreve um modelo generativo que prevê simultaneamente observações RGB futuras, campos escalares, mapas de calor de affordances e comandos contínuos para o robô, usando vídeos humanos para ampliar a diversidade das interações sem anotações de ações nem retargeting. No RoboCasa, no CALVIN ABC→D e em tarefas reais, a abordagem apresenta ganhos consistentes em relação às linhas de base que usam apenas RGB e apenas dados robóticos.
9 novembro 2026
Edição de apresentações como operações controláveis: framework EditPPT e benchmark DeckEdit-Bench
Os autores analisam a edição de slides em termos de objetos específicos, ações permitidas e verificação de que o conteúdo não relacionado permaneceu intacto, em vez de geração livre de código. Para avaliar a qualidade, foi criado o DeckEdit-Bench (183 tarefas em 28 apresentações feitas por pessoas), e o sistema multiagente EditPPT, baseado em cinco modelos-base, apresenta uma taxa de sucesso de 66,7–74,9% das tarefas, com preservação acima de 97%.
8 novembro 2026