
Por que a votação por confiança funcionava, afinal
A ideia, familiar a qualquer um que já construiu pipelines em torno de grandes modelos de linguagem, é simples: executar a mesma tarefa várias vezes em paralelo e depois escolher a resposta por maioria. Mas não por maioria "plana", e sim ponderada — cada execução recebe um peso com base nos sinais internos do modelo, na maioria das vezes nas log-probabilidades dos tokens. A variante em que o modelo estava mais confiante soa mais alto que as demais.
Para raciocínios de um único passo, esse esquema se sai bem: quando o modelo erra, geralmente hesita, e a resposta correta vem acompanhada de alta confiança. A diferença nas log-probabilidades torna-se uma espécie de detector de erros embutido, que não exige chamadas adicionais, nem anotação, nem um modelo-juiz separado.
Quebra exatamente onde começou: na busca multi-passo
O problema é que os agentes modernos funcionam de outra forma. Eles não apenas raciocinam em uma única passagem: formulam consultas, recebem documentos externos, os incorporam ao contexto, refinam a consulta e assim por diante várias vezes, até reunirem material suficiente para a resposta final. Cada passo adiciona trechos de texto alheio à janela do modelo.
Os autores do trabalho "Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding" (arXiv:2608.24024, aceito no Findings da conferência EMNLP 2026) — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng e Beidi Chen — verificaram o que acontece com a votação por confiança nesse cenário. O resultado é desagradável: a técnica, ajustada em tarefas de um único passo, transfere-se mal para agentes de busca.
Mecanismo de falha: copy inflation
Os pesquisadores deram à causa o nome de copy inflation — "inflação por cópia". Quando os documentos recuperados entram no contexto, os tokens que o modelo transporta desses documentos para a sua resposta recebem log-probabilidades sistematicamente infladas. Copiar é uma operação fácil: continuar um texto que está bem diante dos olhos é estatisticamente mais simples do que gerar algo próprio. O modelo está "confiante" nesse token não porque ele esteja correto, mas porque foi literalmente copiado.
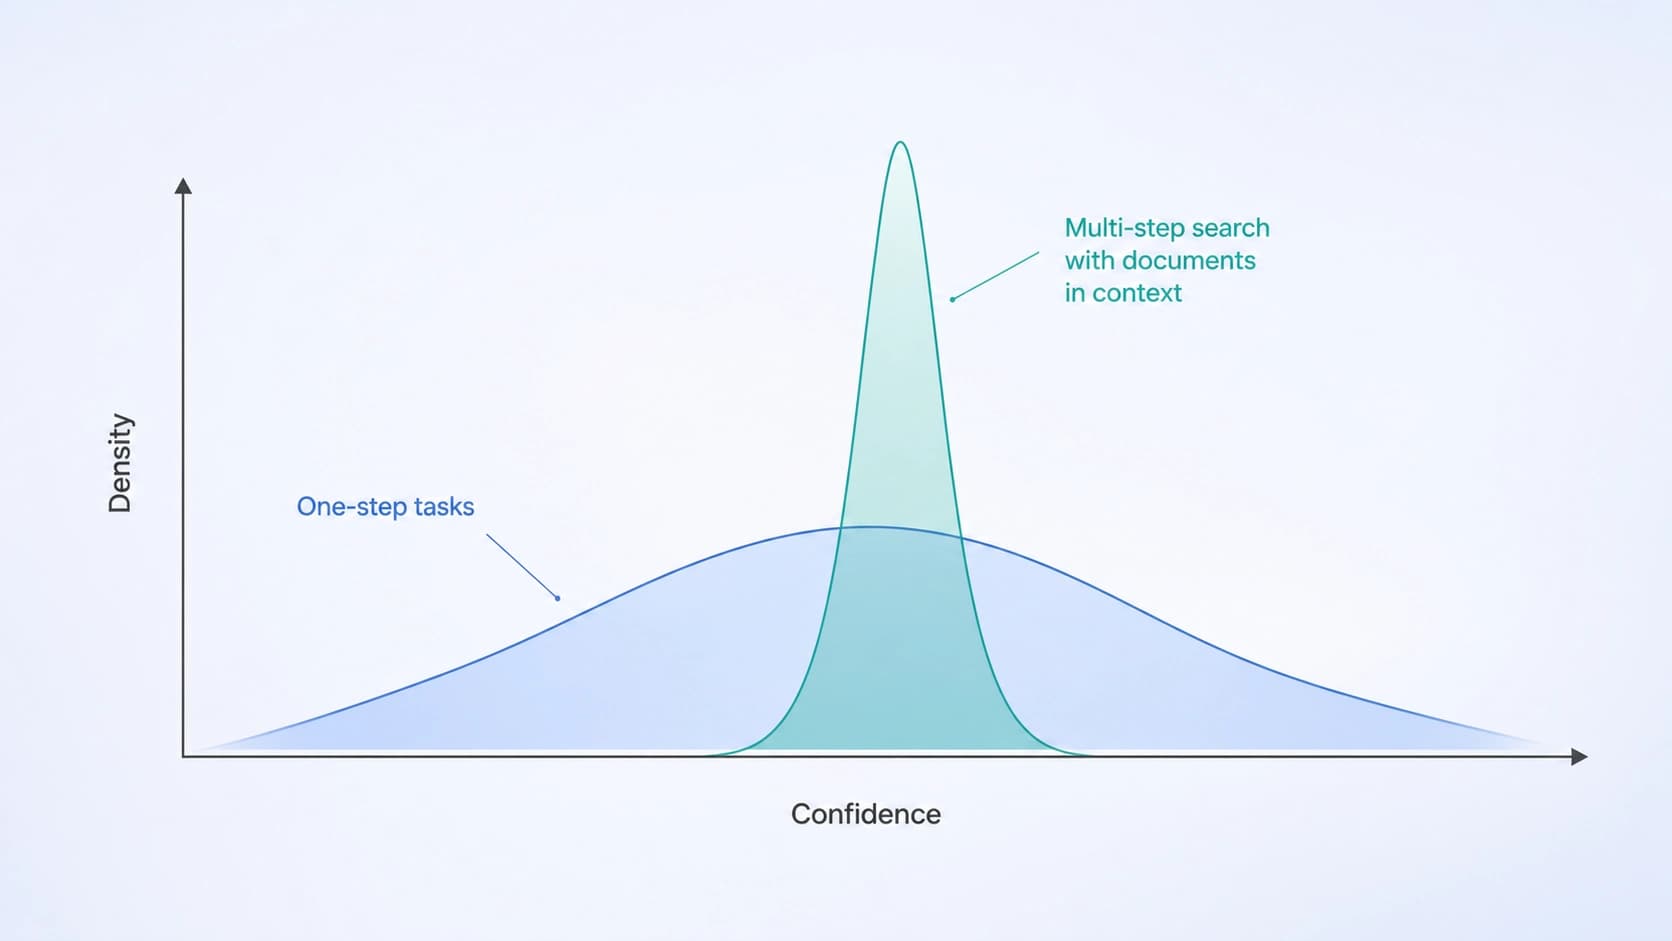
Depois, o efeito se acumula. Como todas as execuções, de uma forma ou de outra, se apoiam nos documentos encontrados, todas recebem sua dose de probabilidades infladas. As estimativas de confiança dentro de uma mesma pergunta se equalizam, comprimem-se em um intervalo estreito — e a votação ponderada perde o principal motivo de sua existência: a capacidade de distinguir uma execução forte de uma fraca. Os pesos tornam-se quase iguais, e a agregação degenera em uma maioria comum, só que com carga computacional extra.
O que propõem: Retrieval-Grounded Voting
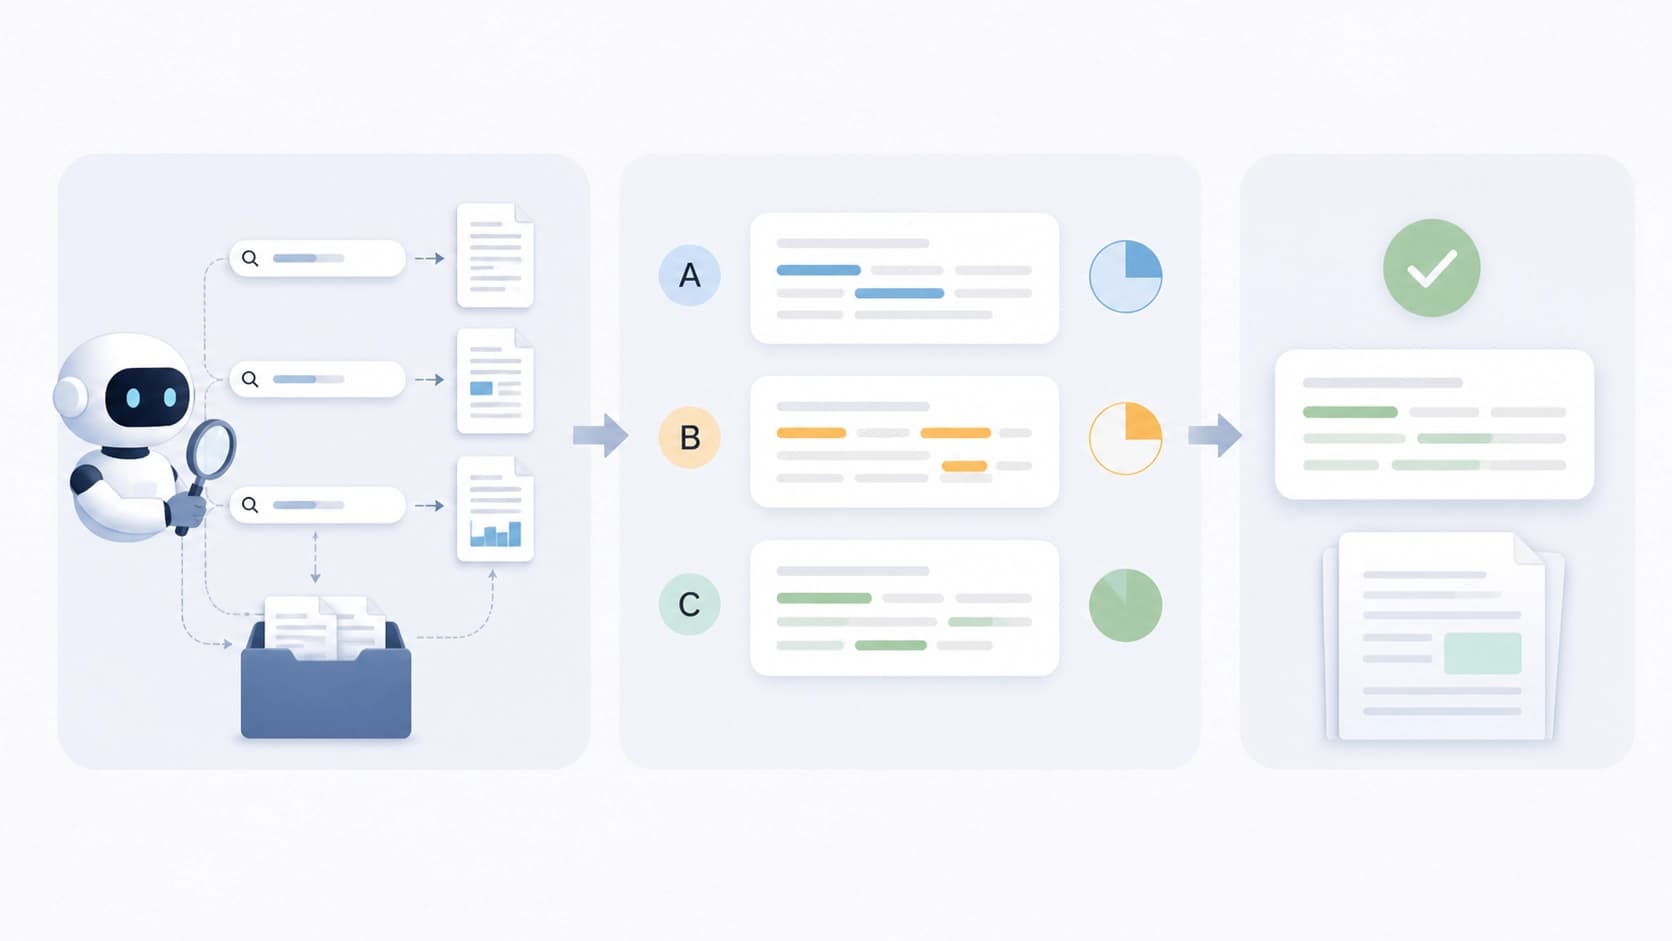
Como substituto, os autores propõem o método Retrieval-Grounded Voting (RGV). Ele também avalia cada execução separadamente, mas olha não para dentro do modelo, e sim para fora — para a relação entre a resposta final e os documentos que essa mesma execução recuperou.
A métrica é deliberadamente simples: a interseção lexical entre o texto da resposta e o texto das fontes recuperadas. Quanto mais a resposta se apoia no material encontrado, maior sua pontuação. Uma execução que inventou algo por conta própria ou saiu pela tangente compartilha menos palavras com seus documentos e recebe um peso menor.
Por que o sinal funciona
A lógica aqui é a seguinte: se o agente realmente encontrou páginas relevantes e construiu sua conclusão sobre elas, as formulações da resposta inevitavelmente se cruzarão com as formulações das fontes — termos, nomes, expressões. Não é um indício perfeito de correção, mas é robusto onde as log-probabilidades já estão comprometidas.
A principal vantagem do RGV é que ele calcula o sinal fora do contexto contaminado. A avaliação se baseia no par "resposta — documentos", e não no estado do modelo no momento da geração, portanto o copy inflation não a afeta. De quebra, o método dispensa acesso às log-probabilidades dos tokens e não requer chamadas adicionais ao LLM: nenhum modelo-juiz, nenhuma segunda passagem, apenas a contagem de interseções — uma operação que pode ser feita com código comum quase de graça.
Resultados
Os experimentos foram realizados em quatro benchmarks para agentes de busca e cinco modelos de linguagem diferentes. O quadro se repete: o RGV supera consistentemente a votação por confiança.
A medição mais reveladora é nas questões "minority-correct", em que a resposta correta aparece em apenas uma ou duas execuções de oito. É justamente aqui que a ponderação por confiança fracassa mais: as probabilidades infladas puxam a votação para a versão majoritária, mas incorreta. O ganho do RGV nessas questões chega a +35%, e na precisão geral, a até +5.4%.
Os números devem ser lidos com uma ressalva: não é "mais cinco por cento de qualidade em qualquer sistema de busca", mas sim uma melhoria no procedimento de agregação com modelo e conjunto de execuções fixos. Ou seja, o método não muda nada no próprio agente — ele apenas escolhe com mais cuidado entre o que o agente já gerou.
O que isso significa na prática
Se você está construindo um agente multi-passo e já usa self-consistency ou qualquer votação por probabilidades, o RGV tem três vantagens práticas:
- Não custa nada em inferência. Não são necessárias chamadas adicionais ao modelo; o peso é calculado a posteriori com base nas respostas e documentos já prontos.
- Funciona com modelos fechados. As log-probabilidades dos tokens não estão disponíveis nem de longe sempre, e às vezes ficam totalmente ocultas atrás da API. A comparação de textos é livre dessa limitação.
- Depura-se de forma previsível. A métrica é transparente: é possível ver quais palavras geraram correspondência e entender por que a execução recebeu determinado peso.
Onde o método pode tropeçar
O ponto fraco é evidente pela própria construção: a interseção lexical recompensa a coincidência de palavras, não a coincidência de sentido. Uma resposta parafraseada, mas correta, receberá um peso injustamente baixo; um resultado numérico ou um resumo curto também quase não se cruzará com o texto original, mesmo que lhe corresponda plenamente. A situação inversa é ainda mais desagradável: uma execução que simplesmente cita longamente o que foi encontrado obterá uma pontuação alta, sem nada acrescentar à solução.
Daí a estratégia razoável — encarar o RGV não como substituto de todos os sinais, mas como um voto adicional, especialmente útil justamente onde a confiança do modelo deixa de significar qualquer coisa. Também é lógico combiná-lo com verificações de outros tipos: comparação de sentidos, avaliação por um modelo separado, verificação por fatos. Os autores, a julgar pela formulação do problema, seguiram exatamente nessa direção — de "confiar na sensação interna do modelo" para "avaliar o que ele realmente fez".
Conclusão
A história do copy inflation é uma boa ilustração de um problema geral dos pipelines agênticos: técnicas ajustadas isoladamente em um modelo com um único passo de raciocínio desmoronam silenciosamente quando se adicionam ao ciclo busca, contexto e textos alheios. A confiança do modelo deixa de ser uma medida de correção e se transforma em uma medida de facilidade de cópia.
O RGV oferece um caminho alternativo que parece quase entediante — contar a interseção de palavras entre a resposta e as fontes. Mas é justamente esse tédio que torna o método atraente: é barato, transparente, não exige as entranhas do modelo e proporciona um ganho notável onde a resposta correta se afoga no ruído. Para equipes que constroem agentes de busca a partir de APIs prontas, é um caso raro de melhoria útil que não exige nem retreinamento, nem novos orçamentos de inferência.


