Por que é tão difícil automatizar a avaliação de agentes de voz
Um agente de voz conversacional não é um único modelo, mas um pipeline: reconhecimento de fala, raciocínio, chamada de ferramentas, geração de resposta, síntese e streaming de áudio. Uma falha em qualquer etapa não permanece local — ela se arrasta pela cadeia e emerge no próprio diálogo. É exatamente por isso que faz sentido julgar a qualidade da interação apenas de ponta a ponta, e não por elos isolados.
Manter uma equipe de avaliadores humanos é caro e inconveniente: não dá para escalá-los para centenas de milhares de conversas, e a atenção deles cai no fim do turno. A saída natural é entregar a avaliação a um modelo de linguagem. Um preprint recente do arXiv:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) justamente verifica o quanto essa saída se justifica e onde ela quebra.
Como os autores testaram os juízes LLM
O experimento é construído sobre conversas reais de agentes de voz de dois setores — telecomunicações e varejo. As avaliações humanas foram comparadas com os veredictos do GPT-4.1 e do GPT-5, e não por uma única escala generalizada, mas por dez métricas: parte descreve a qualidade da própria conversa, parte descreve a segurança.
Três configurações em vez de uma
Os mesmos diálogos foram executados em três esquemas de avaliação — p0, p1 e p2. O sentido do exercício é simples: se o veredicto muda conforme a forma como a rubrica é montada, então o juiz mede não a qualidade da conversa, mas a forma da instrução. Qualquer métrica que "oscila" entre configurações não serve para automação — pelo menos sem ressalvas.
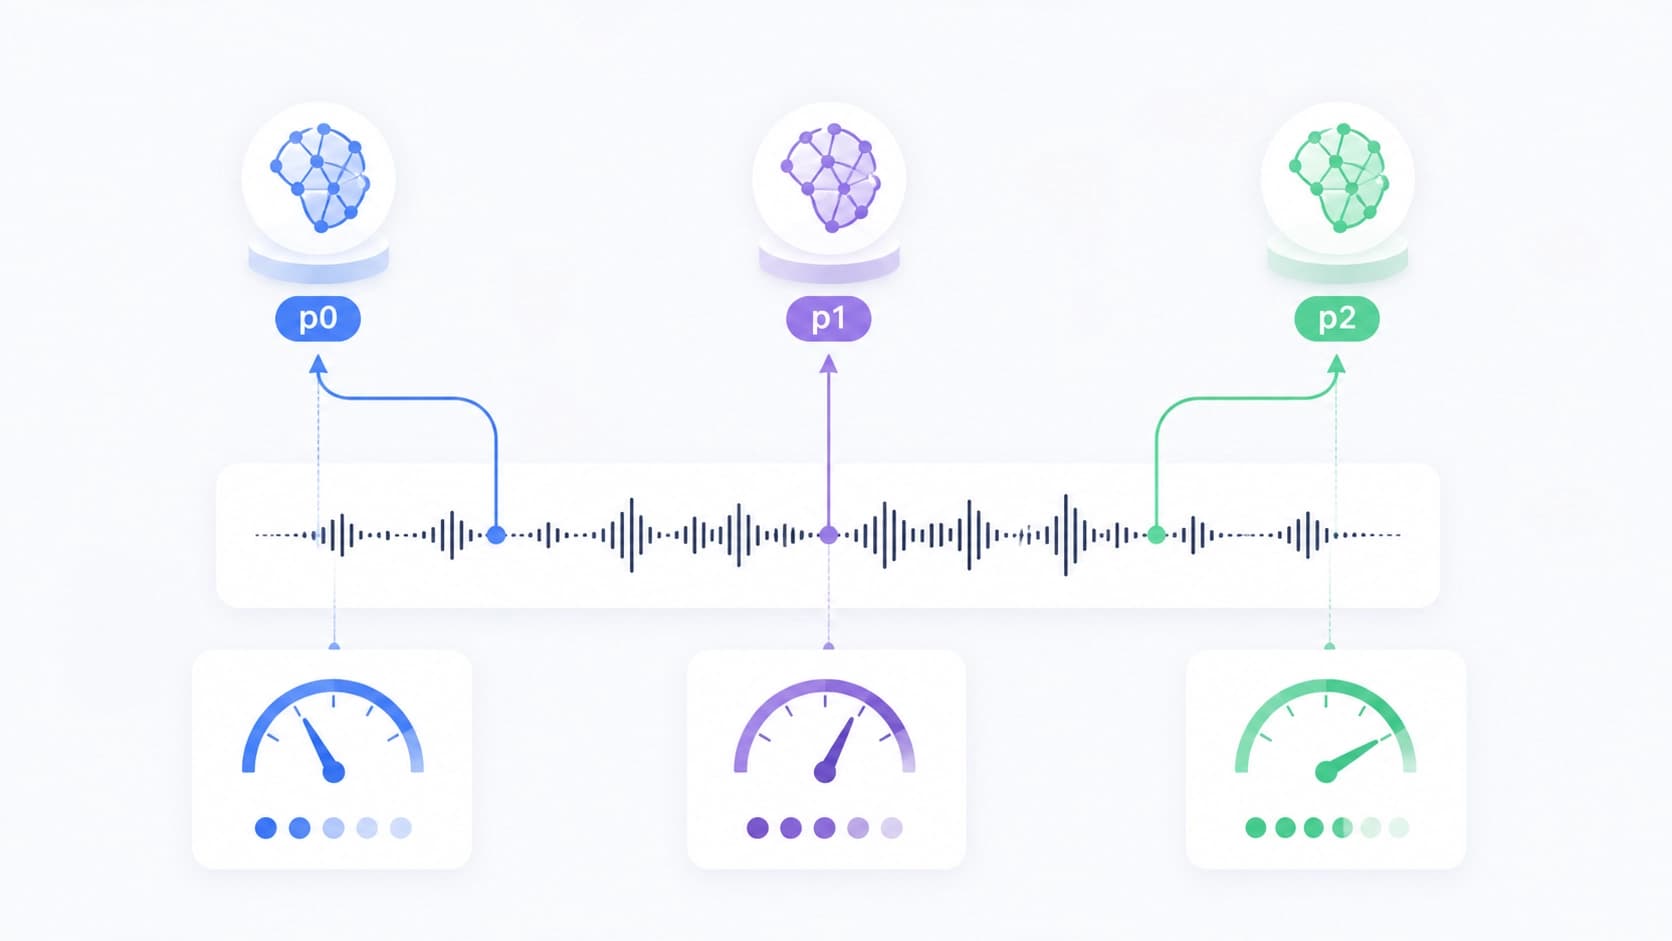
O que exatamente foi comparado
A concordância agregada — o percentual de coincidências entre humano e modelo — é apenas a camada superficial. Os autores cavam mais fundo: observam as correlações de cada métrica separadamente, verificam o quão estáveis são as avaliações dentro de um grupo de pessoas e analisam as divergências sistemáticas entre humano e LLM. Esse recorte permite entender quais atributos da conversa se prestam à avaliação automática e quais esbarram no contexto e na interpretação.
Onde o juiz LLM erra
A conclusão principal soa mais como um alerta do que como propaganda do método: a confiabilidade da avaliação automática não é uniforme — ela depende da métrica específica e da configuração. Os mesmos modelos-juízes dão resultados sólidos em algumas escalas e caem bastante em outras.
Recovery Turn Count
Essa métrica conta quantos turnos o agente precisou para tirar a conversa de uma falha. A avaliação automática aqui é pouco confiável: o juiz nem sempre distingue uma recuperação significativa de uma formulação que deu certo por acaso. Um diálogo que uma pessoa chamaria de salvo, o modelo facilmente registra como fracasso — e vice-versa.
Métricas de segurança por recall
Safety-recall é a segunda área problemática. A lógica do erro é previsível: o juiz vê um diálogo em que o agente não disse nada perigoso e dá uma nota alta, sem se perguntar se houve sequer a oportunidade de violar a política. Uma violação não detectada é o tipo de erro mais caro, e é justamente aí que a automação é mais fraca.
O domínio muda a calibração
A confiabilidade dos juízes varia entre telecomunicações e varejo. A conclusão prática: limiares e rubricas não podem ser transferidos mecanicamente de um setor para outro — o que foi calibrado em um domínio vai desandar em outro.
Calibração importa mais do que o percentual de concordância
Um número único de concordância embala a vigilância. O modelo pode coincidir com as pessoas na média em grandes números, mas ser sistematicamente mais brando em casos limítrofes — e esse viés não aparece no percentual geral. Por isso, a análise de correlação da calibração e o exame das divergências por cada classe de casos são mais úteis do que uma única métrica resumida: ela mostra não "o quão próximos estamos", mas "em que direção e em que pontos estamos mentindo".
Como encaixar isso em um pipeline real
Os autores não propõem abandonar a automação — propõem um esquema híbrido. O juiz LLM assume a avaliação em massa, e as pessoas ficam onde o contexto e a alta confiança no veredicto são necessários. As regras práticas são estas:
- execute a rubrica em pelo menos duas ou três configurações e compare os resultados, não apenas a nota final;
- calcule a concordância de cada métrica separadamente, e não com um único número para todo o dataset;
- mantenha humanos em safety-recall e nas métricas de recuperação após falha;
- verifique a calibração no seu domínio antes de definir limiares automáticos;
- guarde os casos de divergência humano/modelo — é material pronto para o refinamento da rubrica.
O que fica no fim das contas
O juiz LLM é uma ferramenta viável para a avaliação em larga escala de agentes de voz, mas não substitui o avaliador. Sua confiabilidade é distribuída de forma desigual: parte das métricas pode tranquilamente ser entregue à automação, parte exige um olhar humano. A utilidade do estudo está em oferecer um arcabouço empírico para essa divisão de trabalho — e em lembrar que a pergunta "devemos confiar a avaliação ao modelo" é incorreta enquanto não se especifica em qual métrica e em qual domínio.