Por que o RAG agêntico chega a uma encruzilhada
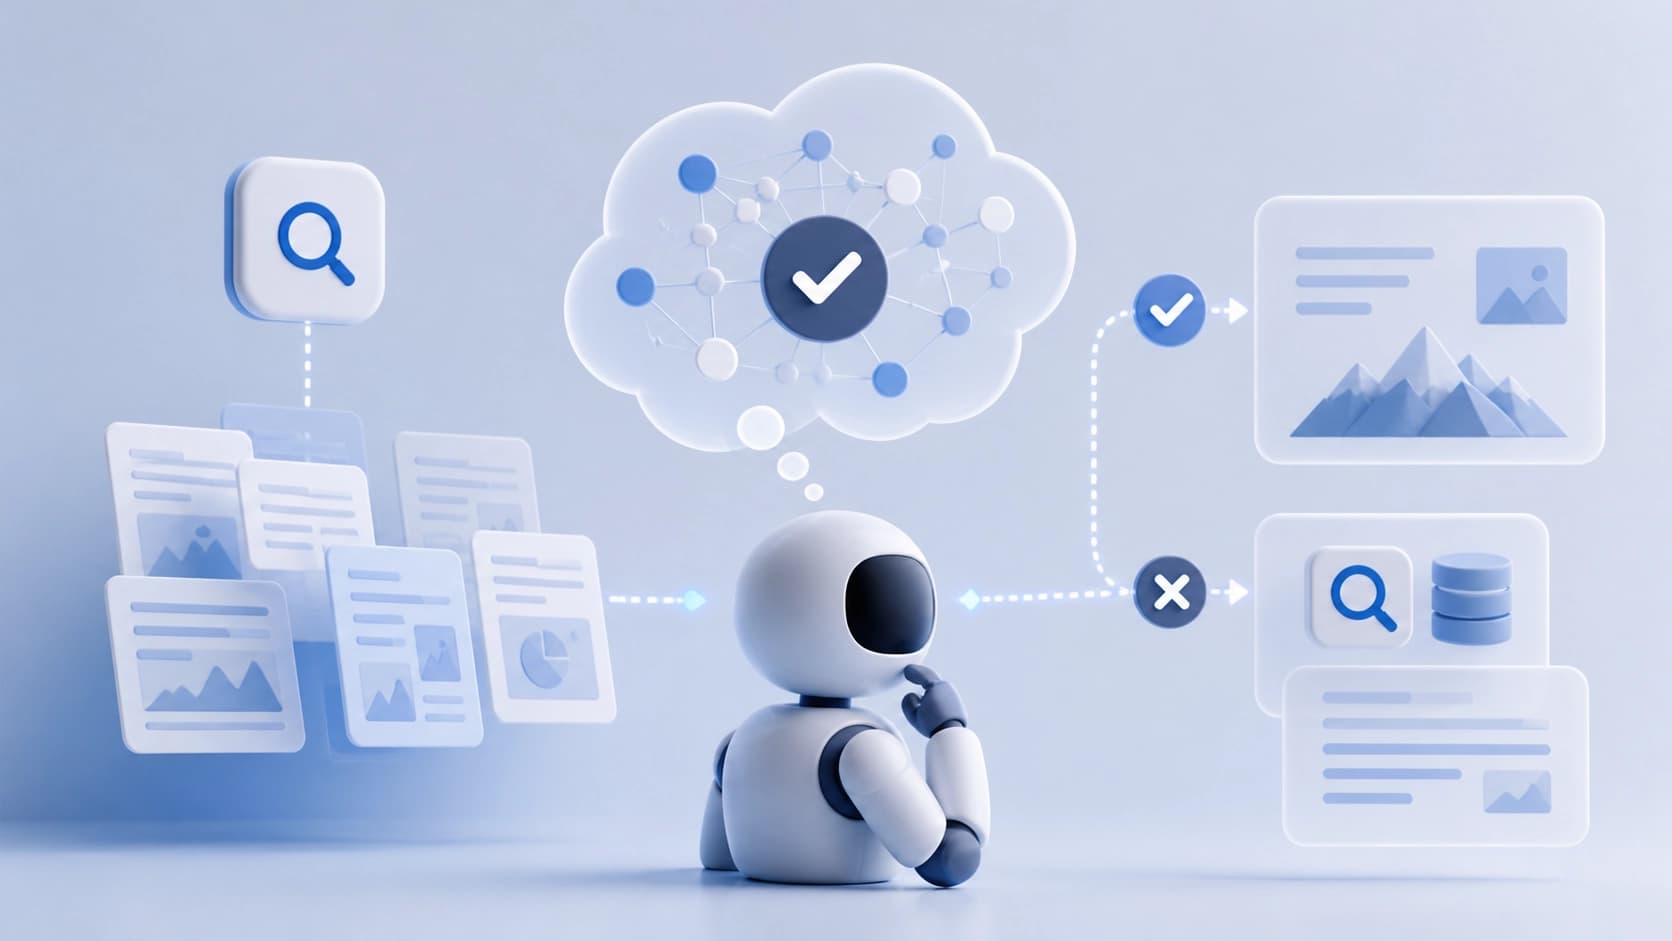
O RAG agêntico funciona como um ciclo: o modelo lê a pergunta, decide se precisa de mais uma consulta à busca, recebe os resultados e escolhe de novo — continuar buscando ou já responder. Cada iteração extra custa dinheiro e tempo, cada iteração pulada ameaça uma resposta incompleta. Acontece que a principal habilidade do agente não é a extração de documentos, mas a capacidade de dizer a tempo "as evidências são suficientes".
O aprendizado por reforço clássico avalia esse comportamento de fora: a resposta bateu com a referência — ponto positivo, não bateu — ponto negativo. Ninguém pergunta o que o próprio modelo pensa sobre a completude dos fatos reunidos. Daí vêm duas doenças simétricas: a política ou continua cavando quando internamente tudo já está claro, ou interrompe a busca embora os dados sejam obviamente poucos. A recompensa externa não distingue essas situações — o resultado é o mesmo, mas o comportamento é diferente.
Mudança na formulação do problema
Os autores do trabalho MetaRAG propõem olhar não só para a ação, mas também para o quanto ela coincide com a convicção interna do agente sobre a suficiência das evidências. Essa formulação eles chamam de alinhamento entre convicção e ação — belief-action alignment. A ideia é simples: a qualidade da decisão de buscar não é uma métrica separada por cima da resposta, mas a coerência entre o que o modelo "pensa" e o que ele faz.
Como o MetaRAG é estruturado
O framework é montado a partir de três partes: uma verificação explícita antes da ação, uma sonda da convicção interna e uma recompensa especial que liga uma coisa à outra.
Verificação antes da ação
O primeiro componente é o Verify-first Action Generation. Em vez de emitir imediatamente o próximo passo, a política primeiro o submete a um procedimento explícito de verificação: esse passo é adequado ao estado atual da busca. A ideia é filtrar decisões impulsivas antes que elas entrem na trajetória. Na prática, é um "congelamento de imagem" embutido na geração, que normalmente falta aos agentes rápidos.
Sonda da convicção interna
O segundo componente é o Internal Belief Probing. A partir do mesmo contexto que a política vê (a pergunta mais o histórico de ações e observações), lê-se separadamente a opinião da própria política: já é possível responder à pergunta agora. É importante notar que não se trata de um modelo-juiz externo nem de anotação humana — o sinal vem da mesma política, apenas obtido de outra forma.
Recompensa por coerência com salvaguarda
Desses dois sinais deriva-se a consistency reward: o agente é recompensado quando sua ação coincide com a avaliação interna de suficiência das evidências. Aqui há uma armadilha óbvia — pode-se começar a recompensar um comportamento "confiantemente errado" se o modelo errar de forma coerente e consistente. Os autores fecham essa brecha com um gate: a recompensa por coerência só é considerada quando a resposta se mostrou correta. Em outras palavras, a coerência não é um fim em si, mas um multiplicador da correção.
Um detalhe à parte, importante para quem pratica: a sonda de convicção existe apenas na etapa de treinamento. Na inferência ela não é chamada, então não surgem cálculos extras a cada requisição — o custo adicional permanece nulo.
O que os experimentos mostraram
O trabalho foi testado em sete benchmarks públicos de perguntas e respostas. O resultado declarado é uma melhoria consistente no compromisso entre precisão e eficiência em relação a métodos RL de base fortes para o RAG agêntico. Ou seja, o ganho não está em simplesmente responder com mais precisão, mas em não pagar por isso com uma busca infinita.
Em seguida, os autores verificaram o quanto o efeito se transfere: para o cenário de pesquisa profunda (deep research), para diferentes otimizadores e para diferentes modelos de base. Em todas essas configurações, segundo seus dados, o método mantém a vantagem. Esse é justamente o tipo de verificação que costuma faltar: uma melhoria em um único modelo e um único conjunto de dados é facilmente confundida com um ajuste bem-sucedido de hiperparâmetros.
O que isso significa na prática
Para quem desenvolve sistemas de busca agênticos, o MetaRAG aponta uma direção mais barata do que parece. Se você já tem treinamento de política, adicionar o sinal sobre a convicção interna não exige novos anotadores: o mesmo contexto que a política já vê pode ser usado como fonte de sinal. O gate por correção, nesse caso, é obrigatório — sem ele o agente pode aprender a errar de forma bonita e confiante.
A segunda conclusão diz respeito ao design da recompensa em geral. Métricas externas respondem à pergunta "deu certo", mas quase nada dizem sobre "o agente foi adequado no momento". Distinguir essas duas coisas é a ideia central do artigo: a coerência entre convicção e ação é um objeto autônomo, otimizável separadamente, e não um efeito colateral do aumento da precisão.
No entanto, vale ter em mente os limites: os experimentos se restringem a benchmarks de QA e a cenários de pesquisa profunda, e a própria abordagem é construída sobre o aprendizado por RL, ou seja, não é aplicável "de fábrica" a sistemas em que a política não é treinada de forma alguma. Para esses casos, o mais útil é a própria ideia — verificar explicitamente a ação antes de executá-la e avaliar separadamente se a decisão coincide com a sensação interna de suficiência dos dados.
O texto completo está disponível como arXiv:2608.24214 (v1, 25 de agosto de 2026, seção cs.AI) — o trabalho foi aceito no programa principal da conferência EMNLP 2026.