Por que a trajetória é uma unidade de medida ruim
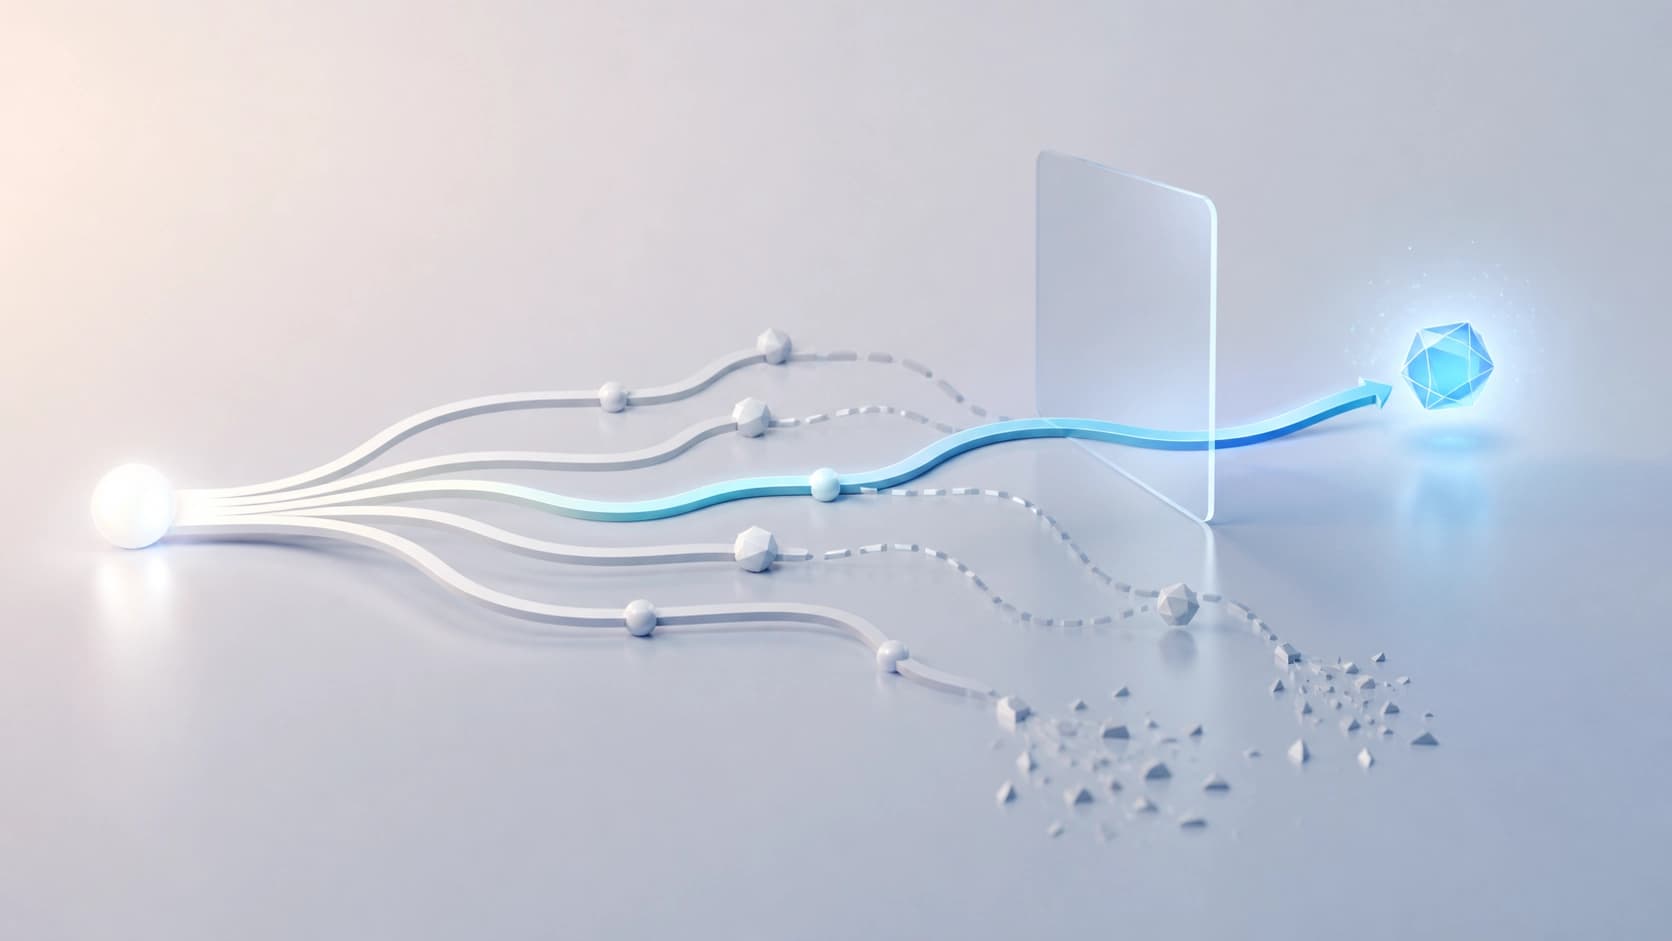
Os métodos modernos de raciocínio durante a inferência funcionam segundo o mesmo esquema: o modelo gera não uma única resposta, mas todo um conjunto de cadeias candidatas, após o que um reward model externo escolhe a melhor. A lógica é simples — quanto mais variantes, maior a chance de que entre elas haja uma bem-sucedida.
O ponto fraco aqui está em outro lugar. Cada candidato é tratado como um todo indivisível: ou é aceito por completo, ou é inteiramente descartado. Mas um raciocínio longo raramente é homogêneo. O quadro típico — um início confiante e correto, uma formulação cuidadosa do problema, um método escolhido acertadamente, e então um colapso: erro aritmético, loop, substituição da condição. Formalmente, toda a cadeia é marcada como malsucedida, embora sua primeira metade fosse perfeitamente funcional.
O resultado — computação desperdiçada. Pagamos pela geração de tokens que estavam corretos e depois os descartamos junto com a cauda corrompida. É justamente para essa ineficiência que apontam os autores do trabalho Selective Regenerative Decoding, publicado como arXiv:2608.24338 (cs.AI) em 25 de agosto de 2026.
SRD: três ramificações em vez de duas
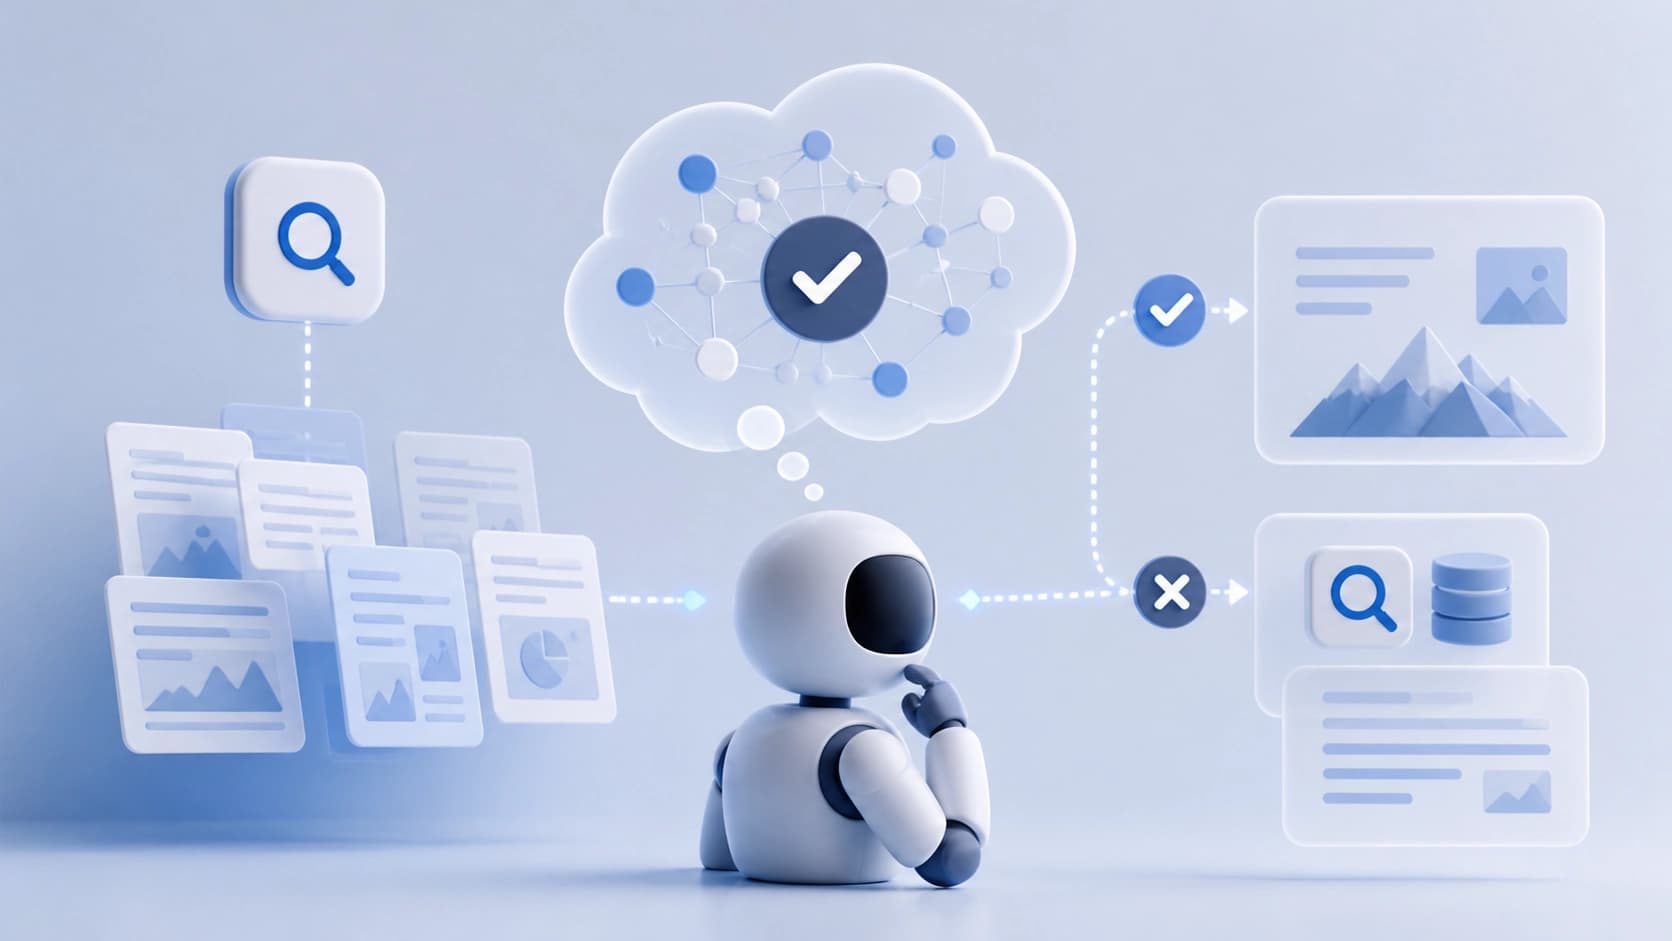
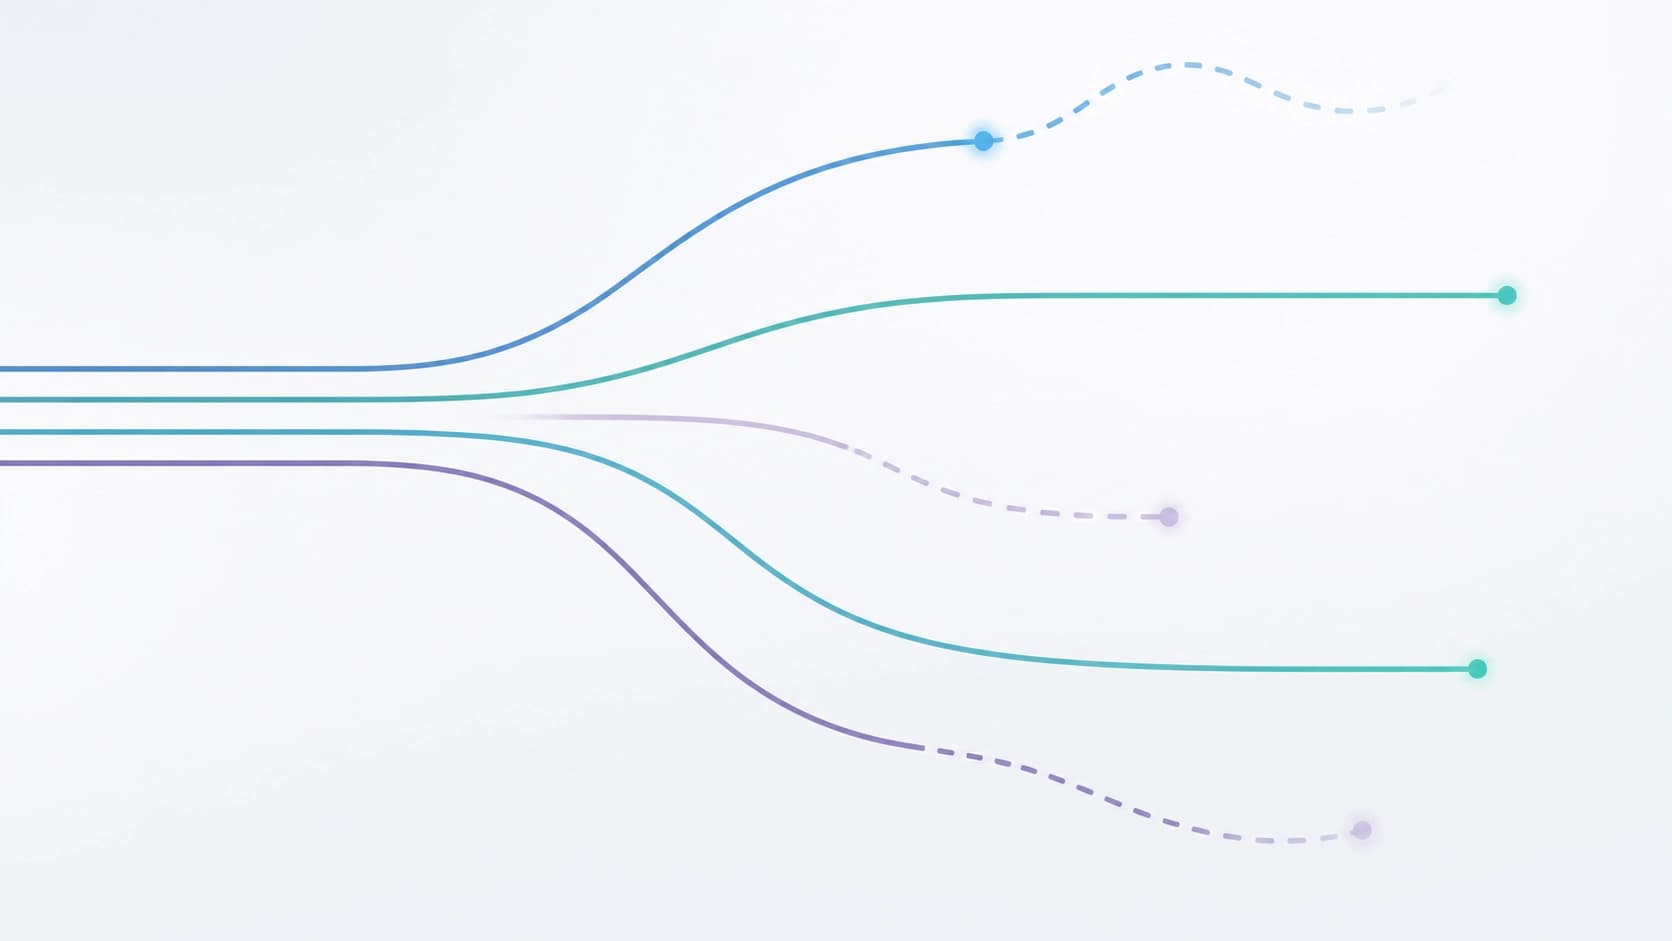
O Selective Regenerative Decoding (SRD) propõe abandonar a escolha binária. Em vez de "aceitar ou descartar", cada candidato é encaminhado para uma de três ramificações:
- descartar — se a cadeia é inútil do início ao fim;
- manter — se ela passa na verificação por completo;
- retrabalhar — se há uma parte útil, mas o sufixo claramente se degradou.
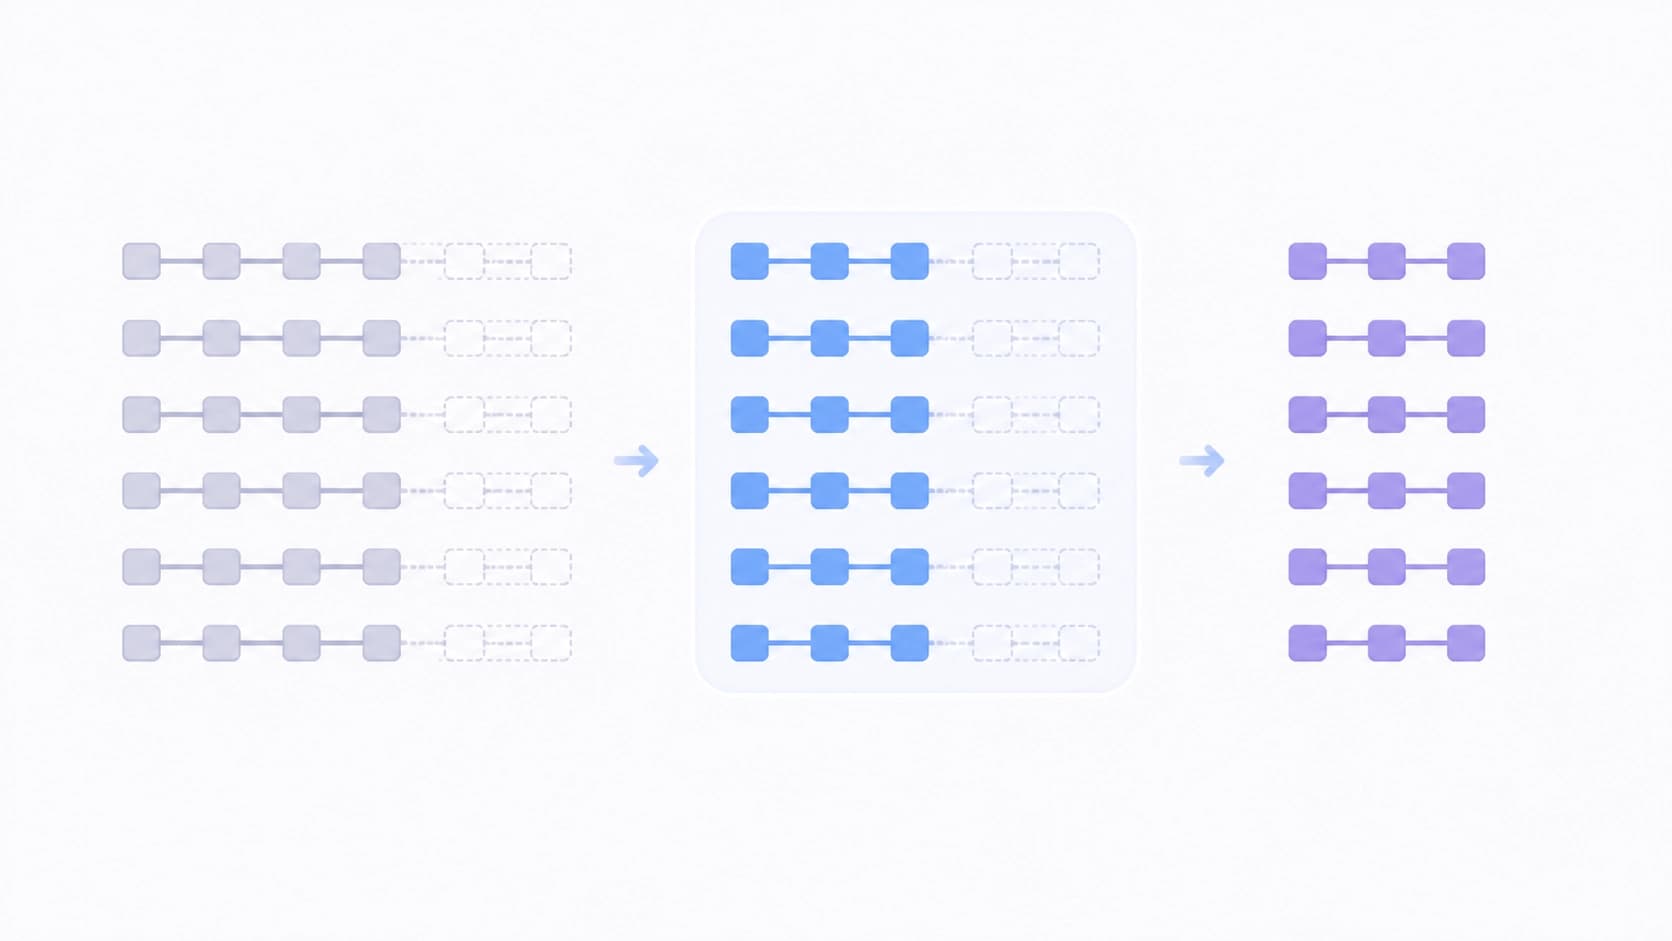
No terceiro caso, o sistema não reescreve o raciocínio do zero, mas preserva o prefixo de qualidade e regenera apenas o trecho corrompido. Isso está mais próximo de editar um rascunho do que de escrever um texto novo: você não descarta uma introdução bem-sucedida por causa de um final fracassado, mas corrige o que quebrou.
Os autores destacam separadamente que, para essa intervenção, não é necessário um modelo doador maior. Nada de um "professor inteligente" que puxaria um aluno fraco — todo o trabalho ocorre dentro dos recursos computacionais já disponíveis. É justamente isso que torna o método aplicável, e não um exercício teórico.
De onde vem o ganho
O mais interessante no trabalho não é a heurística, mas sua justificativa. Sob suposições brandas, o SRD proporciona um crescimento demonstrável da eficiência de amostragem de 1,28–1,36 vezes em relação ao rejection sampling clássico, e a qualidade esperada da trajetória final mostra-se estritamente superior, e não apenas "não pior".
A intuição aqui é clara sem fórmulas. O candidato que passou pela regeneração do sufixo já contém em si a computação paga — aqueles tokens do prefixo que não precisam ser gerados de novo. Quanto mais desses candidatos limítrofes conseguimos salvar, menor a fração do texto gerado que vai para o lixo. E, como ao aumentar o conjunto de candidatos cresce também o número de cadeias "quase bem-sucedidas", o ganho não permanece constante — ele escala junto com o orçamento de geração.
Onde isso foi testado
A parte empírica abrange quatro tipos diferentes de carga: MATH500 (problemas matemáticos), GPQA Diamond (questões de nível científico), HotpotQA (perguntas de múltiplos passos sobre documentos) e AlpacaEval (seguimento de instruções e avaliação de preferências). Os testes foram realizados em várias combinações de "gerador + reward model", para que o resultado não dependesse de um único par bem-sucedido.
Os resultados declarados: o SRD alcança a precisão que normalmente se obtém com o modo Best-of-N, mas consome significativamente menos tokens gerados. E, em cenários com computação limitada, o método supera o speculative rejection — ou seja, ganha justamente onde cada token extra custa caro.
O que isso muda em essência
A principal mudança que os autores registram é metodológica. Antes, a escolha ocorria no nível de toda a trajetória: o reward model atribuía uma nota e decidia o destino de todo o raciocínio. O SRD transfere a intervenção para dentro da trajetória, para o nível dos segmentos, e, com isso, abre uma área de compromisso entre precisão e computação que até agora quase não havia sido estudada.
A conclusão prática para quem constrói pipelines de inferência: a qualidade do raciocínio e o custo de obtê-la não são necessariamente grandezas rigidamente ligadas. Parte da computação "extra" pode ser recuperada se deixarmos de tratar o rascunho do modelo como um monólito.
O que fica de fora
Questões abertas não faltam. A principal — como exatamente se define a fronteira entre o prefixo saudável e o sufixo degradado: desse critério depende quantos candidatos sequer chegarão à terceira ramificação. Em seguida — o custo da própria regeneração (ela não é gratuita), a sensibilidade à escolha do reward model e a transferibilidade das conclusões para além dos quatro benchmarks utilizados.
O trabalho ocupa 20 páginas e foi submetido ao ARR, ou seja, por enquanto é um preprint de primeira versão, e não um resultado revisado por pares. Mas a direção parece promissora: em vez de gerar mais e selecionar com mais rigor, é possível administrar com mais cuidado aquilo que o modelo já concebeu.