
Por que "mostre onde está" é a pergunta errada
O teste clássico de orientação visual parece quase escolar: dá-se uma imagem e uma frase como "a pasta azul na prateleira de baixo", e o modelo deve indicar onde está o objeto desejado. Uma consulta, uma resposta, uma métrica — acertou ou não.
O esquema é conveniente, mas descreve não uma conversa, e sim um comando. Na comunicação real, uma pessoa raramente fornece uma descrição exaustiva de primeira. Ela diz "aquela coisa perto da janela" e espera que o interlocutor adivinhe ou pergunte de novo. O entendimento mútuo se constrói ao longo do diálogo — às vezes em duas rodadas, às vezes em cinco.
Os autores do trabalho arXiv:2608.23978 (Zhengxiang Wang e Owen Rambow, artigo aceito na EMNLP 2026) propõem considerar justamente essa etapa ausente como objeto de medição. A pergunta deles é: o modelo é capaz não apenas de olhar, mas também de perguntar quando imagens e palavras não bastam para uma inferência inequívoca?
Como o experimento está estruturado
Déficit de informação controlado
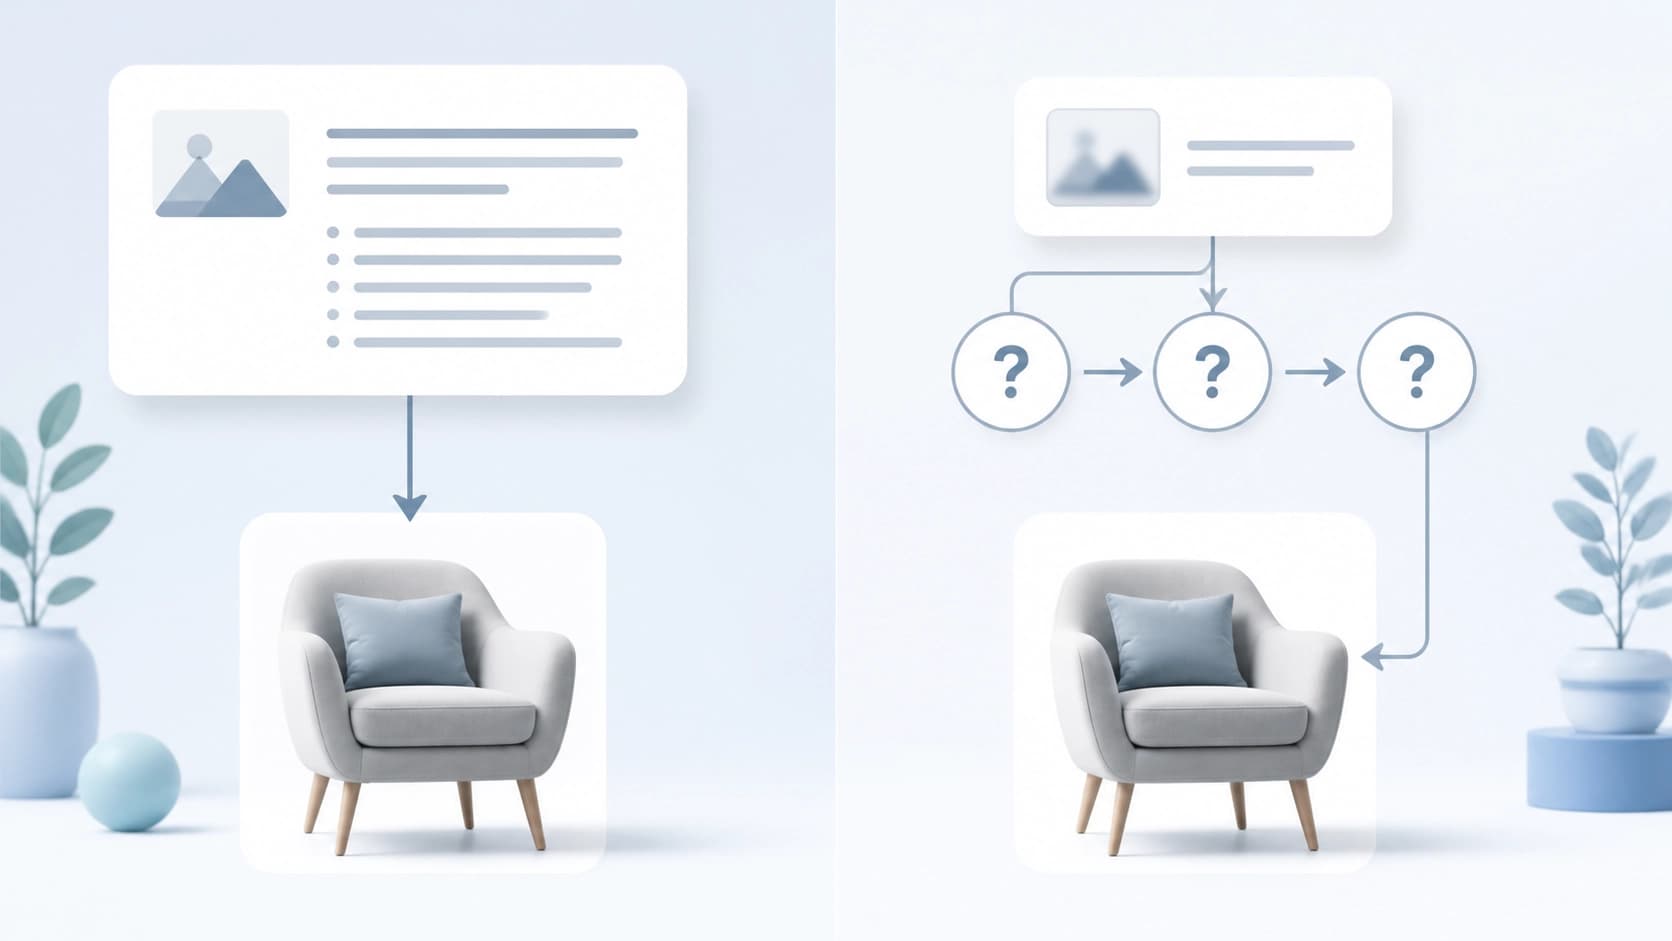
A ideia central é não medir a precisão "em média", mas regular gradualmente quanta informação sobre o alvo é fornecida de antemão e quanto o modelo deve obter por conta própria. Em uma extremidade da escala, a tarefa quase não difere de um teste de etapa única comum: a descrição é detalhada, o alvo é óbvio. Na outra, não há formulação inicial alguma, e tudo o que o modelo sabe sobre o objeto desejado ele deve extrair de suas próprias perguntas de esclarecimento.
Essa construção permite separar a habilidade de reconhecimento da habilidade de conduzir um diálogo. Um modelo que encontra perfeitamente um objeto a partir de uma dica precisa pode fracassar completamente quando a dica precisa ser montada peça por peça.
Quatro contextos e quatro protocolos
O ambiente experimental baseia-se em quatro contextos visuais próximos de cenários humanos e quatro protocolos de interação diferentes. Isso é importante: o resultado não se reduz a uma única configuração bem-sucedida ou malsucedida. De passagem, também se verificou quem formula a descrição — uma pessoa ou outro modelo —, bem como a influência do volume de raciocínio, das tentativas repetidas e da troca de fornecedor de descrições. Os padrões discutidos abaixo se reproduziram em todas essas variantes.
Onde exatamente quebra
A lacuna em relação ao humano se mantém em todos os protocolos
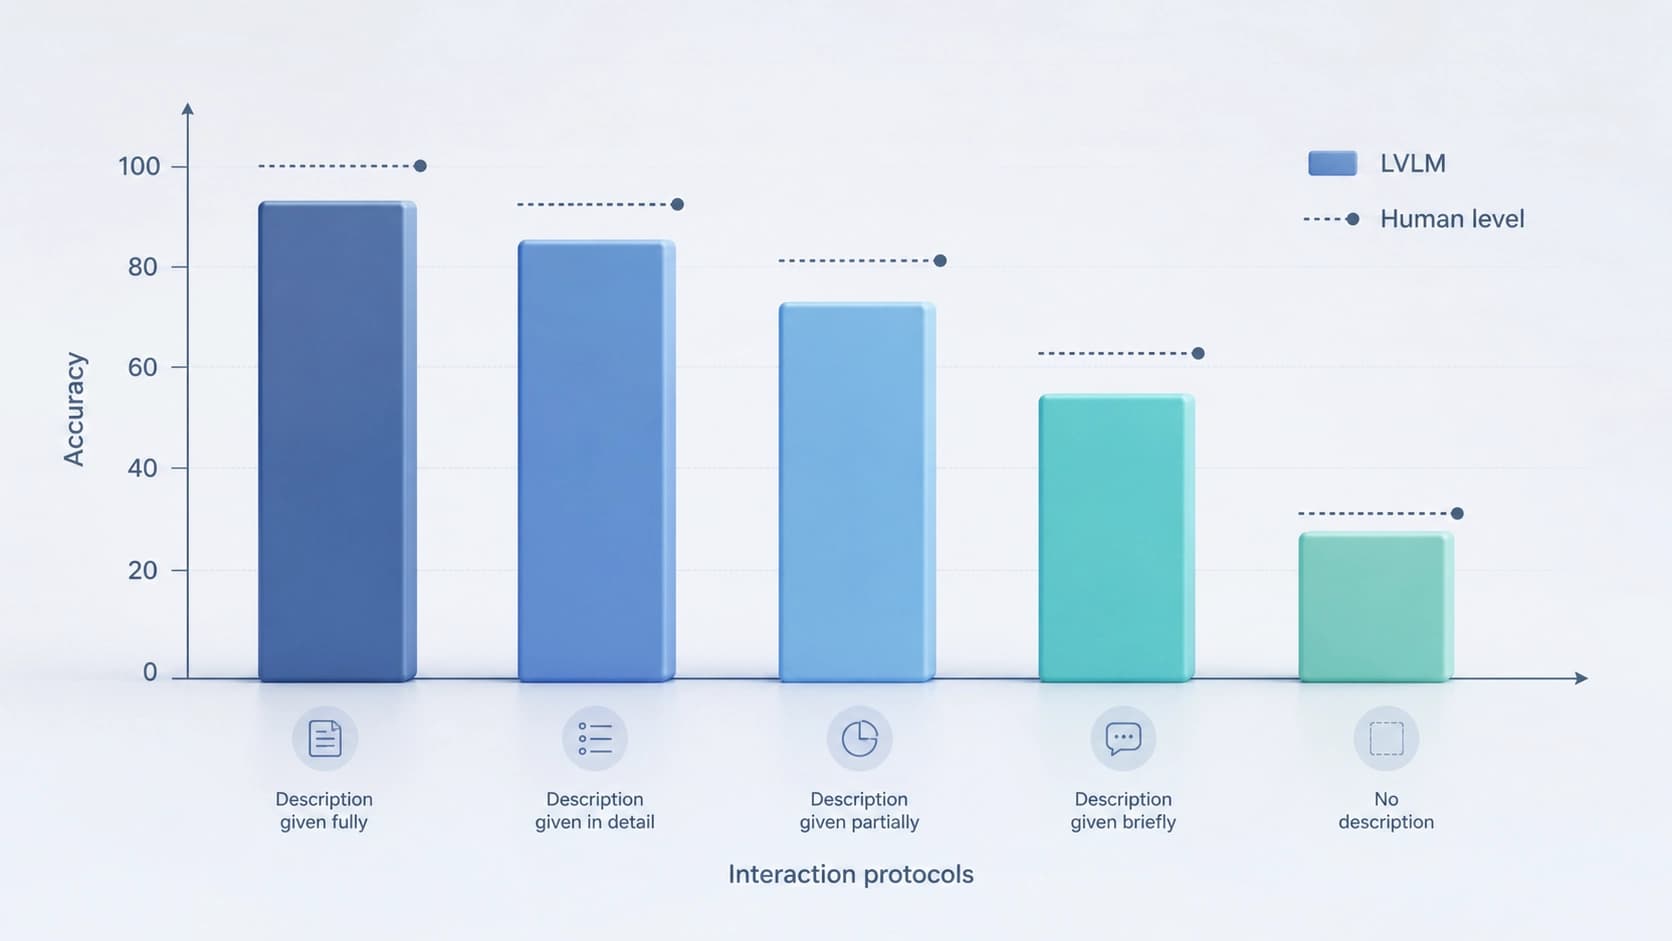
A principal conclusão não é animadora: em nenhum dos modos os atuais grandes modelos visuais-linguísticos chegaram perto dos indicadores básicos humanos. A lacuna persiste tanto quando a tarefa parece quase trivial quanto quando exige um diálogo de verdade. Não se trata de alguns pontos percentuais, mas de uma diferença qualitativa de confiabilidade.
O pior é quando não há descrição alguma
Os resultados mais baixos foram registrados no cenário em que a formulação inicial do alvo está ausente. O modelo precisa construir por conta própria a hipótese sobre o que procurar, fazer perguntas e, pelas respostas, estreitar a área de busca. Isso já não é sobre reconhecimento, mas sobre comportamento proativo: é preciso decidir sozinho que faltam informações e formular uma consulta que preencha essa lacuna.
É aqui que se manifesta a falha que dá título ao trabalho: olhar o modelo sabe, mas perguntar — não. Ele ou aposta no palpite, ou faz perguntas que não esclarecem nada.
O esclarecimento funciona, mas nem sempre
A interação não é inútil. Quando a pergunta de esclarecimento corrige ou complementa a descrição inicial, a precisão cresce de forma perceptível. Ou seja, o mecanismo de diálogo está presente no modelo e traz benefícios — mas apenas no papel de editor da formulação alheia. Assim que a formulação precisa ser criada do zero, a vantagem desaparece.
Confiança à frente da precisão
Uma linha de análise à parte é a calibração. Os modelos sistematicamente declaram uma confiança superior à que sua precisão factual confirma. Na prática, isso significa que pela resposta do modelo não se pode julgar se vale a pena confiar nele: tanto a escolha correta quanto a incorreta vêm acompanhadas do mesmo tom animado.
Para aplicações, isso é mais perigoso do que simples erros. Se o sistema erra, mas sinaliza honestamente sua incerteza, pode-se perguntar de novo ou chamar uma pessoa. Se ele erra com ar convicto, não é possível embutir essa proteção.
Por que a tarefa é mais difícil do que parece
A orientação visual interativa exige o funcionamento simultâneo de três mecanismos:
- correspondência visual — ligar palavras a objetos na imagem, incluindo relações espaciais e propriedades;
- busca de informação — entender quais dados faltam e obtê-los por meio de uma pergunta, e não por tentativa e erro;
- síntese — reunir respostas dispersas em uma única hipótese e não perdê-la pelo caminho.
Cada habilidade isoladamente existe, em maior ou menor grau, nos modelos atuais. O que quebra é a junção entre elas: o que foi visto não se transforma em pergunta, e a resposta a uma pergunta não reestrutura a visão de mundo.
O que isso significa na prática
Se você está construindo um produto com base em um modelo multimodal — digamos, GPT-4o ou qualquer outra API com suporte a imagens —, as conclusões do trabalho podem ser facilmente traduzidas em soluções de engenharia:
- Não confie na primeira descrição. Se o usuário formula o pedido de forma vaga, preveja um ciclo de esclarecimentos, e não uma única consulta-resposta.
- Não confie na confiança declarada. A calibração é melhor construída sobre sua própria anotação para a tarefa específica, e não sobre a autoavaliação do modelo.
- Projete as perguntas no lugar do modelo. Se o sistema não consegue entender sozinho o que lhe falta, o papel de quem pergunta terá de ser assumido por uma camada externa de lógica.
- Teste com seu próprio déficit de informação. Vale a pena verificar como o pipeline se comporta exatamente nos modos em que, segundo os dados dos autores, a precisão fracassa.
Conclusão
O trabalho registra não a ausência de capacidades, mas a incompatibilidade entre habilidades. Os modelos veem o suficiente para responder a perguntas bem formuladas, mas não compreendem a situação o bastante para formulá-las sozinhos. Enquanto essa lacuna não for fechada, a orientação visual interativa continuará sendo uma tarefa em que o humano segue sendo o elo mais confiável do diálogo.


