
Granite.Trust: um kit de ferramentas que transforma requisitos de segurança de GenAI em políticas operacionais
Uma equipe de pesquisadores da IBM apresentou as ferramentas Granite.Trust: um esquema YAML para descrever conteúdo permitido e proibido nas respostas de modelos generativos, um gerador de dados de treinamento consistentes e um kit de ferramentas complementar. A abordagem permite definir as regras uma única vez e aplicá-las ao longo de todo o ciclo de vida da aplicação — desde o alinhamento do modelo até o controle em tempo de execução.
Por que não existe uma política única para todos
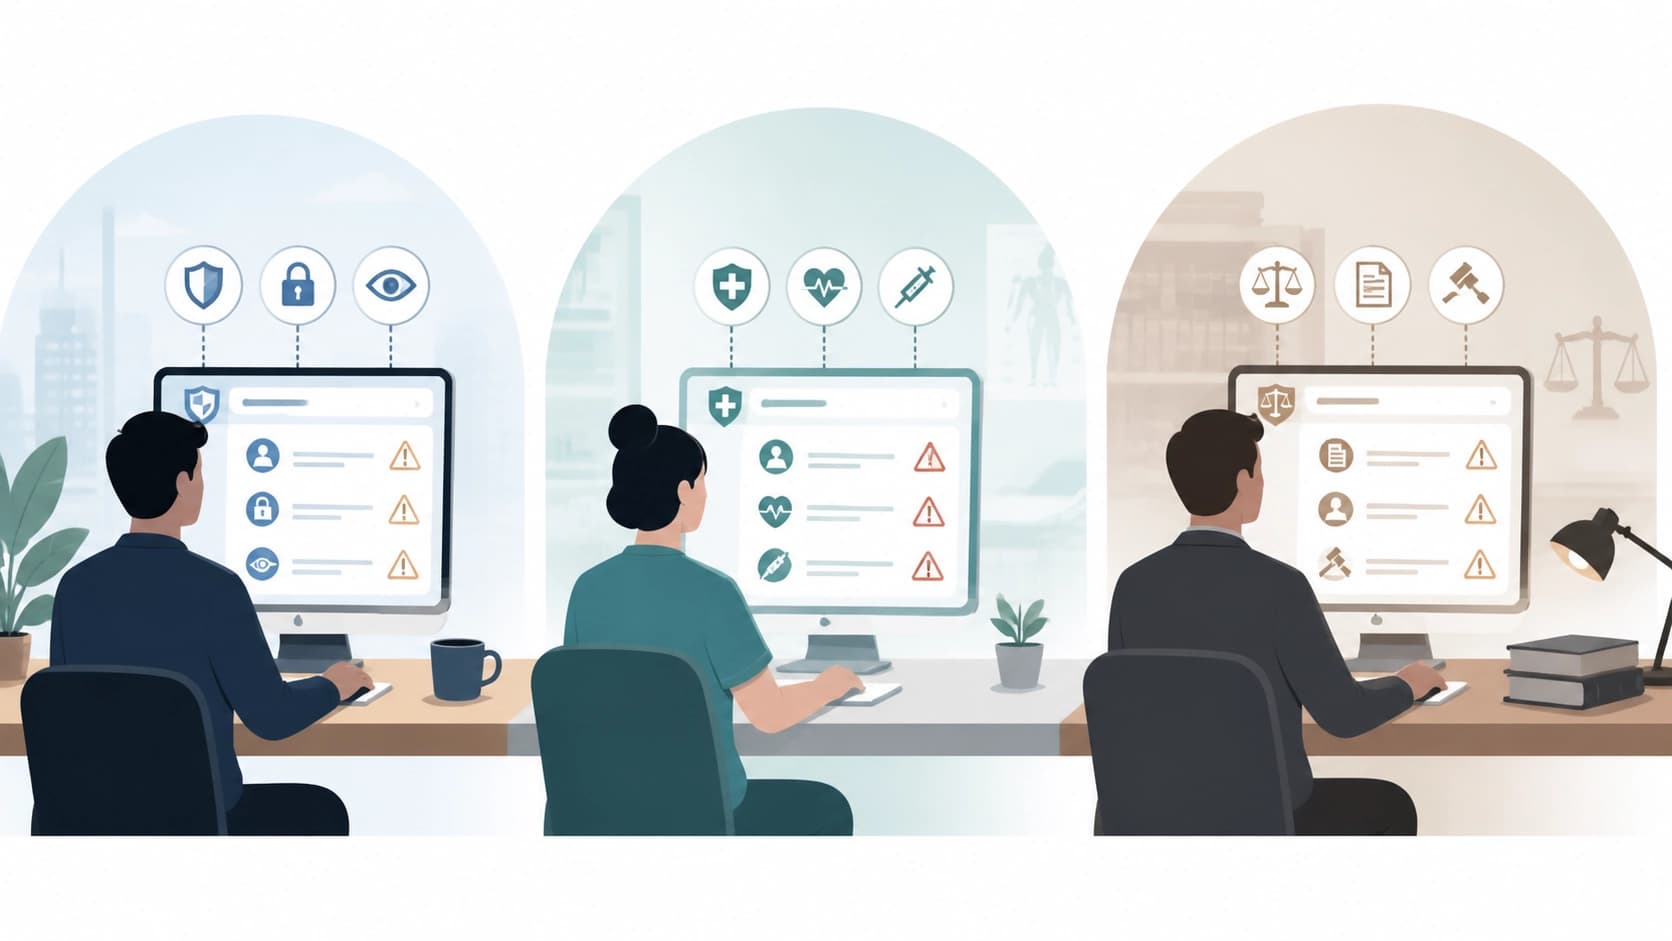
A IA generativa chega a organizações muito diferentes, e o risco de cada uma é próprio. Um banco teme o vazamento de dados de clientes e conselhos financeiros incorretos, uma clínica teme recomendações médicas imprecisas, uma escola teme conteúdo indesejado no diálogo com um adolescente. Some a isso as exigências regulatórias do setor, os valores internos da empresa e quem exatamente está do outro lado do chat: um funcionário comum, um terceirizado ou um usuário externo.
Disso decorre uma conclusão incômoda: um modelo único de segurança para GenAI não funciona. As configurações precisam ser ajustadas para cada cenário específico, e não copiadas de um manual.
O segundo problema é instrumental. Os mecanismos habituais de especificação de políticas cresceram em torno do controle de acesso: eles respondem à pergunta "quem tem acesso a quais recursos". Mas em aplicações com modelos generativos, outra pergunta é muito mais importante — o que pode acabar aparecendo na resposta. Restrições ligadas ao conteúdo são mal descritas em termos de papéis e permissões, e é justamente nessa junção que costuma começar o trabalho manual, que é impossível de escalar.
O que o Granite.Trust propõe
O conjunto de ferramentas é descrito no preprint arXiv:2608.23870, na seção cs.AI. O material foi submetido em 24 de agosto de 2026, e entre os autores estão Nathalie Baracaldo, Nicolas Mello, Kush R. Varshney, Heiko Ludwig, Kate Soule e David Cox, seis pessoas no total. O volume dos arquivos-fonte é de cerca de 2,7 MB, o que, para um artigo com ferramentas, indica uma base de código bastante tangível, e não apenas um conceito.
Os autores apresentam duas coisas principais.
Actionable Policy: a política como documento editável
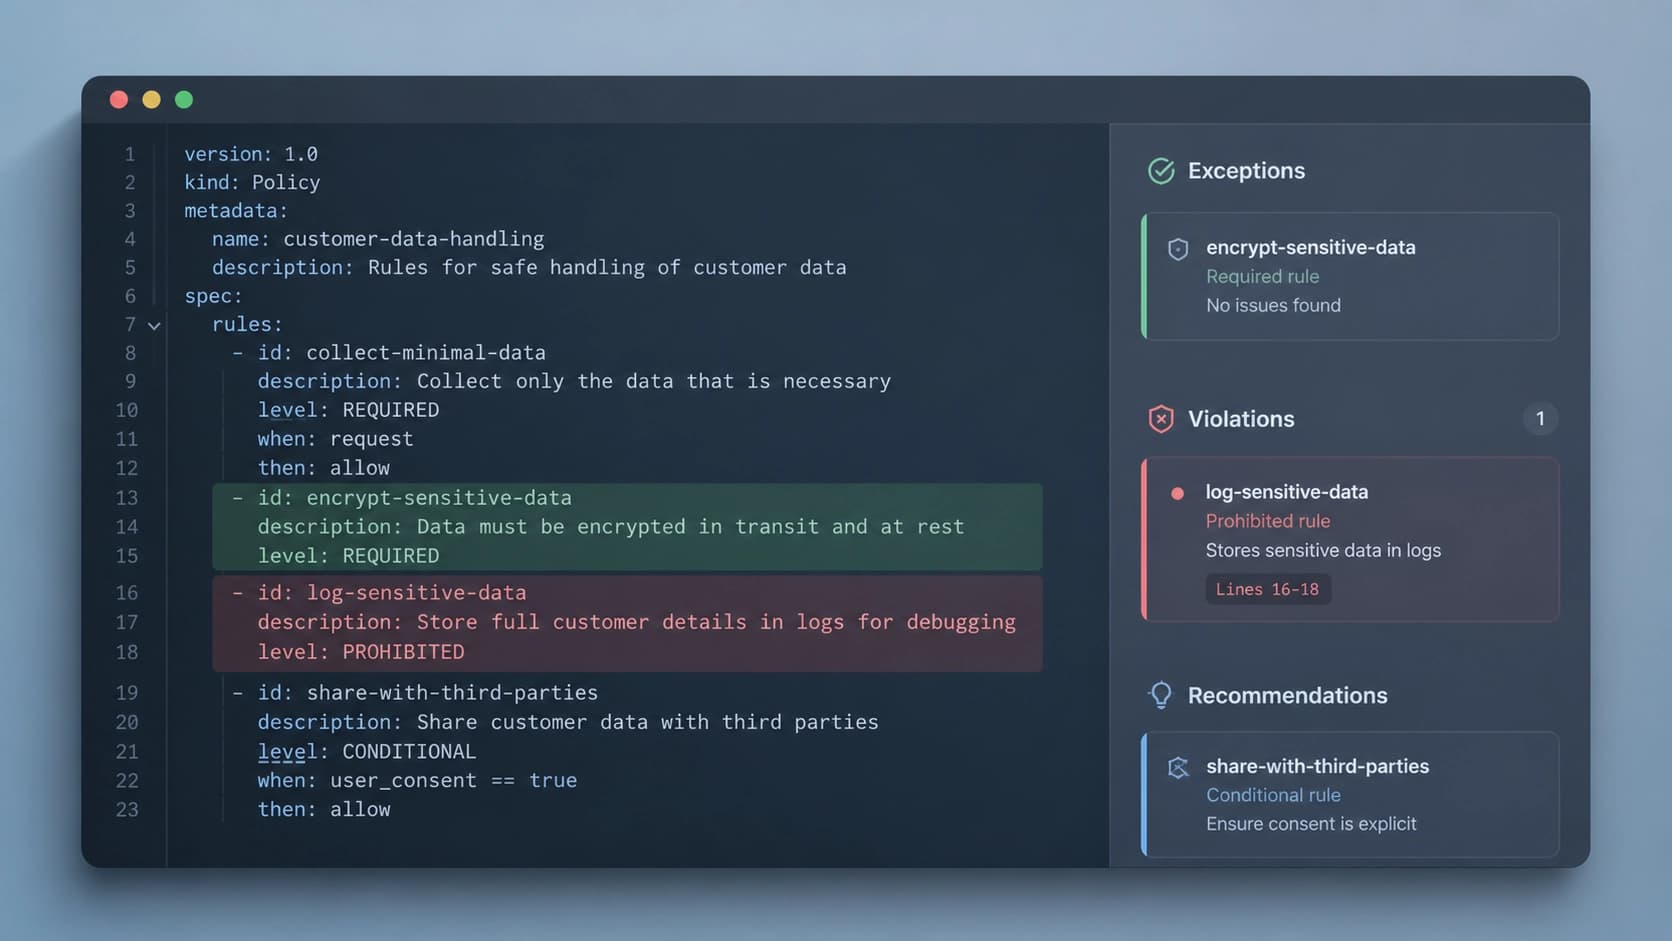
A primeira é o esquema Actionable Policy, um formato baseado em YAML. Não é um "guia de segurança" abstrato, mas uma descrição legível por máquina de quais respostas do modelo são aceitáveis e quais não são. O detalhe-chave é o gerenciamento baseado em exceções: as regras têm ressalvas explícitas, e são justamente elas que permitem rastrear casos de violação da política. Em termos simples, a equipe passa a ter não apenas uma lista de proibições, mas também um mecanismo para entender onde exatamente o modelo saiu dos limites e por quê.
Dados sintéticos para verificar a política
A segunda é o pipeline de geração de dados sintéticos. Ele cria exemplos de treinamento alinhados com a política já descrita, e eles servem a dois propósitos: o alinhamento do modelo e o seu teste. Além disso, há um conjunto de utilitários que ajudam a projetar o próprio esquema e depois a monitorar o cumprimento das regras.
A lógica aqui é sensata: se a política existe separadamente dos dados com os quais o modelo é treinado, ela permanece uma declaração. Mas quando da política surgem automaticamente exemplos de "assim pode" e "assim não pode", os requisitos se transformam em algo verificável.
Definiu uma vez — aplica em todo o ciclo
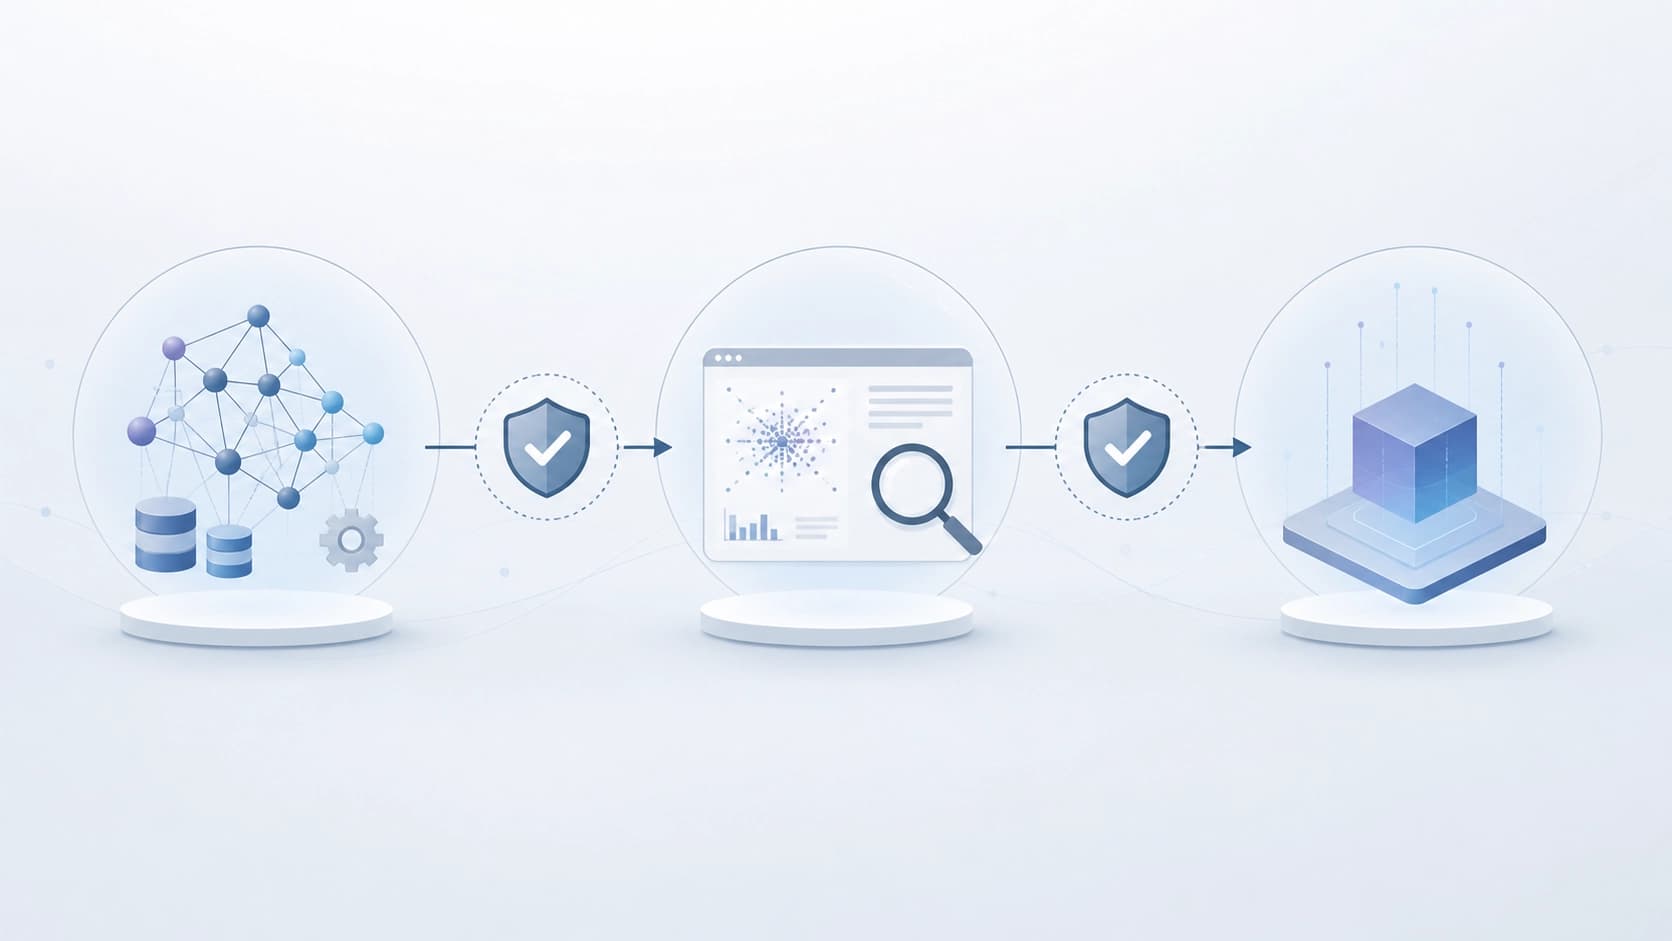
O principal valor prático dessa combinação é que a política deixa de ser um documento de uso único. A organização a formula uma vez e depois a carrega por todo o ciclo de vida da aplicação: desde a etapa de alinhamento do modelo até o monitoramento do produto já em funcionamento.
Isso muda consideravelmente a rotina diária das equipes. Normalmente, os requisitos de segurança vivem em um lugar, os testes em outro, e os logs de produção em um terceiro, e sincronizá-los exige trabalho manual. Aqui, por outro lado, pressupõe-se uma fonte única de regras, da qual dependem tanto o treinamento quanto as verificações antes do lançamento e a observação do tráfego em tempo real.
Vale ressalvar: o conjunto de ferramentas não decide pela organização quais riscos são críticos para ela. Ele oferece uma linguagem para descrever a política e uma infraestrutura para executá-la — mas o conteúdo das regras em si continua sendo tarefa das pessoas que entendem seu produto, seu setor e seu público.
Código aberto e para onde olhar em seguida
O esquema, os exemplos de políticas e as próprias ferramentas estão disponíveis abertamente. Os autores convidam explicitamente a enviar ideias, melhorias e feedback — uma aposta típica desse tipo de projeto: a de que a comunidade encontrará mais rápido cenários que o grupo de pesquisa não alcançou.
O texto completo está disponível em vários formatos: PDF, uma versão HTML experimental e os arquivos-fonte em TeX. O artigo tem um DOI — 10.48550/arXiv.2608.23870 —, então é possível citá-lo em documentos corporativos sem ressalvas sobre um preprint sem identificador.
Se você está justamente tentando traduzir os requisitos internos de GenAI do formato "apresentação para o conselho de administração" para um formato que faça algo no pipeline, este é exatamente o tipo de solução que vale a pena ver de perto. Comece pelos exemplos de políticas: eles mostram bem o quão detalhadamente os autores imaginam restrições reais, e não apenas uma formulação acadêmica do problema.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A confirmação de candidatos é mais cara do que a sua geração: iscas contra a busca de vulnerabilidades por LLM
O trabalho analisa a assimetria de custos na busca agentiva por defeitos: gerar variantes é barato, mas confirmá-las por meio de análise de alcançabilidade, execução e PoC exige a maior parte do orçamento; por isso, a verificação pode tornar-se um alvo de defesa por si só. O RedHerring proposto — iscas adaptadas ao repositório, com certificado selado — reduziu, com custos iguais, o número de vulnerabilidades reais encontradas em 38,7–60,4% em 33 projetos do OSS-Fuzz; mesmo após alertar o agente, a redução manteve-se em 37,2%.
9 novembro 2026
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026