
Onde termina a transferência: escala dos dados, diversidade de mundos e tamanho do modelo para agentes de jogos
Em 120 configurações, foi verificado se as vantagens do pré-treino prolongado se mantêm na transição entre ambientes virtuais com gráficos, física, controles e tarefas diferentes. O aumento do corpus ajuda em mundos já dominados, a variedade amplia a transferência para ambientes semelhantes e o aumento do modelo melhora o aproveitamento dos dados, mas, quando o treinamento ocorre em um único mundo, prejudica a adaptação a mundos muito diferentes; os autores concluem que a preparação prévia, por si só, não é suficiente para agentes universais.
O que foi avaliado e como foi medido o transfer
O estudo dedica-se ao pré-treino contínuo (CPT) de agentes incorporados em mundos virtuais. Os autores avaliaram se as melhorias decorrentes do aumento da escala dos dados, da sua diversidade e do tamanho do modelo se transferem. O trabalho abrange 120 configurações de treino.
| Fator | O que foi variado |
|---|---|
| Tamanho do modelo | quatro valores, de 0.8B a 27B |
| Volume de dados | seis valores, de 50 a 1 600 horas |
| Mistura de dados | cinco variantes: de dados de um único mundo a corpora diversificados de vários mundos |
| Avaliação | perdas de validação em três níveis e benchmarks de jogos |
A avaliação decorre em três níveis: mundos incluídos no treino, mundos relacionados e mundos nunca vistos. Esta conceção permite distinguir os ganhos em ambientes conhecidos do transfer. Critério prático: incluir os três grupos de mundos na validação. Caso contrário, o crescimento nos mundos de treino ocultará a diferença nos mundos distantes.
Volume de dados: efeito em mundos conhecidos
O aumento do volume de dados melhora o desempenho nos mundos incluídos nos dados de treino. Este é um efeito de escala confirmado em territórios conhecidos. Para os mundos distantes, os autores não reduzem o transfer a um único volume de dados.
O volume de dados não é uma alavanca universal para qualquer objetivo. Proporciona um ganho claro quando o mundo já está representado no treino. Para um mundo novo, é necessário verificar separadamente que parte da diferença o volume consegue compensar.
Critérios de escolha:
- o mundo-alvo está incluído no treino — aumentar o volume de dados;
- o mundo-alvo é distante — não depender apenas do volume;
- a composição dos mundos não é clara — começar por separar os mundos por proximidade.
Diversidade: transfer para mundos relacionados, mas não para mundos distantes
A diversidade dos dados melhora o transfer para mundos relacionados. Nos mundos distantes, o ganho é limitado. Este efeito distingue a diversidade do simples aumento do volume.
| Grau de proximidade do mundo | Efeito observado da diversidade | Conclusão prática |
|---|---|---|
| Mundos relacionados | melhora o transfer | uma mistura diversificada justifica-se |
| Mundos distantes | ganho limitado | a diversidade, por si só, não é suficiente |
A diversidade alarga a zona de transfer, mas não torna o agente universal. A mistura de dados funciona como uma ponte para mundos semelhantes. Para os mundos distantes, essa ponte é mais curta do que o necessário.
Critério prático: avaliar a proximidade dos mundos-alvo em relação aos mundos de treino. Para mundos relacionados, uma mistura diversificada é uma ferramenta eficaz. Para mundos distantes, a diversidade não é suficiente.
Tamanho do modelo: eficiência dos dados e risco de generalização restrita
O aumento do tamanho do modelo melhora a eficiência na utilização dos dados. Quando o treino é feito num único mundo, o tamanho do modelo prejudica a generalização para mundos distantes. Assim, o efeito do tamanho depende da composição dos dados.
Um modelo maior utiliza melhor os dados disponíveis. Mas, com um treino restrito, limita o transfer. O mesmo aumento de parâmetros produz efeitos diferentes consoante a mistura de mundos.
Critérios de escolha:
- treino num único mundo — não esperar que o tamanho do modelo aumente o transfer;
- dados diversificados — o tamanho do modelo reforça a utilização dos dados;
- escolha do tamanho — considerar sempre em conjunto com a escolha da mistura.
Duas fases de treino: interface e mundo
Os autores observam uma fase inicial de interface (early interface phase). Nesta fase, o modelo obtém vantagens amplas em diferentes mundos. Mais tarde, surge a fase posterior do mundo (later world phase). Nela, as melhorias restringem-se aos mundos de treino e aos mundos relacionados.
As fases correspondem a diferentes amplitudes de transfer. A fase inicial forma uma interface geral para diferentes mundos. A fase posterior associa as melhorias a ambientes conhecidos e próximos. Não se trata de um erro de treino, mas de uma mudança na zona de aplicação.
Critérios de escolha:
- é necessária uma interface ampla — fase inicial;
- é necessário um mundo-alvo — fase posterior;
- são necessários mundos distantes — a fase inicial não mantém o transfer.
Limites do pré-treino contínuo
Os autores assinalam as limitações do treino por imitação e a persistência de uma diferença nos mundos distantes. Na sua conclusão, agentes incorporados universais exigem etapas de treino mais substanciais, para além do CPT. O CPT proporciona resultados competitivos, mas não cobre todos os níveis de transfer.
Os modelos do estudo são competitivos face a modelos especializados para mundos 3D de jogos e a modelos de fronteira. Apresentam os melhores resultados em tempo real. Estes resultados não eliminam a diferença nos mundos distantes. Delimitam o âmbito de aplicação do CPT.
Critérios de escolha:
- agente universal — planear etapas para além do CPT;
- mundos distantes — não considerar o CPT uma solução final;
- mundos próximos dos mundos de treino — o CPT continua a ser uma etapa eficaz.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
SpecEvo: alinhamento de LLM leves e avançados para reduzir o custo da busca evolutiva
O framework SpecEvo redistribui a pesquisa evolutiva: os candidatos comuns refinam modelos económicos, enquanto os mais poderosos só são acionados em pontos de controlo estratégicos, com base no histórico de sucessos e impasses. Em experiências com 176 tarefas, esta abordagem permitiu igualar ou superar alternativas mais dispendiosas, reduzindo os custos de API em 80%.
21 novembro 2026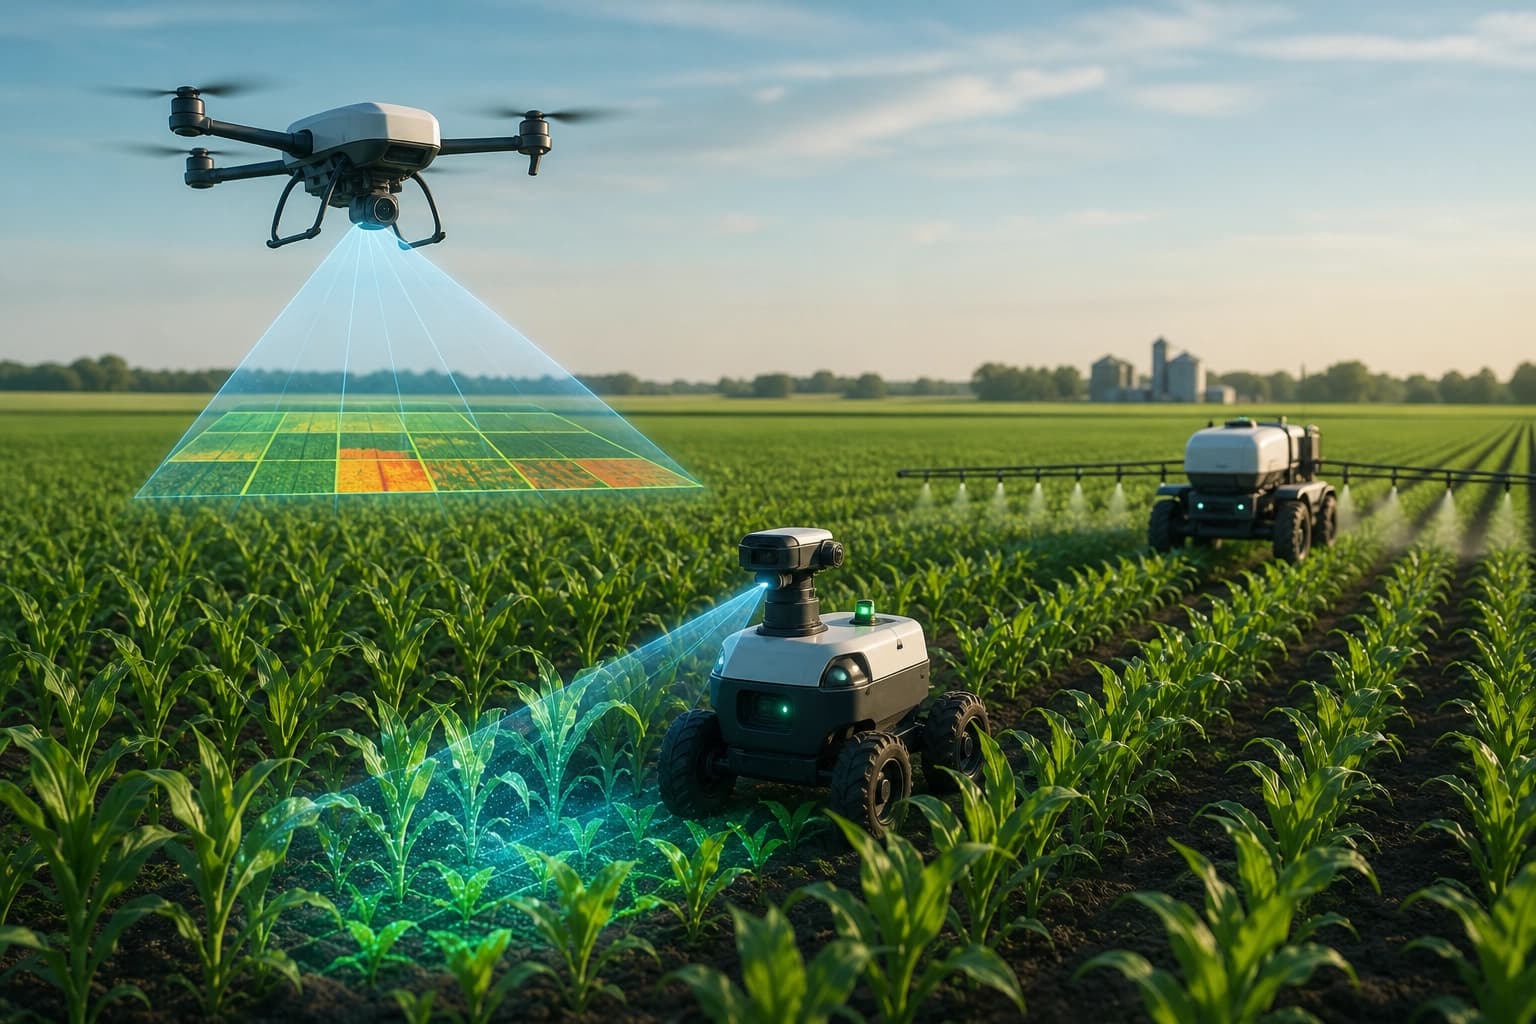
Algoritmos e robôs no campo: intervenções localizadas e monitorização das culturas
O artigo mostra como dados de sensores, imagens aéreas e plataformas automatizadas permitem detetar ameaças numa fase inicial, direcionar o tratamento apenas para as zonas problemáticas e aperfeiçoar as previsões de colheita. Também aborda os obstáculos à adoção — o custo do equipamento, a fiabilidade dos dados, a formação do pessoal e o acesso à conectividade.
21 novembro 2026
Fig: intervenções em jogos controladas para testar o comportamento social de agentes de IA
Fig recebe uma descrição em linguagem natural do comportamento pretendido, divide-o em variantes e altera deliberadamente as condições do jogo para induzir as ações desejadas nos modelos. Em cenários válidos para seis padrões sociais, as intervenções aumentaram em 10,9% a proporção média de tentativas do comportamento-alvo em relação aos grupos de controlo, e os autores propõem considerar ambientes multiagente como uma plataforma configurável para avaliação reprodutível.
21 novembro 2026