
Sistema composto de IA multiagente com ciclo de evidências para o planejamento de prótons em tumores de cabeça e pescoço
O trabalho descreve a combinação de uma política PPO treinada, que gera várias opções de plano, e de agentes LLM que conduzem um diálogo de refinamento com verificação de métricas clínicas e restrições; com base em 21 pacientes, a Qwen3-14B ajustada seguiu melhor as instruções e ajudou a deslocar a relação de compromisso a favor dos objetivos prioritários. A conclusão prática é que o planeamento DRL automatizado pode ser complementado por um diálogo orientado, mantendo o controlo sobre restrições concorrentes.
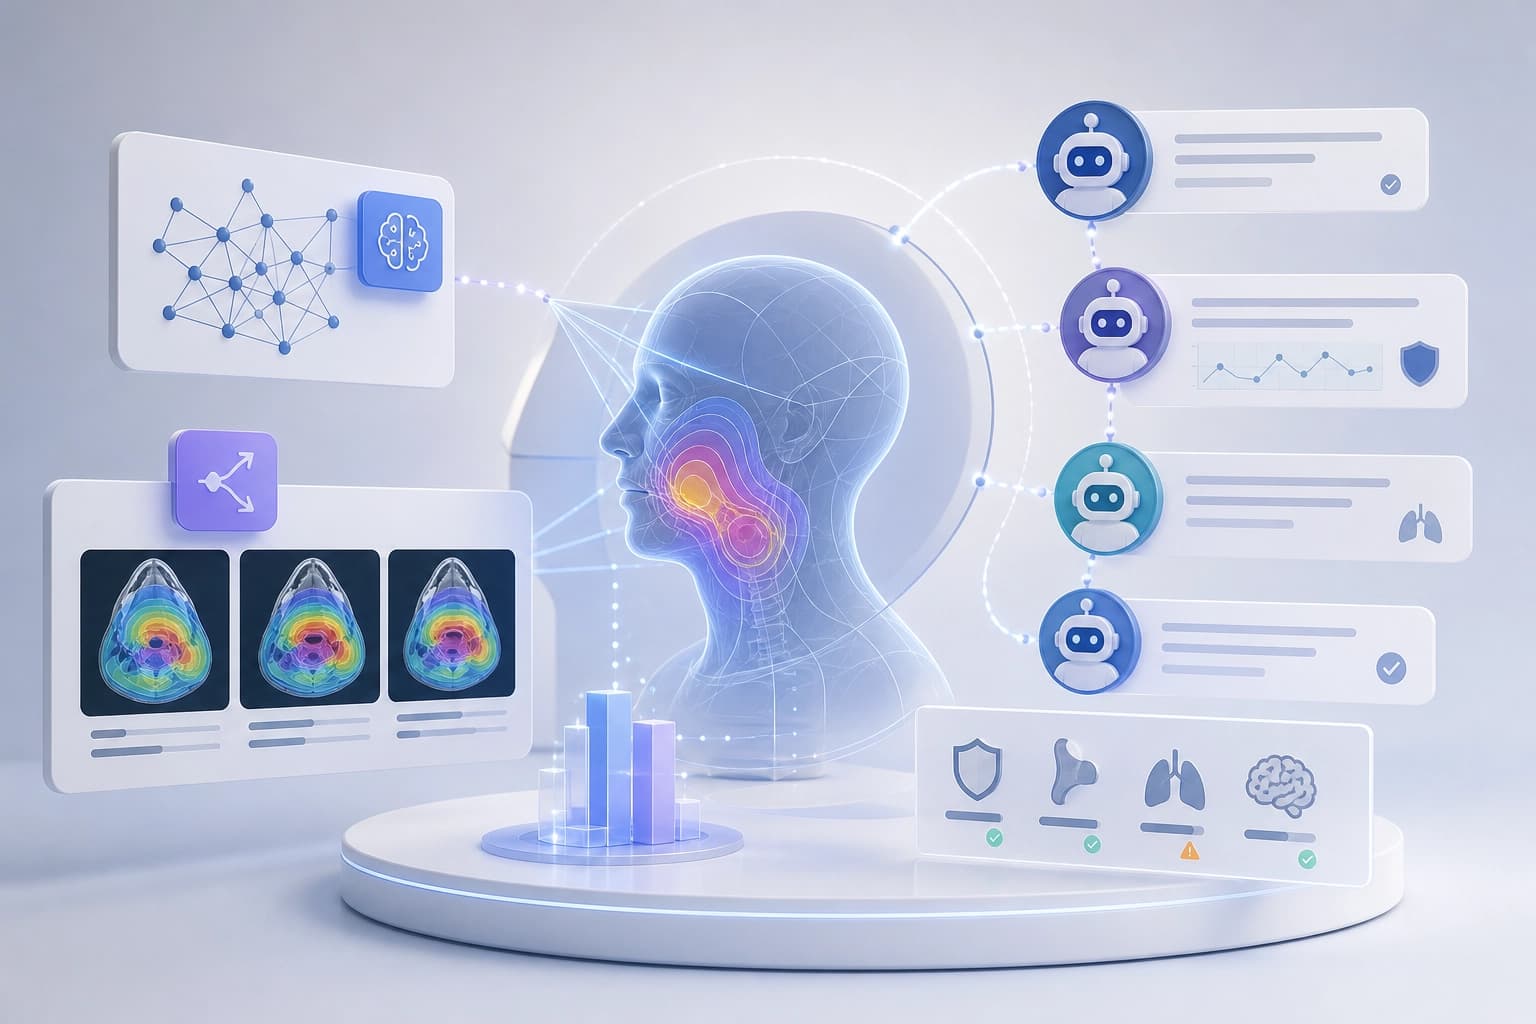
Arquitetura composta: geração e refinamento
Qingqing Wang, Liqiang Xiao e Chang Chang publicaram um artigo no arXiv em 21 out. 2026 (arXiv:2610.29010). Nele, descreveram um sistema para terapia protónica PBS no cancro da cabeça e do pescoço. O sistema combina o planeamento automático baseado em DRL com o refinamento de planos através de diálogo com um LLM.
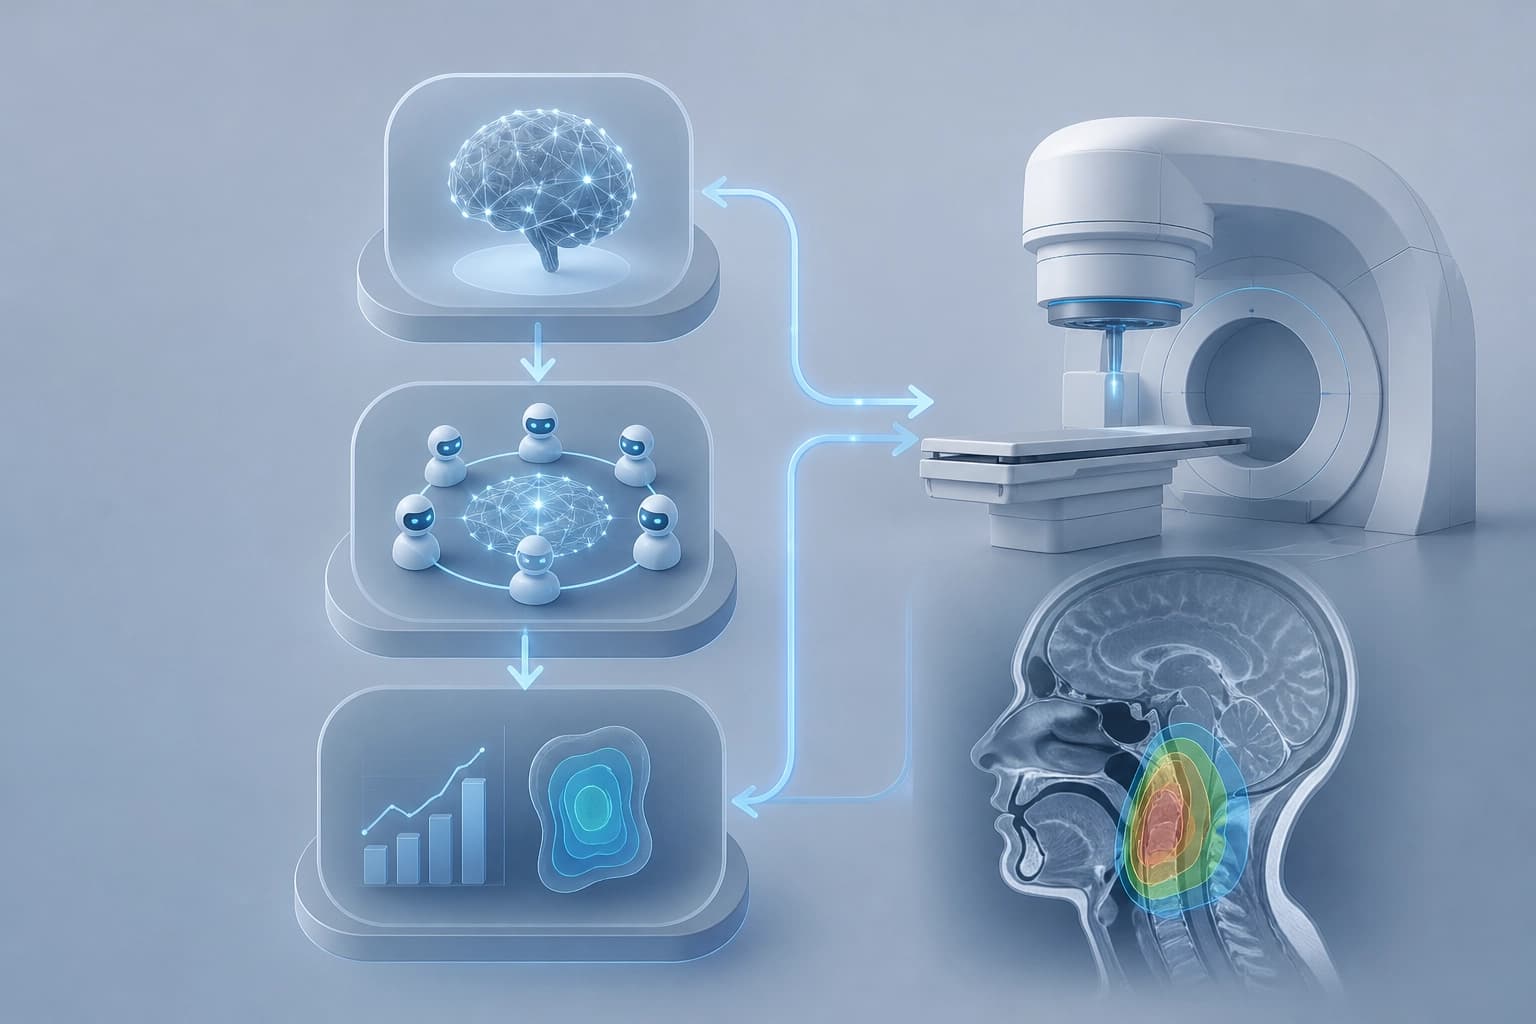
A etapa automática baseada em DRL cria um conjunto de planos. O sistema seleciona um plano como alvo e utiliza os restantes como referência durante o refinamento. Para casos complexos, o sistema prevê uma arquitetura multiagente com LLM, que refina o plano através de diálogo em linguagem natural. Conclusão: o modelo separa a geração automática do refinamento por diálogo apoiado em dados.
Geração automática de planos com PPO
A etapa automática baseia-se numa rede de políticas PPO. Os autores treinaram a rede sem intervenção humana; primeiro, esta gera vários planos. A formação e a avaliação foram realizadas com dados de 21 pacientes com cancro da cabeça e do pescoço. Para cada paciente, os autores geraram 5 planos PPO.
Um conjunto de vários planos fornece opções para selecionar o plano alvo e uma base de referência para o refinamento. Critério: a geração automática deve produzir não apenas um plano, mas um conjunto. Assim, o circuito de refinamento terá uma base de apoio.
Circuito multiagente de refinamento
Para casos complexos, o sistema utiliza uma arquitetura multiagente com LLM. Esta refina o plano através de interação em linguagem natural. O circuito inclui um agente de planeamento, um chatbot e um agente de avaliação.
O agente de planeamento propõe ajustes com base nos dados. O chatbot funciona como interface única de diálogo. O agente de avaliação cria um circuito de evidências: extrai métricas clínicas e identifica violações de restrições.
Este circuito permite verificar o refinamento através de métricas clínicas e restrições. Critério: o refinamento deve basear-se em indicadores clínicos mensuráveis, e não apenas no texto do diálogo.
Formação do agente de planeamento
O agente de planeamento funciona com base no Qwen3-14B. Justifica as recomendações com dados dos planos criados anteriormente. Para formação adicional em tarefas específicas, os autores aplicaram SFT e GRPO.
Em comparação com o LLM de base, o Qwen3-14B afinado demonstrou capacidades superiores. Segue melhor as instruções, extrai informação e raciocina no domínio específico.
| Critério | LLM de base | Qwen3-14B afinado |
|---|---|---|
| Seguimento de instruções | Capacidade básica | Capacidade melhorada |
| Extração de informação | Capacidade básica | Capacidade melhorada |
| Raciocínio no domínio específico | Capacidade básica | Capacidade melhorada |
Critério prático: para o agente de planeamento, não basta gerar; também é importante seguir instruções, extrair dados e raciocinar no domínio específico. A formação com SFT e GRPO reforça estas qualidades.
Avaliação e compromissos clínicos
Os autores selecionaram 50 planos para refinamento com instruções. Os ajustes melhoraram de forma mais eficaz os objetivos prioritários para o utilizador. Ao mesmo tempo, a deterioração de objetivos concorrentes manteve-se limitada. Os autores relatam que os ajustes permitiram obter compromissos mais adequados do ponto de vista clínico ao refinar planos tendo em conta cada paciente.
Critério prático: avaliar o refinamento pela melhoria dos objetivos prioritários e pela deterioração limitada dos objetivos concorrentes.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Seleção computacional em vez de tentativa e erro empírica: novas abordagens aos materiais para baterias
O material mostra como bases de cálculo, aprendizagem automática e modelos generativos reduzem o leque de composições promissoras, enquanto laboratórios automatizados aceleram a sua validação; ainda assim, o resultado depende da síntese e dos ensaios, nos quais as previsões podem divergir da condutividade real.
20 novembro 2026
A evolução dos benchmarks de agentes com o aumento do conjunto de tarefas: o papel da seleção de evidências e das corridas sequenciais
O trabalho explica por que aumentar o número de tarefas pode prejudicar a evolução de ambientes de agentes: a causa é a seleção inadequada de evidências, e não o volume de dados em si. O método Successive Scale Racing seleciona, de forma alternada, combinações diversificadas de tarefas e compara os candidatos a baixo custo; em três benchmarks, isso aumentou a taxa de execuções bem-sucedidas quando o conjunto cresceu de 40 para 200 tarefas, enquanto os métodos de referência tiveram desempenho pior, e o número de execuções de validação caiu cerca de 60%.
19 novembro 2026
Persuasão mútua entre modelos: as posições declaradas não correspondem ao comportamento no diálogo
Em debates controlados sobre as causas das alterações climáticas, quatro pares de GPT-6 Luna e Gemini 2.5 Flash Lite demonstram dinâmicas distintas de convergência ou divergência de posições. A instrução direta para persuadir não produz um efeito duradouro, e a posição declarada e o estilo de argumentação não refletem a mesma coisa.
19 novembro 2026