
A avaliação de agentes de busca costuma se basear em cenários cuidadosamente definidos: falas previamente conhecidas, consultas previsíveis, um único usuário "médio". Essa abordagem é conveniente de medir, mas reflete mal a realidade, em que, por trás da mesma interface, estão pessoas com ritmos, estilos e paciência completamente diferentes. O trabalho AgentWorld: Personality-Aware Reliability Evaluation for Agentic Information Retrieval (arXiv:2608.24076, aceito no workshop Agent4IR @ KDD 2026) propõe olhar para a confiabilidade do agente de outra forma — por meio do caráter do interlocutor e das tentativas de quebrar esse caráter.
De scripts a personalidades: onde está a lacuna
O benchmark clássico para busca agêntica responde à pergunta "o agente resolveu a tarefa". Mas ele silencia sobre o que acontece entre os passos e quase nada diz sobre a dispersão dos resultados. Se todos os usuários no teste se comportam da mesma forma e os ataques ao sistema não são modelados de modo algum, as conclusões também saem estéreis: com essa medição é impossível entender onde exatamente o agente começa a tropeçar.
É justamente essa lacuna que os autores — Gunja Agarwal, Arup Kumar Das, Arun Menon, Jitesh Chandra Mishra e Vignesh Divakaran — tentam fechar. Sua ideia central é simples: a dispersão do comportamento dos usuários não deve ser suavizada, mas transformada em um instrumento de medição à parte.
O que é o AgentWorld
O AgentWorld é um simulador, não um mecanismo de busca separado. Ele não resolve tarefas no lugar do agente, mas cria um ambiente no qual o agente pode ser testado em diferentes cenários e com diferentes tipos de interlocutores, registrando não apenas a resposta final, mas também a trajetória para obtê-la.
Quatro blocos de sustentação
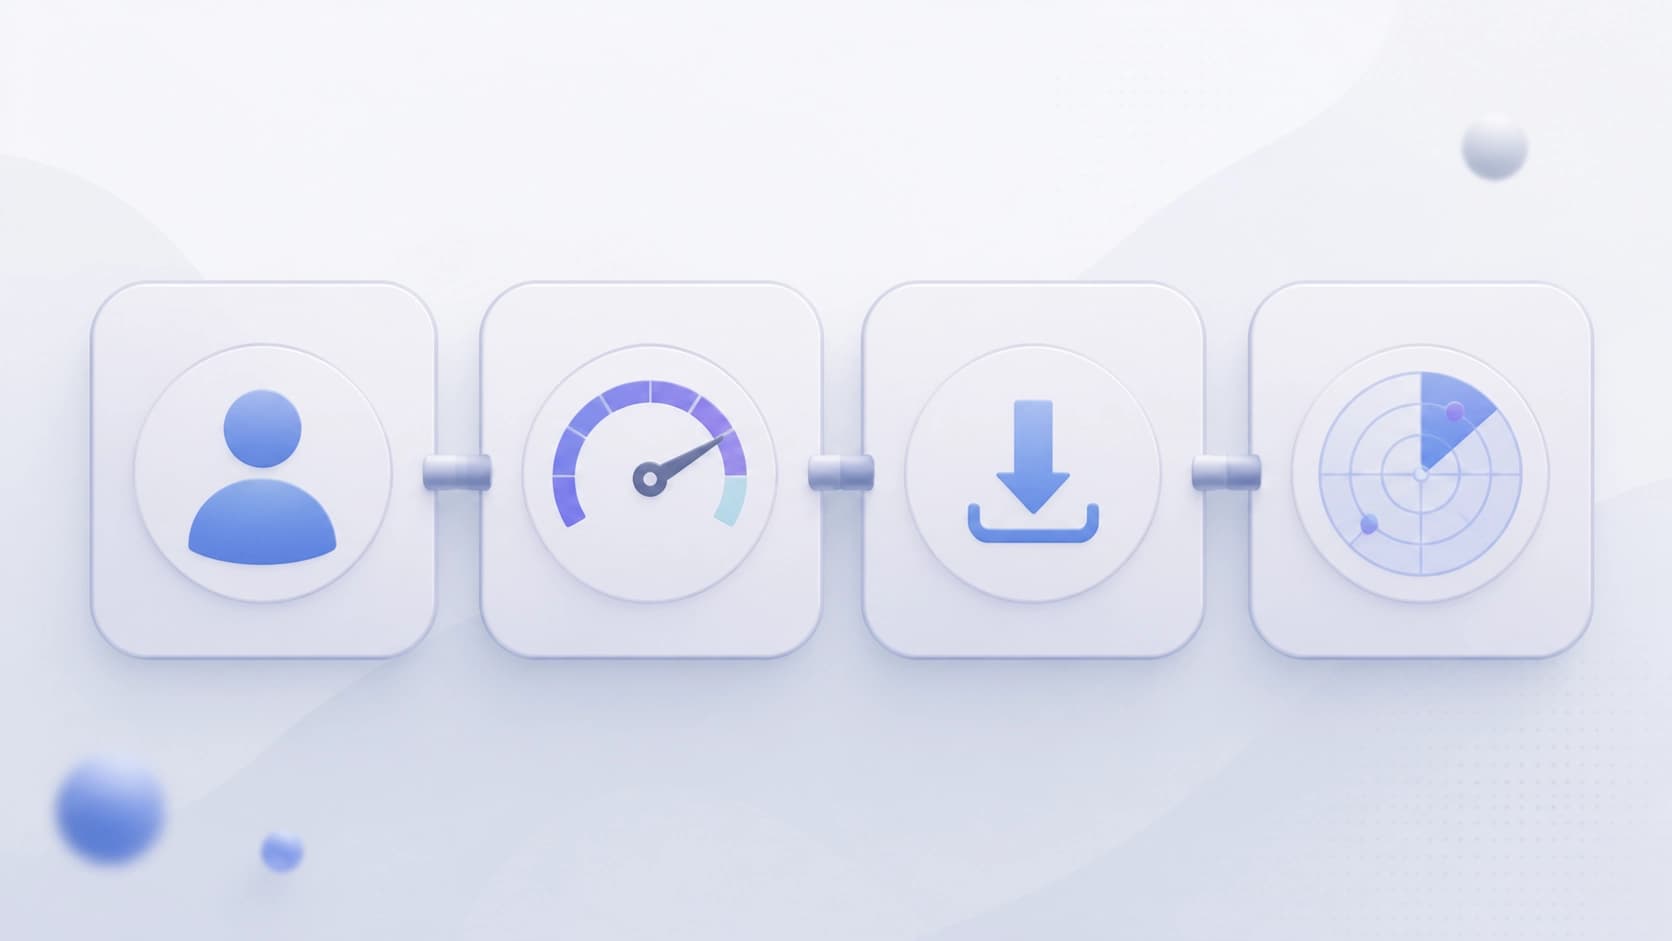
- Modelos de usuários segundo o Big Five. As personas são definidas pelo modelo dos cinco fatores (também chamado de OCEAN), e não operam no vácuo: cada usuário tem seu próprio estado e seu próprio conjunto de ferramentas disponíveis, e esses estados mudam ao longo do diálogo.
- Métrica de consistência pass^k. Não é apenas "quantas vezes deu certo". Ao lado dela há uma classificação estrutural de falhas, pontuação parcial para progresso incompleto, mas significativo, e verificação dupla da transferência de controle — ou seja, verifica-se separadamente se o agente transferiu corretamente o turno para uma pessoa ou outro sistema.
- Exportação de dados para ajuste fino. O simulador consegue exportar as execuções acumuladas, descartando as de avaliação fraca, em seis formatos adequados para fine-tuning.
- Risk Analyser adversário. Esse módulo captura instantâneos dos "arcabouços" de estados intermediários pelos quais o agente é obrigado a passar e, em seguida, ramifica as execuções pelo método de Monte Carlo segundo quatro tipos de perturbações vinculadas à tarefa específica. O risco final é calculado pela razão ΔP / ΔT, pela fusão de evidências de Dempster—Shafer e pela atribuição de categorias de ataques por Shapley.
Observe a lógica: os três primeiros blocos tratam de medição e aprendizado, o quarto trata de previsão de falhas. O framework é concebido desde o início como uma ferramenta não apenas de diagnóstico, mas também de teste de estresse.
Três execuções: da análise ao ataque adversário
A parte experimental consiste em três partes com graus diferentes de "carga".
- Agente analítico conversacional foi executado contra dez personas OCEAN. Para a anotação de qualidade, foram coletadas 240 avaliações de juízes.
- Agente de suporte ao cliente foi testado em cinco tarefas, cada uma em quatro variantes de persona.
- Teste de estresse adversário das mesmas cinco tarefas: aqui foram adicionadas perturbações para ver com que rapidez as trajetórias desmoronam.
A terceira execução foi a mais reveladora. Mesmo na ausência de perturbações, a estabilidade mínima da trajetória foi de V_min = 0.375 — ou seja, até as condições "limpas" não oferecem margem de segurança. E quando os ataques foram ativados, descobriu-se que os golpes mais perigosos não são contra o conteúdo da consulta, mas contra as ferramentas e a infraestrutura: a atribuição por Shapley concede ao nível sistêmico cerca de 46%, e ao nível das ações, aproximadamente 38%.
Trata-se de uma mudança importante de ênfase. A discussão sobre a segurança de agentes costuma se resumir a injeções de prompt no texto, enquanto os números indicam que o risco principal vive na camada responsável pelas chamadas de ferramentas e por seu estado.
O caráter como fonte de divergências
O mais interessante no artigo não são as avaliações absolutas, mas a dispersão entre as personas. Na mesma tarefa, a taxa de sucesso variou radicalmente: 50% contra 100%. Isso não é ruído de medição, mas um sinal de que o agente lida de formas diferentes com estilos distintos de comunicação.
São listados separadamente os modos de falha que o teste unificado simplesmente não mostra:
- vazamentos entre domínios — quando o contexto de uma tarefa transborda para outra;
- deriva de contexto — o deslocamento gradual do tema e dos objetivos ao longo de um diálogo longo;
- diferença de qualidade entre personas de 0.27 ponto.
Os autores destacam que o Risk Analyser consegue medir a fragilidade no nível da trajetória — ali onde a métrica isolada pass^k é impotente, porque ela registra apenas o fato do sucesso ou do fracasso e não distingue "quebrou no primeiro passo" de "chegou quase até o fim, mas não manteve o estado".
Para que isso serve na prática
Se encararmos as conclusões como uma receita, ela é assim: teste o agente não com um único usuário "médio", mas com um conjunto de caráteres, e olhe para a dispersão entre eles, não para a média. A pontuação média pode ser bastante razoável enquanto metade das personas falha consistentemente no cenário.
A segunda camada prática são os dados. Já que o simulador consegue marcar execuções bem-sucedidas e malsucedidas e exportá-las em formatos prontos, as personalidades se tornam não apenas um teste, mas também uma fonte de material de treinamento. O ponto fraco aqui é óbvio: a qualidade desse conjunto de dados depende inteiramente da qualidade da anotação, e as avaliações dos juízes são a parte mais cara e subjetiva do processo.
Por fim, a terceira camada são as prioridades na proteção. Já que a maior parte do risco recai sobre o nível sistêmico e as ações, e não sobre as formulações, é preciso reforçar em primeiro lugar os direitos de acesso, a verificação das chamadas e a correção da transferência de controle, e não apenas os filtros no texto de entrada.
O que vale ter em mente
Vale lembrar da escala: trata-se de três conjuntos de experimentos, dez personas em um deles e cinco tarefas nos outros dois. Números como 50% contra 100% parecem dramáticos, mas se baseiam em uma amostra pequena — é mais uma indicação de direção do que um veredito final. Além disso, a simulação de usuário pelo Big Five inevitavelmente simplifica o caráter real: uma pessoa viva é inconsistente, enquanto a persona no simulador segue, afinal, o perfil definido.
Ainda assim, a ideia metodológica parece sólida e transferível. A confiabilidade do agente não é um único número, mas uma distribuição por tipos de interlocutores e por tipos de falhas. O simulador AgentWorld dá o primeiro passo sério para que essa distribuição possa ser medida, e não adivinhada.
A versão v1 do artigo surgiu em 25 de agosto de 2026, a atual v2 é de 26 de agosto de 2026 (volume de 1,710 KB); DOI — 10.48550/arXiv.2608.24076, área — cs.AI.


