
SpecEvo: menyelaraskan LLM ringan dan canggih untuk menekan biaya pencarian evolusioner
Framework SpecEvo mendistribusikan ulang pencarian evolusioner: kandidat biasa menyempurnakan model berbiaya rendah, sementara model yang lebih kuat hanya dilibatkan pada titik pemeriksaan strategis dengan mengacu pada riwayat keberhasilan dan jalan buntu. Dalam eksperimen pada 176 tugas, pendekatan ini mampu menyamai atau melampaui alternatif yang lebih mahal, sekaligus mengurangi biaya API sebesar 80%.
Tujuan dan fungsi
SpecEvo (Speculative Evolution) adalah kerangka kerja multi-LLM untuk penemuan ilmiah. Kerangka ini mengoordinasikan model ringan dan canggih untuk menekan biaya pencarian program kandidat. Makalah arXiv:2610.28706 diajukan pada 20 Oktober 2026. Penulisnya adalah Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, dan Min-Yen Kan.
Karakteristik utama:
- jenis: kerangka kerja multi-LLM;
- tujuan: penemuan ilmiah dan pencarian algoritmik;
- prinsip: koordinasi model ringan dan canggih;
- makalah: arXiv:2610.28706, diajukan pada 20 Oktober 2026;
- penulis: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan.
Kriteria praktis: pertimbangkan kerangka kerja ini untuk tugas yang mengutamakan biaya API dan membutuhkan pencarian program kandidat dengan tahap pemeriksaan yang jarang.
Arsitektur: peran model ringan dan canggih
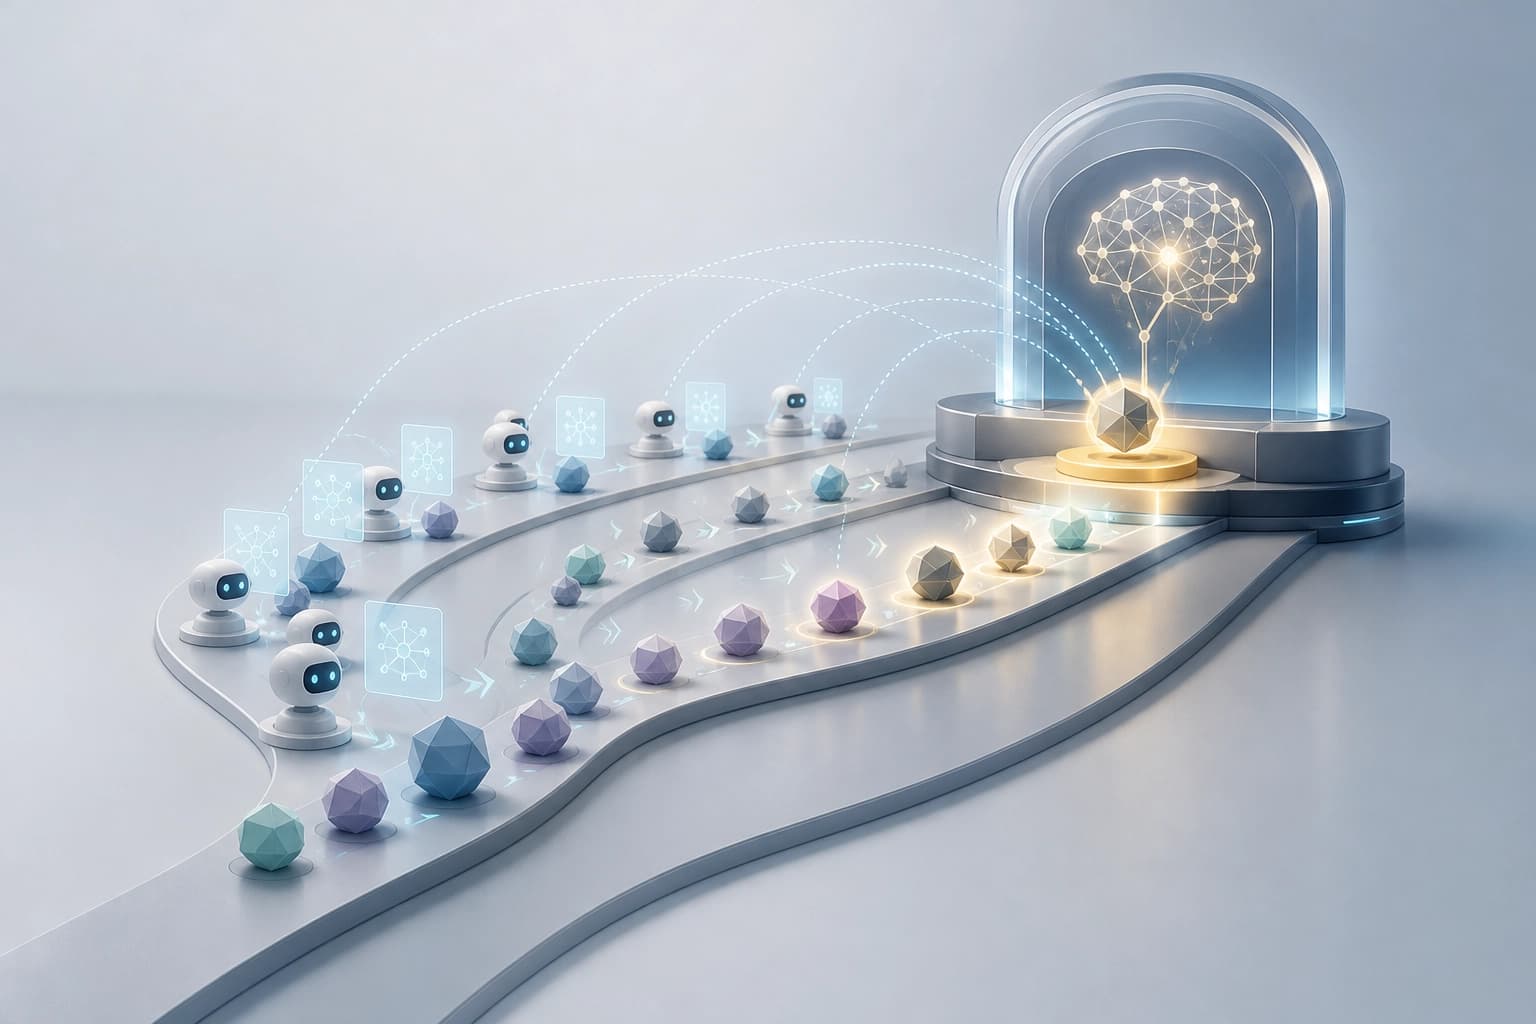
SpecEvo membagi pekerjaan di antara model ringan dan canggih. Model ringan menjalankan fungsi paralel sebagai Speculators dan Advisor. Model canggih bekerja sebagai Navigator pada tahap pemeriksaan yang jarang.
| Komponen | Jenis model | Fungsi | Mode operasi | | Speculators | ringan | menghasilkan dan menyempurnakan program kandidat | secara paralel | | Advisor | ringan | merangkum keberhasilan, kegagalan, dan arah yang sudah jenuh; mengubahnya menjadi rekomendasi tetap | merangkum informasi yang terkumpul | | Navigator | canggih | mempelajari populasi yang berkembang; melakukan intervensi melalui sintesis, penyempurnaan terarah, atau perubahan kerangka pencarian | jarang, pada tahap pemeriksaan |
Kriteria praktis: serahkan pencarian rutin dan perangkuman bukti kepada model ringan, lalu gunakan model canggih untuk intervensi strategis.
Alur kerja “berhipotesis dahulu, lalu mengonsolidasikan”
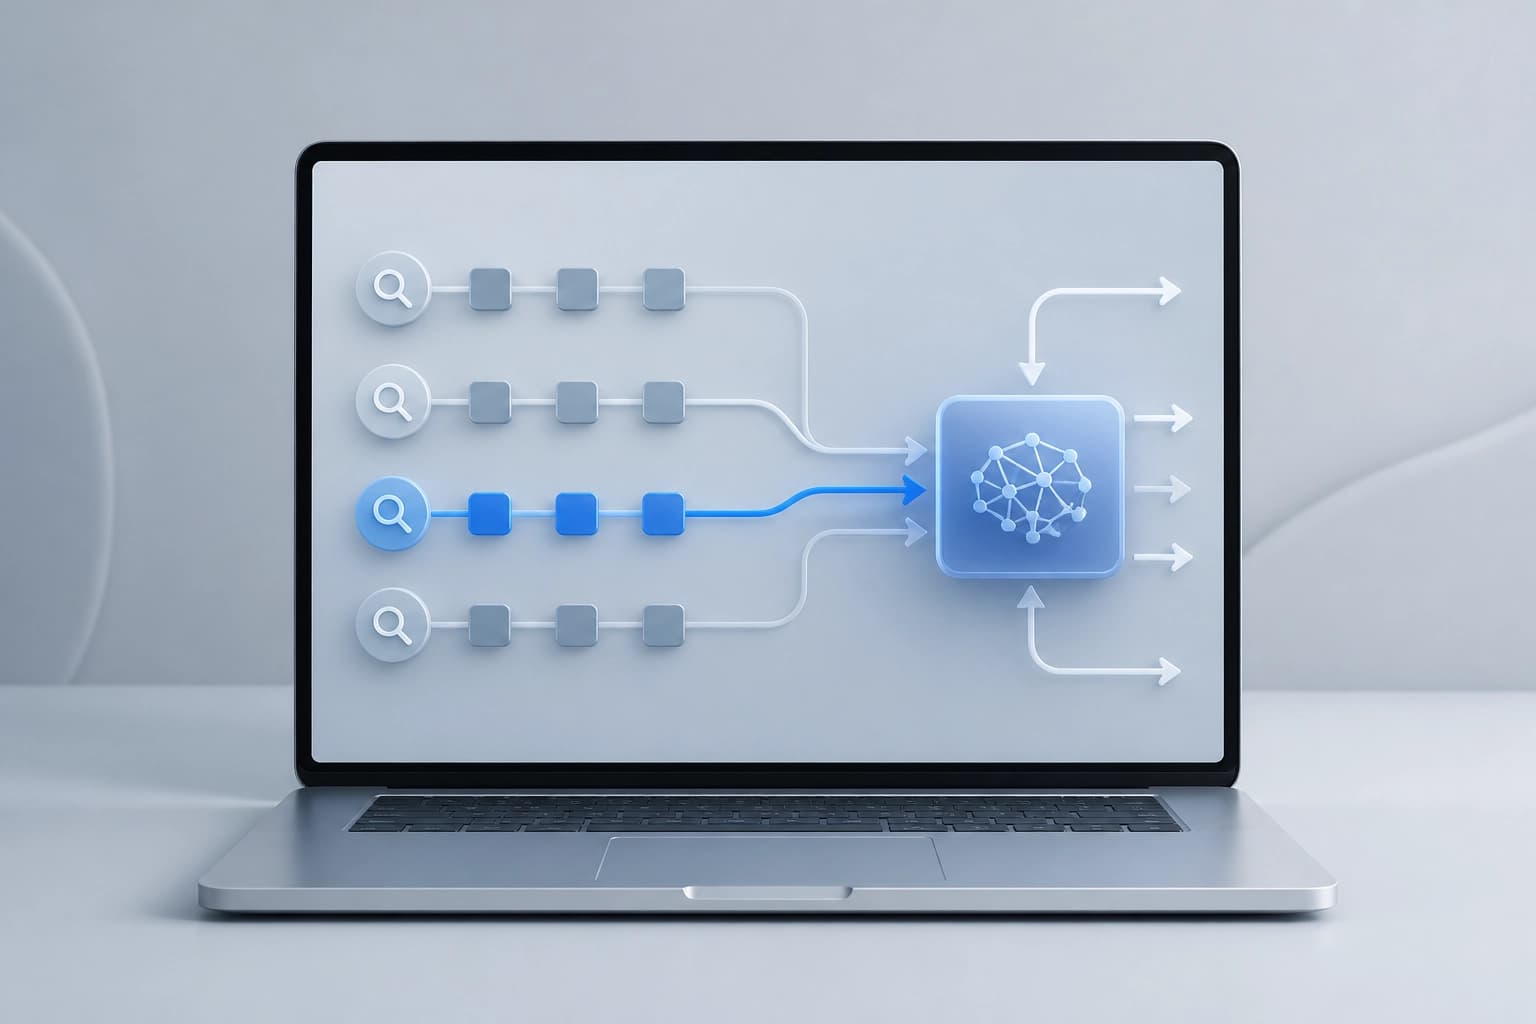
Dalam SpecEvo, prosesnya mengandalkan model berbiaya rendah untuk menangani pencarian rutin dan perangkuman bukti. Model canggih digunakan untuk intervensi strategis. Manfaatnya berdampak pada banyak evaluasi berbiaya rendah berikutnya.
Tahapan:
- Model ringan menjalankan pencarian rutin untuk program kandidat.
- Advisor merangkum informasi yang terkumpul mengenai keberhasilan, kegagalan, dan arah yang sudah jenuh.
- Navigator mempelajari populasi pada tahap pemeriksaan yang jarang dan memilih intervensi.
- Intervensi bergantung pada stagnasi pencarian dan dapat berupa sintesis, penyempurnaan terarah, atau perubahan kerangka.
- Model berbiaya rendah melanjutkan evaluasi dengan mempertimbangkan rekomendasi tetap.
Kriteria praktis: skema ini sesuai jika pencarian memungkinkan titik pemeriksaan yang jarang dan pengumpulan rekomendasi di antaranya.
Hasil dan perbandingan dengan metode dasar
Para penulis menguji SpecEvo pada 176 tugas di empat bidang penemuan ilmiah dan algoritmik. Kerangka kerja ini menunjukkan hasil yang setara atau lebih baik dibandingkan metode dasar berbasis model canggih. Pada saat yang sama, kerangka ini mengurangi biaya API hingga 80%. Dalam pencarian persamaan, kerangka ini menunjukkan efisiensi evaluasi hingga 1,5× lebih tinggi daripada metode dasar yang hemat biaya. Kerangka ini mengungguli metode dasar terkuat, CO-Bench, sebesar 3,8%.
| Metrik | Hasil | | Perbandingan dengan metode dasar berbasis model canggih | setara atau lebih baik | | Pengurangan biaya API | hingga 80% | | Efisiensi evaluasi dalam pencarian persamaan | hingga 1,5× lebih tinggi daripada metode dasar yang hemat biaya | | Keunggulan atas CO-Bench | 3,8% |
Kriteria praktis untuk memilih: bandingkan kualitas pencarian dan biaya API dengan metode dasar pada tugas Anda sendiri. Para penulis menyimpulkan bahwa koordinasi model yang mempertimbangkan lintasan pencarian merupakan pendekatan yang efektif untuk penemuan ilmiah yang hemat biaya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan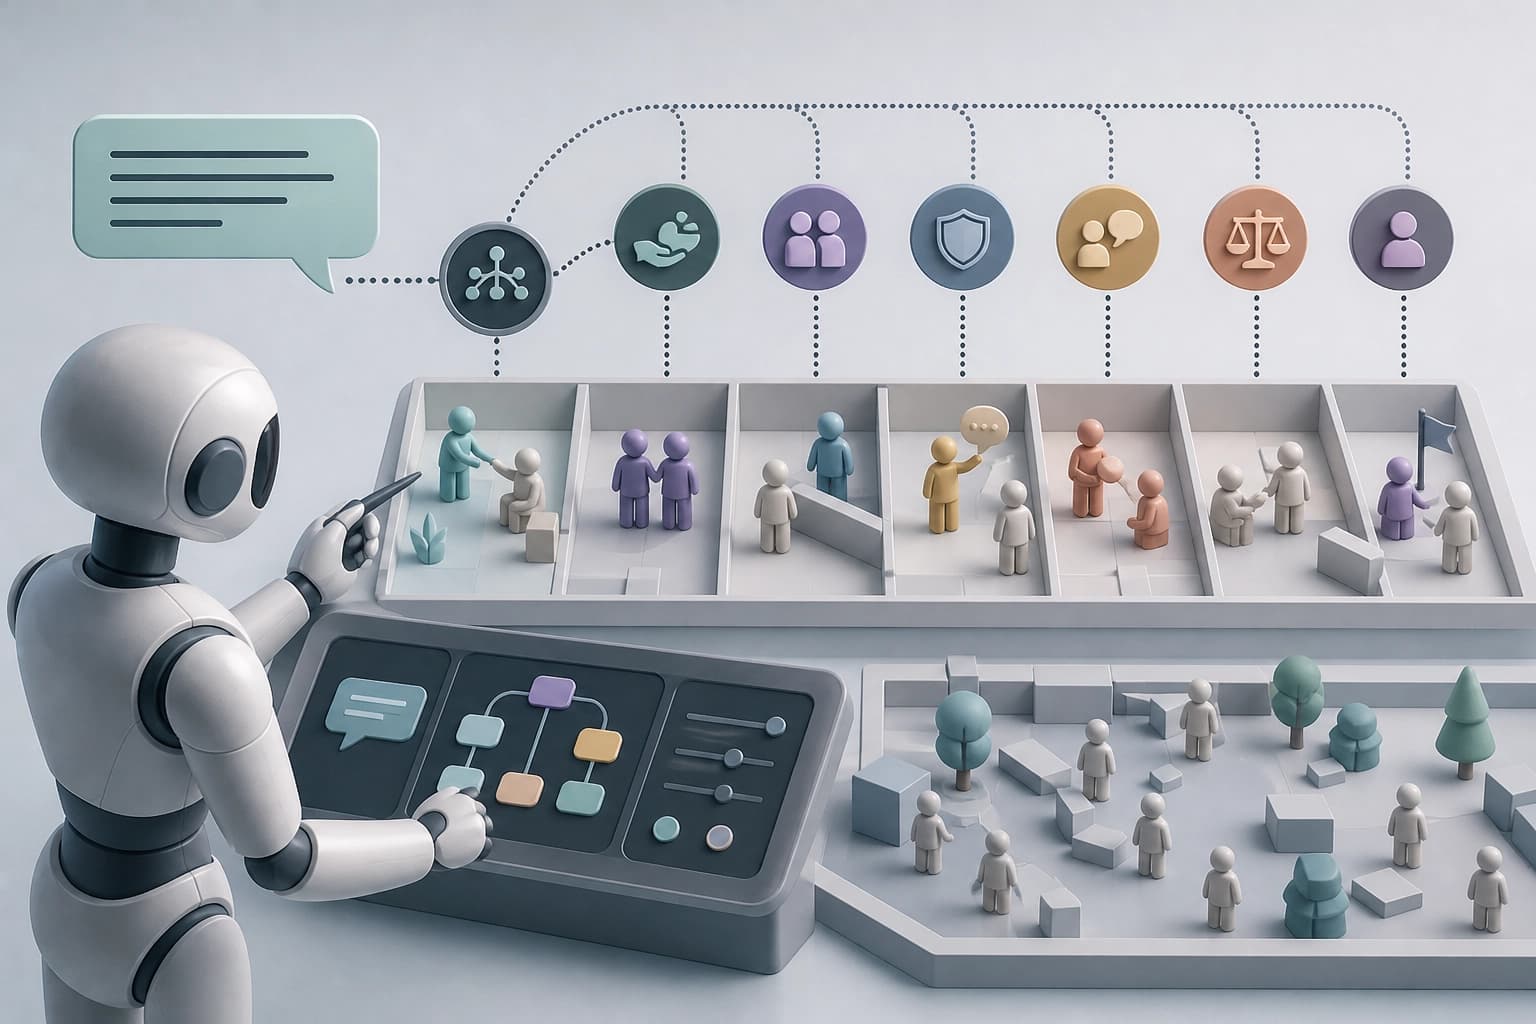
Fig: intervensi permainan terkontrol untuk menguji perilaku sosial agen AI
Fig menerima deskripsi verbal tentang perilaku yang dicari, membaginya menjadi beberapa jenis, lalu mengubah kondisi permainan secara terarah untuk memicu tindakan yang diinginkan dari model. Dalam skenario valid untuk enam pola sosial, intervensi meningkatkan rata-rata proporsi upaya melakukan perilaku sasaran sebesar 10,9% dibandingkan kontrol, dan para penulis mengusulkan agar lingkungan multiagen dipandang sebagai sarana uji yang dapat dikonfigurasi untuk evaluasi yang dapat direproduksi.
21 November 2026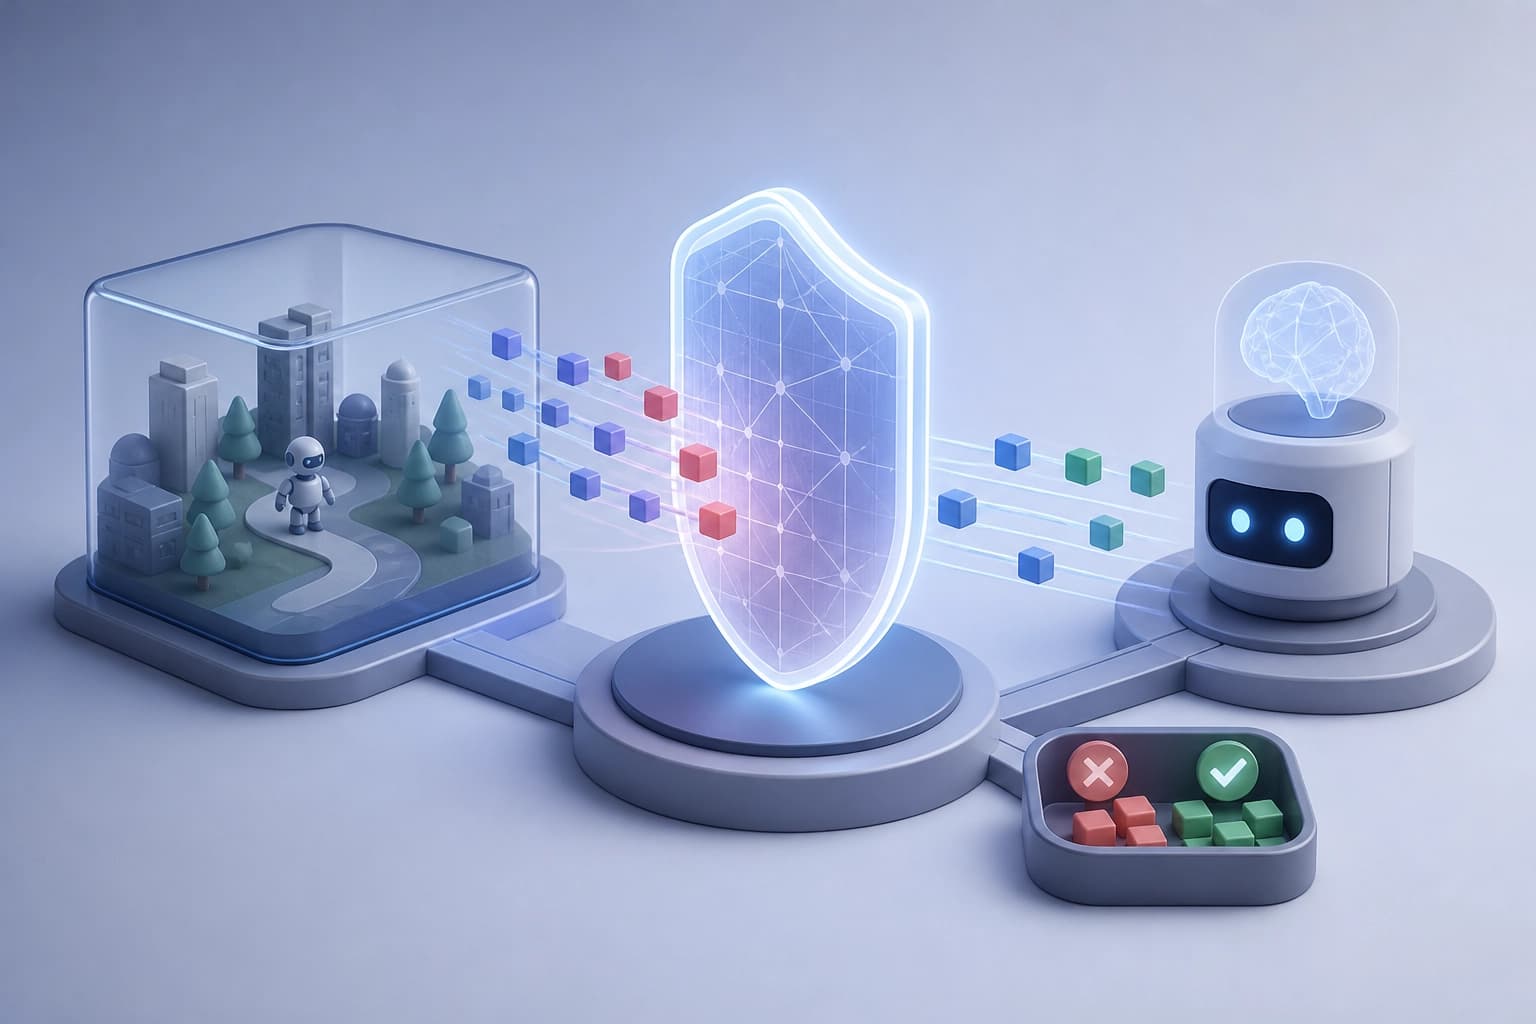
Pengujian kebijakan agen tanpa bergantung pada prompt: lingkungan eksekusi, kumpulan pengujian, dan filter yang dapat dilatih
Karya ini menawarkan kerangka kerja yang mengubah lingkungan eksekusi menjadi serangkaian skenario untuk menguji kebijakan agen dan memungkinkan komponen perlindungan ditingkatkan secara iteratif. Filter yang dilatih mengurangi tingkat pelanggaran yang berhasil sebesar 40–44% dibandingkan dengan hanya mengandalkan instruksi dalam prompt, dan lebih jarang keliru menolak permintaan yang aman.
20 November 2026
PerMIT: integritas memori jangka panjang agen LLM dan kepercayaan kolektif yang dapat diverifikasi mesin
Penulis mengusulkan arsitektur PerMIT yang membatasi masuknya data tak tepercaya dari lingkungan ke tindakan sensitif agen melalui antarmuka memori yang terbatas; dua teorema yang diverifikasi dengan Lean 4 dan akumulasi putusan komunitas mengurangi risiko peracunan tanpa menambah beban bagi pengguna individu. Dalam eksperimen pada Trojan Hippo dan τ²-bench, skema ini tidak mencatat injeksi yang berhasil dengan verifikator ringan dan meningkatkan hasil agen baru pada tugas yang ditunda.
20 November 2026