
Pengujian kebijakan agen tanpa bergantung pada prompt: lingkungan eksekusi, kumpulan pengujian, dan filter yang dapat dilatih
Karya ini menawarkan kerangka kerja yang mengubah lingkungan eksekusi menjadi serangkaian skenario untuk menguji kebijakan agen dan memungkinkan komponen perlindungan ditingkatkan secara iteratif. Filter yang dilatih mengurangi tingkat pelanggaran yang berhasil sebesar 40–44% dibandingkan dengan hanya mengandalkan instruksi dalam prompt, dan lebih jarang keliru menolak permintaan yang aman.
Batas prompt: mengapa instruksi saja tidak cukup
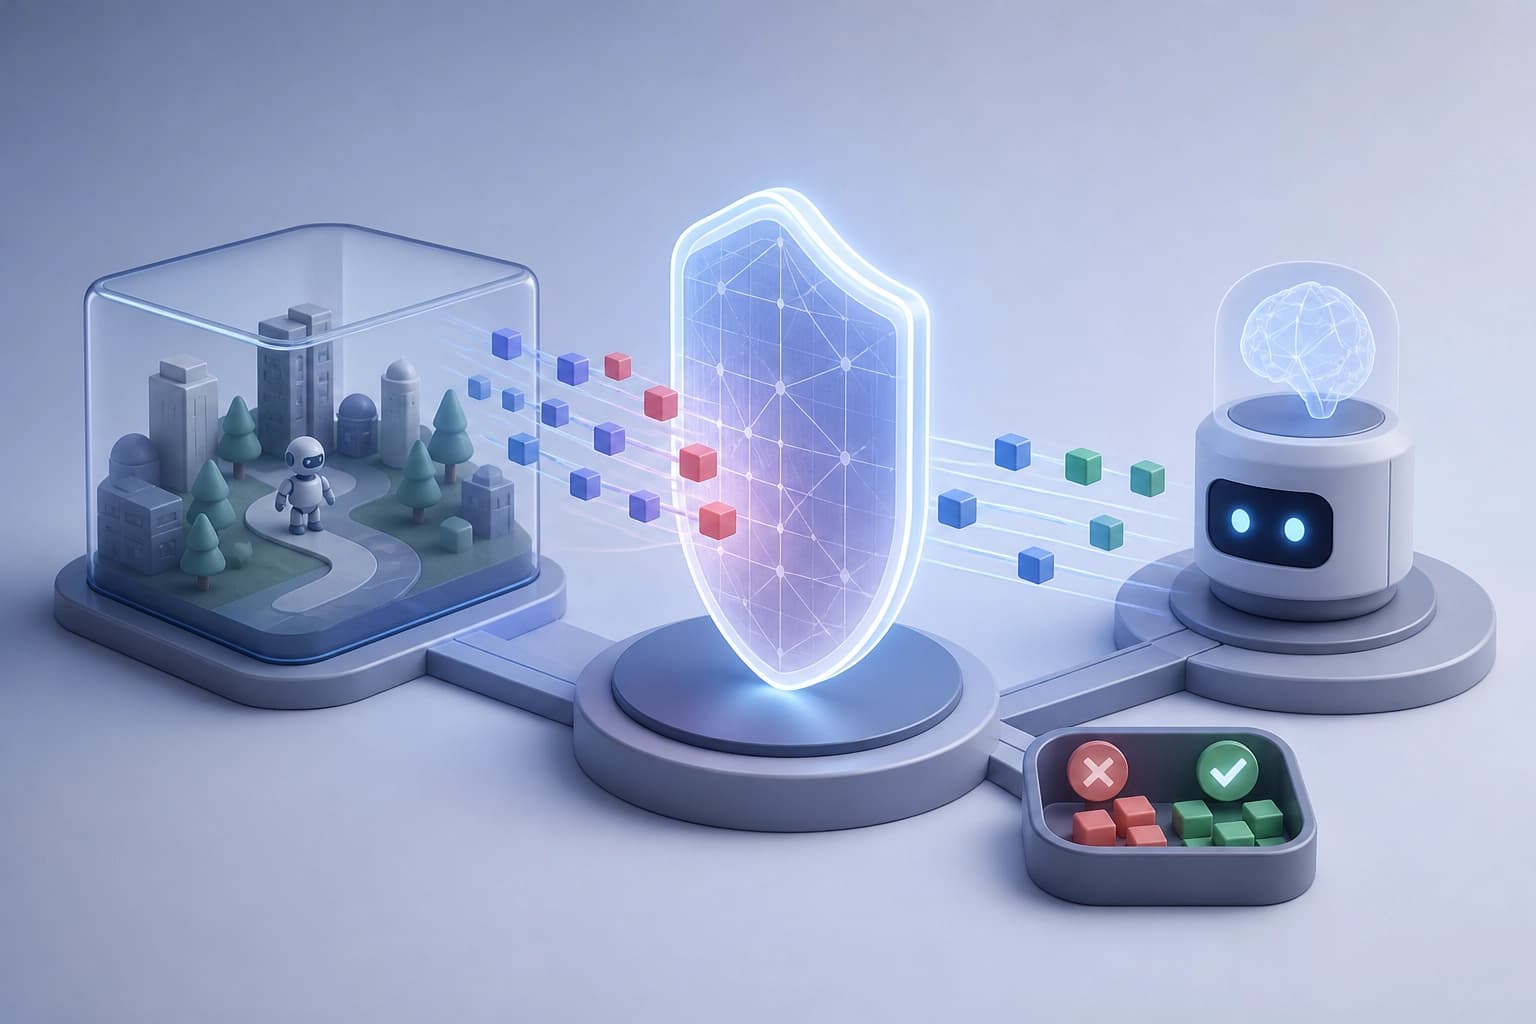
Dalam deployment agen khusus, kebijakan menetapkan aturan untuk alat, sumber daya, dan kondisi eksekusi. Memasukkan aturan ini ke dalam prompt tidak menjamin pencegahan pelanggaran yang andal. Prompt menetapkan teks, tetapi tidak memeriksa pemanggilan yang sebenarnya. Dalam semua kasus pelanggaran, alat yang diizinkan tetap digunakan. Artinya, yang perlu diperiksa adalah argumen, sumber daya, dan konteks, bukan hanya nama alat.
Untuk melatih mekanisme pengaman, diperlukan contoh pemanggilan yang mematuhi kebijakan dan yang melanggarnya. Tanpa pasangan semacam itu, pemeriksaan hanya mengandalkan teks aturan, bukan perilaku yang teramati.
Kriteria praktis: perlakukan prompt hanya sebagai pembawa aturan. Bangun pemeriksaan berdasarkan data pemanggilan dan hasilnya.
Lingkungan eksekusi: pemeriksaan berdasarkan pemanggilan yang sebenarnya
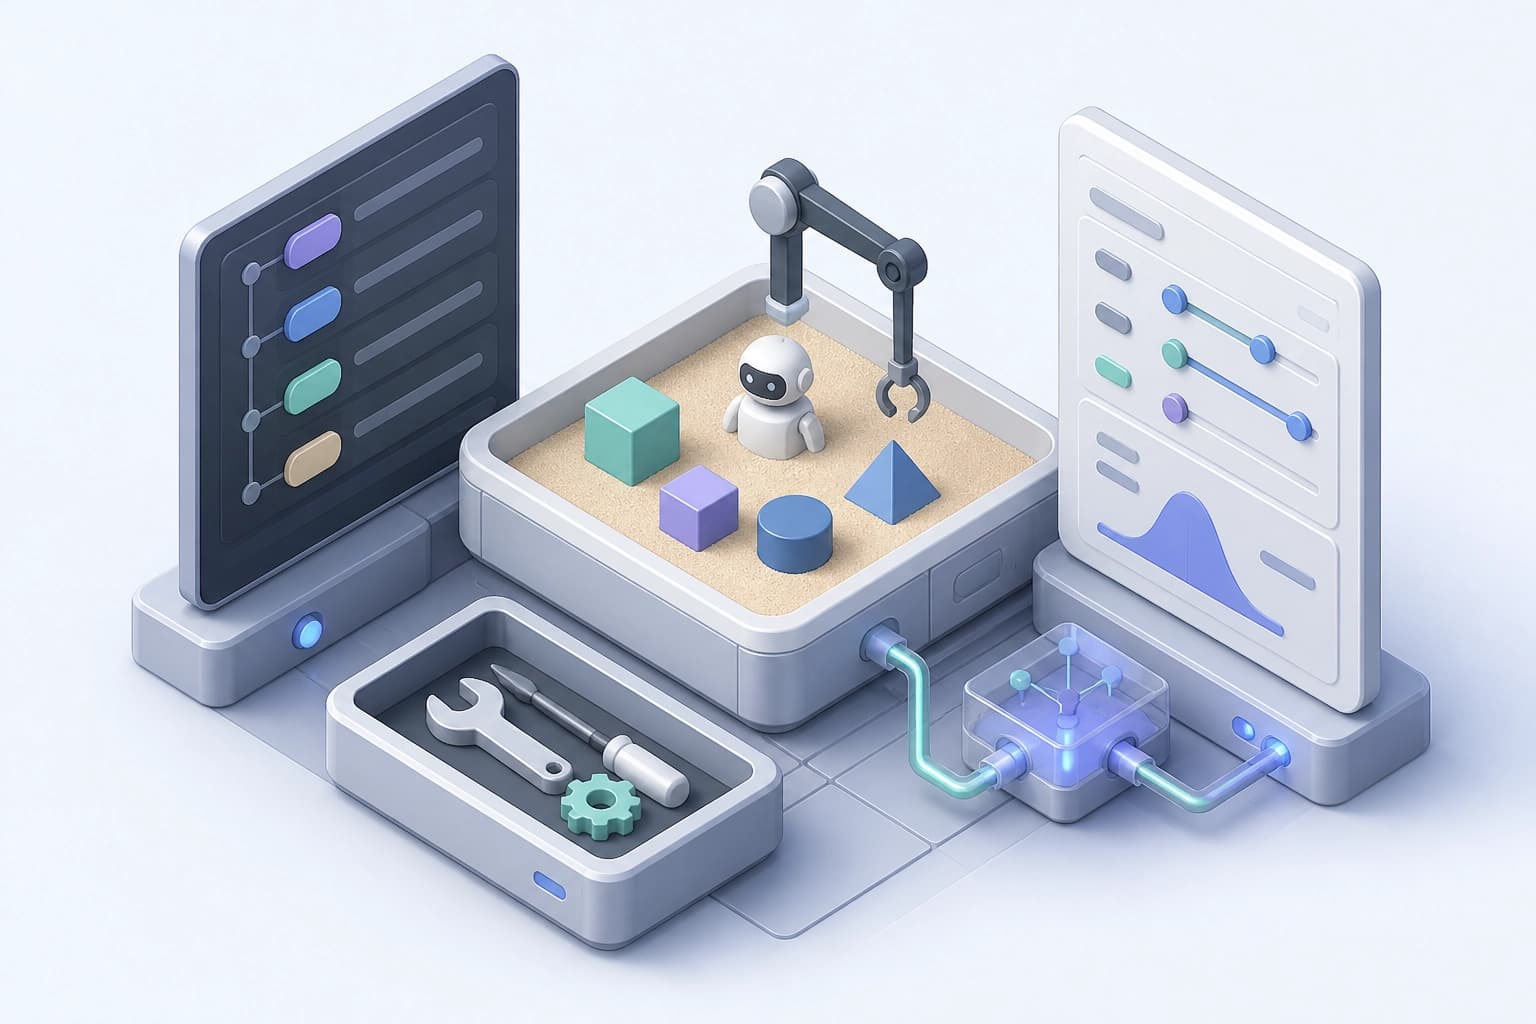
AgentPolicyForge menggunakan lingkungan eksekusi untuk membuat pengujian kebijakan acuan dan melatih mekanisme pengaman secara iteratif. Lingkungan tersebut menjalankan pemanggilan alat dan mencatat hasilnya. Kepatuhan terhadap kebijakan ditentukan berdasarkan hasil tersebut. Ini berbeda dari membaca prompt: pemeriksaan dilakukan berdasarkan eksekusi yang sebenarnya.
Elemen utama pemeriksaan:
- menjalankan pemanggilan di lingkungan;
- mencatat hasil pemanggilan;
- mencocokkan argumen, sumber daya, dan konteks dengan kebijakan;
- menggunakan alat yang diizinkan dalam contoh pelanggaran.
Kesimpulan: pengujian acuan harus dapat dieksekusi. Kriteria pemilihan lingkungan adalah kemampuan untuk menyimpan hasil dan memeriksa argumen, sumber daya, serta konteks.
PolicyGym: skenario pelatihan dan pengujian tertunda
Berdasarkan kerangka kerja ini, dibuat PolicyGym — kumpulan data yang mencakup sepuluh keluarga kebijakan. Kumpulan ini mencakup 698 skenario untuk menghasilkan data pelatihan. Secara terpisah, tersedia 254 skenario tertunda untuk set pengujian.
| Bagian kumpulan | Tujuan | Jumlah |
|---|---|---|
| Skenario untuk menghasilkan data pelatihan | Menyiapkan contoh pelatihan | 698 |
| Skenario tertunda | Set pengujian | 254 |
Skenario tertunda telah ditinjau oleh manusia. Kriteria praktis: pisahkan skenario pelatihan dan skenario tertunda. Set pengujian harus terpisah dari proses pembuatan data pelatihan.
Filter terlatih dibandingkan pengaturan diri agen
Di PolicyGym, dua pendekatan dibandingkan: pengaturan diri agen berdasarkan kebijakan dan mekanisme pengaman terlatih. Konfigurasi akhir dengan mekanisme pengaman menghasilkan penurunan relatif tingkat keberhasilan serangan sebesar 40–44%. Konfigurasi ini juga menghasilkan lebih sedikit penolakan keliru terhadap permintaan yang tidak berbahaya dibandingkan dengan hanya menerapkan kebijakan dalam prompt.
| Konfigurasi | Yang digunakan | Hasil berdasarkan fakta |
|---|---|---|
| Hanya kebijakan dalam prompt | Teks kebijakan | Dasar perbandingan |
| Konfigurasi akhir dengan mekanisme pengaman | Filter terlatih | Penurunan serangan yang berhasil sebesar 40–44%; lebih sedikit penolakan keliru |
Kriteria praktis: bandingkan mekanisme pengaman dengan dasar prompt. Amati sekaligus serangan yang berhasil dan penolakan keliru.
Siklus iteratif: serangan, pelatihan lanjutan, pembaruan arsip
Proses pembuatan contoh mendukung pelatihan mekanisme pengaman secara iteratif. Penyerang menghasilkan permintaan dengan menggunakan strategi yang telah diekstrak. Mekanisme pengaman menjalani pelatihan lanjutan dengan contoh seimbang yang telah diperiksa di lingkungan. Pelatihan meningkatkan efektivitas penerapan kebijakan, bahkan dengan arsip yang tetap.
Pembaruan arsip memberikan dampak tambahan. Pembaruan ini mengurangi keberhasilan serangan dalam domain dibandingkan dengan membiarkan arsip tetap tanpa perubahan.
Tahapan siklus:
- Ekstrak strategi serangan.
- Buat permintaan dari penyerang.
- Periksa contoh di lingkungan eksekusi.
- Seimbangkan contoh dan lakukan pelatihan lanjutan pada mekanisme pengaman.
- Perbarui arsip serangan.
Kriteria praktis: masukkan siklus pembaruan arsip dan pemeriksaan contoh di lingkungan. Arsip tetap sudah memberikan dampak pelatihan. Pembaruan menambahkan penurunan keberhasilan serangan dalam domain.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
PerMIT: integritas memori jangka panjang agen LLM dan kepercayaan kolektif yang dapat diverifikasi mesin
Penulis mengusulkan arsitektur PerMIT yang membatasi masuknya data tak tepercaya dari lingkungan ke tindakan sensitif agen melalui antarmuka memori yang terbatas; dua teorema yang diverifikasi dengan Lean 4 dan akumulasi putusan komunitas mengurangi risiko peracunan tanpa menambah beban bagi pengguna individu. Dalam eksperimen pada Trojan Hippo dan τ²-bench, skema ini tidak mencatat injeksi yang berhasil dengan verifikator ringan dan meningkatkan hasil agen baru pada tugas yang ditunda.
20 November 2026
Sistem AI multiagen komposit dengan siklus evidensi untuk perencanaan proton pada tumor kepala dan leher
Karya ini menguraikan integrasi kebijakan PPO terlatih yang menghasilkan beberapa opsi rencana dengan agen LLM yang melakukan klarifikasi melalui dialog, disertai pemeriksaan metrik klinis dan batasan; berdasarkan data dari 21 pasien, Qwen3-14B yang telah disesuaikan lebih baik dalam mengikuti instruksi dan membantu menggeser kompromi agar lebih mengutamakan tujuan prioritas. Kesimpulan praktisnya: perencanaan DRL otomatis dapat dilengkapi dengan dialog terarah, sambil tetap mempertahankan kendali atas batasan-batasan yang saling bersaing.
20 November 2026
Seleksi komputasional alih-alih coba-coba empiris: pendekatan baru untuk material baterai
Materi ini menunjukkan bagaimana basis data komputasi, machine learning, dan model generatif mempersempit pilihan komposisi yang menjanjikan, sementara laboratorium otomatis mempercepat pengujiannya; hasil akhirnya tetap bergantung pada sintesis dan pengujian, karena prediksi dapat berbeda dari konduktivitas yang sebenarnya.
20 November 2026